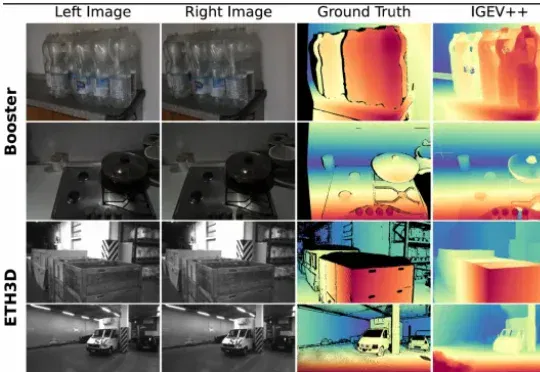
ECCV 2026 | 悉尼大学提出Linstereo, 打通立体匹配「最后一公里」(在新窗口打开)
LinStereo 对应地做了三件事:PALA 换掉 ConvGRU 解决传播问题,HSCV 保留多尺度特征,DPI 用单目深度给一个靠谱的起点。PALA 做的事情说起来很直观,就是把 ConvGRU 的局部更新换成全局注意力,让每个像素每次迭代都能看到整张图。难点在于 softmax attention 是 O (N²) 的,直接用在高分辨率视差图上跑不动。
共 34 篇
LinStereo 对应地做了三件事:PALA 换掉 ConvGRU 解决传播问题,HSCV 保留多尺度特征,DPI 用单目深度给一个靠谱的起点。PALA 做的事情说起来很直观,就是把 ConvGRU 的局部更新换成全局注意力,让每个像素每次迭代都能看到整张图。难点在于 softmax attention 是 O (N²) 的,直接用在高分辨率视差图上跑不动。
来自上海交大、马来亚大学、CMU、MBZUAI、KIT和KAUST的团队提出VisNec(Visual Necessity Score,视觉必要性分数),用一个分数衡量每条训练样本里“图像到底起了多大作用”,被ECCV 2026收录。
依赖于有限机器人数据和大量人类数据,也能让 VLA 模型更稳健吗?
AI 正从看懂画面,走向理解空间、预测变化、执行动作。
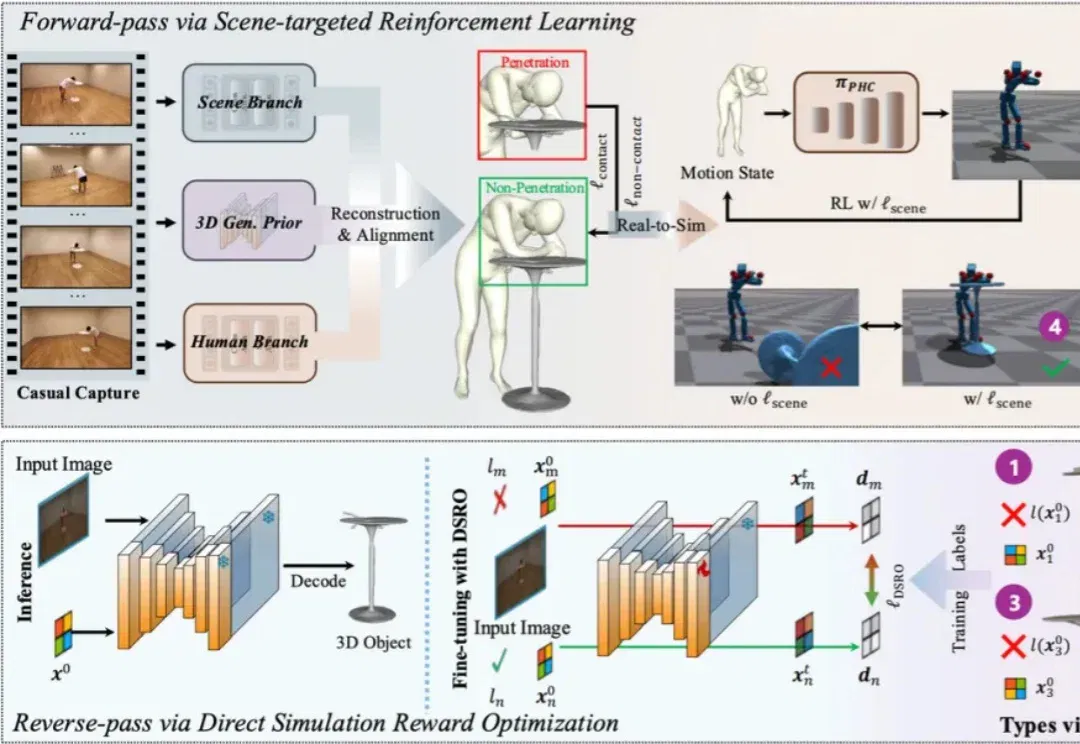
一段人坐上椅子的视频,对人类而言再普通不过。我们不仅能看见 “人坐了下来”,还天然理解椅子承受人体重量,人与椅面形成接触并最终稳定,这些重力、接触与作用关系共同构成真实世界中的物理交互。但对今天的三维重建系统而言,“看见动作” 与 “重建真实交互” 仍是两回事。一个视觉上准确坐在椅子上的人体,进入物理仿真后,椅子可能因结构缺失倒下,人体也可能与椅面严重穿模。视觉上成立,并不意味着物理交互上成立。
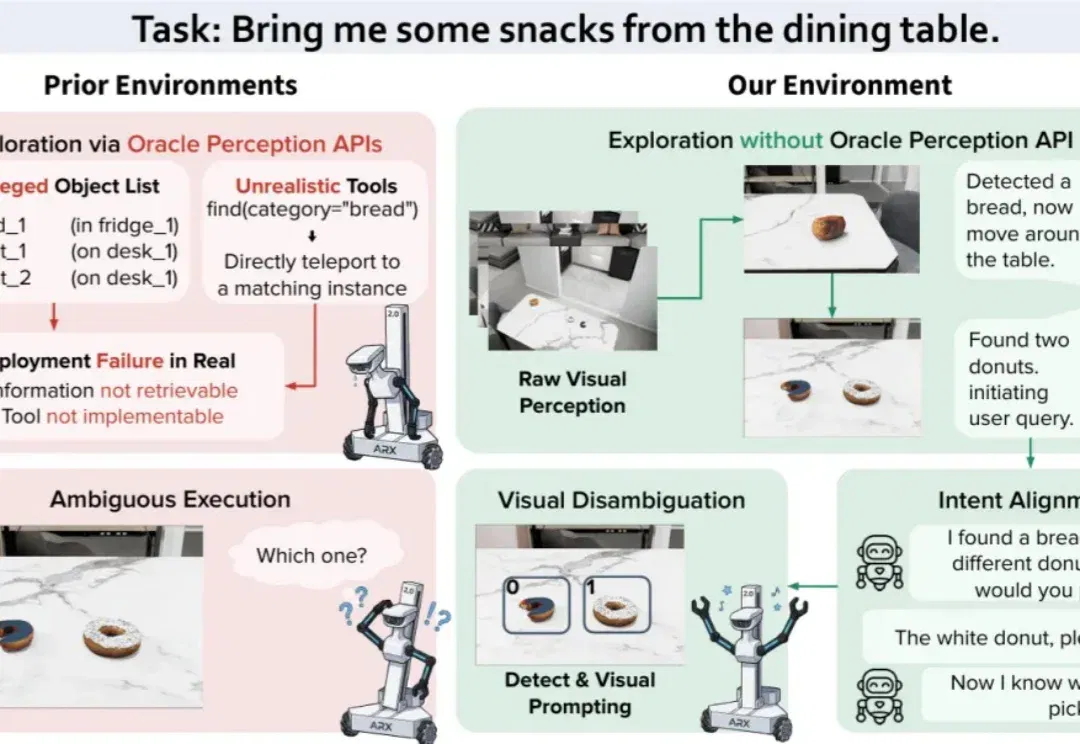
真实家庭任务往往从「不完整的信息」开始:机器人不知道目标在哪里,用户也未必能一次说清自己想要什么。面对「帮我从餐桌上拿点零食」这样的模糊指令,机器人不仅要主动寻找候选物体,还要在发现面包和多个甜甜圈后进一步询问用户,确认究竟该拿哪一个。
给生成模型引入仿真,补上难以获得的声音感知。

近年来,视觉语言模型(Vision-Language Model, VLM)在图像理解、语义推理等任务中展现出了强大的能力。然而,当这些模型真正进入物理世界,让机器人根据一句自然语言指令完成自主导航时,仍然面临巨大挑战。
去哪训练、拿什么学、怎么考?这是物理AI从实验室走向现实世界的三个核心问题,现在有了系统性答案。
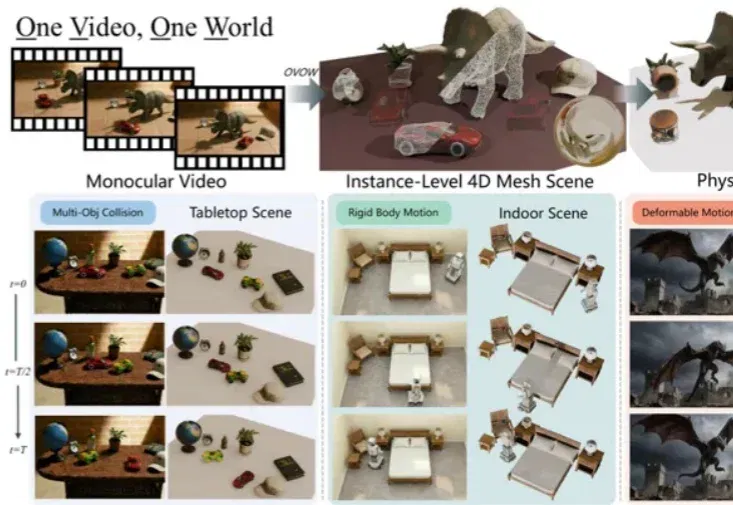
机器人走出实验室后,训练数据不再只是 “多不多” 的问题:环境能否覆盖真实世界的尺度、遮挡、接触和运动,直接决定策略能否落地。Real2Sim 因此重新受到关注 —— 如果普通视频也能变成可交互的仿真场景,采集成本会比人工建模或专用设备低得多。