MiniMax H3 团队 Reddit 上回应一切:2K 要开源,图像模型在路上,Apache 2.0 也在考虑了(在新窗口打开)
8 月 7 日晚上 10 点,MiniMax H3 团队来到 Reddit 的 r/StableDiffusion 社区举行 AMA(Ask Me Anything)。参与此次交流的包括 H3 研究负责人 dacongya,研究员 Luigi、Nero、Kiro,系统工程师 Reynor,以及 MiniMax 开发者关系负责人 Ryanlee。
共 96 篇
8 月 7 日晚上 10 点,MiniMax H3 团队来到 Reddit 的 r/StableDiffusion 社区举行 AMA(Ask Me Anything)。参与此次交流的包括 H3 研究负责人 dacongya,研究员 Luigi、Nero、Kiro,系统工程师 Reynor,以及 MiniMax 开发者关系负责人 Ryanlee。
莫理这两天在 GitHub 上淘到了一个开源的实用工具,刚好能把这块短板给彻底补齐!这就是咱们今天的主角:Edit Banana,通用内容再编辑器。
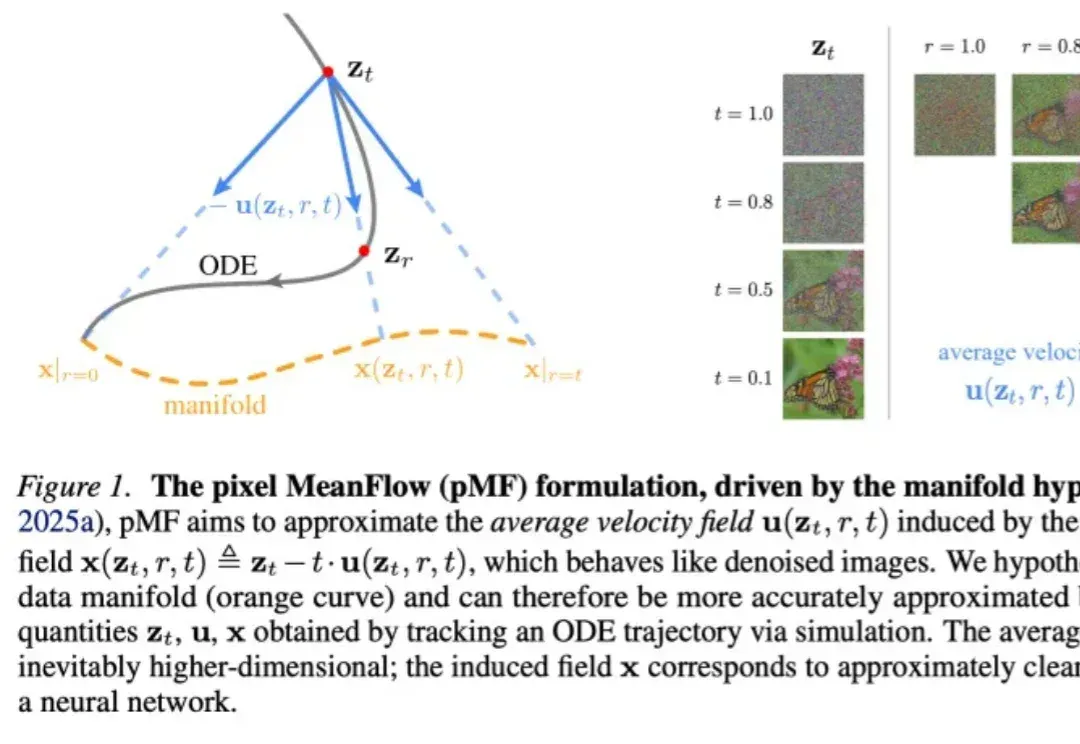
何恺明团队新论文,再次「大道至简」。 此次研究直指当前以 DiT 为代表的主流扩散模型与流匹配模型存在的通病,并提出了一种用于单步、无潜空间(Latent-free)的图像生成新框架。 论文标题:One-step Latent-free Image Generation with Pixel Mean FlowsarXiv 地址:https://arxiv.org/pdf/2601.22158v1 在生成式 AI 领域,追求更高效、更直接的生成范式一直是学界的核心目标。 当前,以 DiT 为代表的主流扩散模型与流匹配模型主要依赖两大支柱来降低生成难度,一是通过多步采样将复杂的分布转换分解为微小
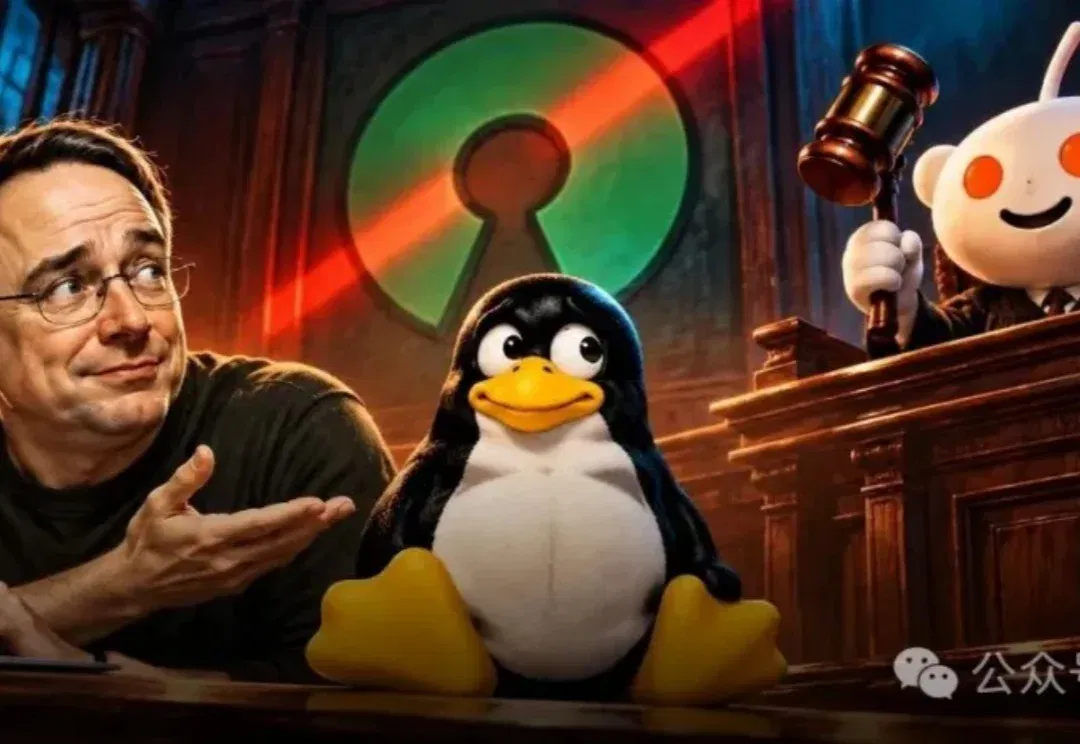
开源界刚刚发生了一件魔幻到离谱的大事。 Reddit最大开源社区r/opensource,一纸禁令甩了出来—— 从今天起,全面封杀任何使用AI、由AI生成或专门面向AI的项目! 版主u/Wolvereness在置顶长文中态度强硬,原话写道:只要你的项目用了AI、由AI编写,或者目标是服务于AI,那么r/opensource就绝不欢迎你。 帖子一出,瞬间引爆了全网围观,评论区彻底炸开了锅。 很快有人发现了一个致命的逻辑漏洞,按这条规矩,人类史上最伟大的开源项目Linux,已经被「开除」了。 Linux之父早都上手用Claude Code,辅助写Linux代码了。 一个以「开放、自由」为信仰的社区
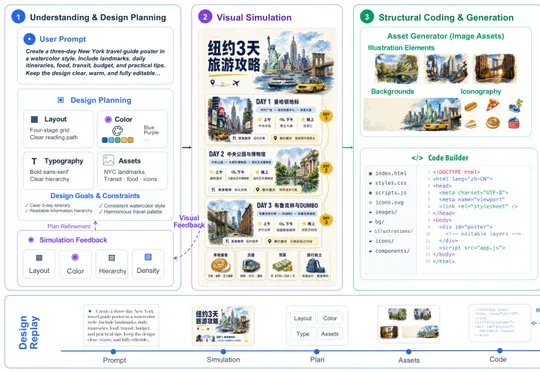
开源项目 Editable Design 结合视觉模型、HTML 代码与持续工作的 Agent,将 AI 生图重构为可编辑的设计文件,使文字可直接修改、图层可独立拖动,仓库展示了 14 组覆盖营销海报、信息设计等 6 类视觉任务的案例。
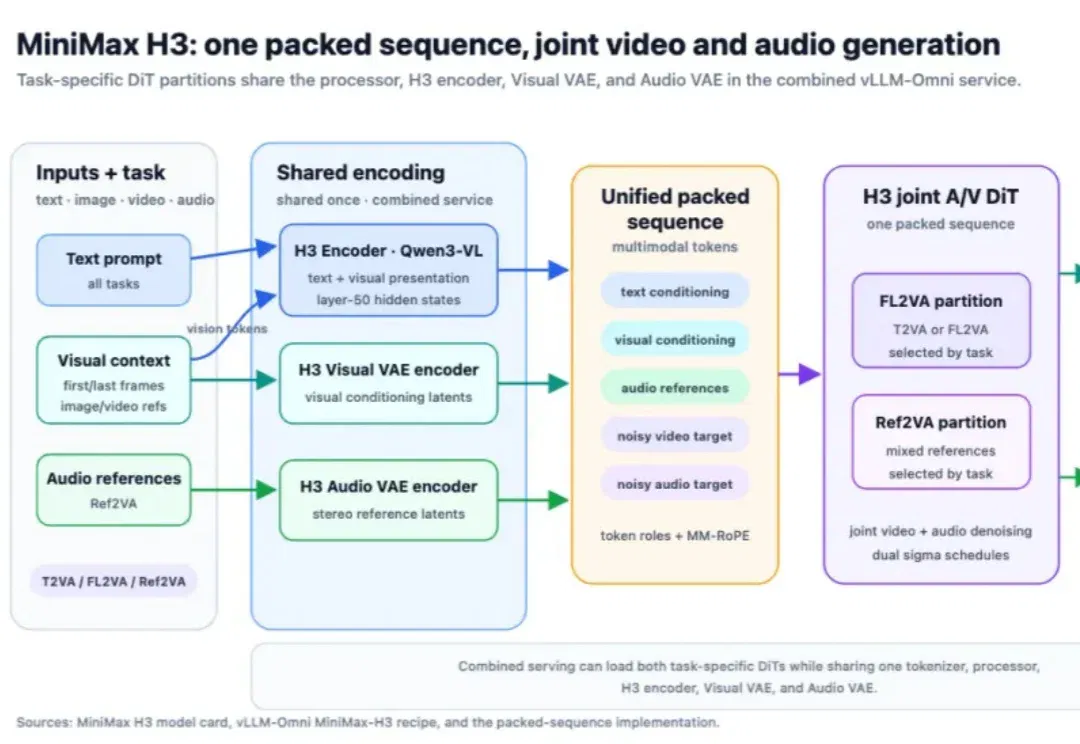
MiniMax H3 的服务是一个系统问题。一个请求要经过一个庞大的 Qwen3-VL 编码器、一个长序列的音视频 DiT、相互独立的视频与音频 VAE、设备与进程的边界,最后还要完成 H.264/AAC 的封装。只优化 DiT,其余环节的时延依然留在那里。
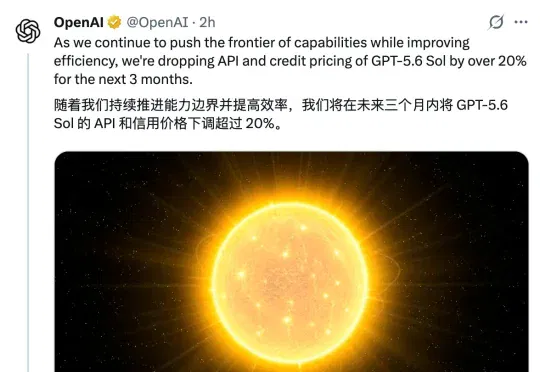
突发,GPT-5.6 Sol 开启大幅降价!未来三个月,API 价格和 credit 价格(超出计划包含额度后的按需付费用量)一起砍掉超过20%。目前,API 端已经即时生效,符合条件的 ChatGPT Work 和 Codex credits 正在陆续推送。
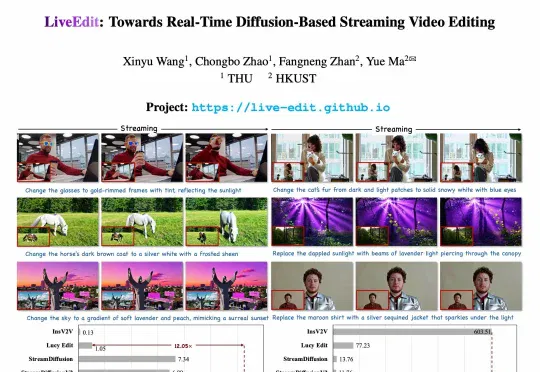
近日,清华大学与香港科技大学的研究团队提出 LiveEdit,一种面向通用文本指令的实时流式视频编辑框架。该方法以因果、分块的方式处理持续到来的视频,在 4 步 / 视频块的推理条件下实现 12.66 FPS 的流式编辑,并能保持被编辑区域的准确性以及未编辑区域的一致性。
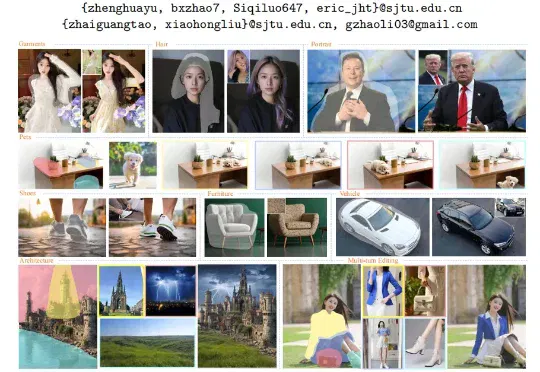
上海交通大学联合上海创智学院团队提出 A²-Edit,它以统一框架支持任意物体类别和任意精度掩码,通过混合 Transformer 专家路由、掩码退火训练及 50 万级多品类数据,让用户只需给出粗略区域,也能完成身份一致、结构完整、自然融合的参考图引导局部编辑。
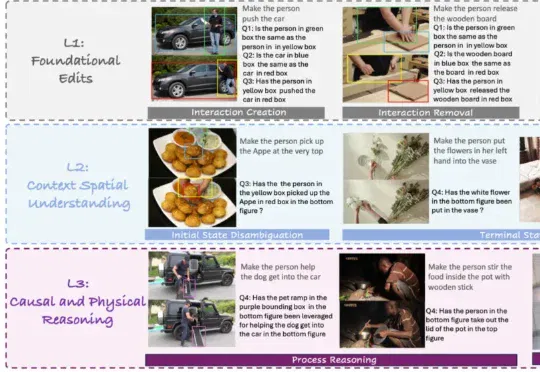
本文发现图生视频(I2V)模型天然适合重构动态交互过程,并提出 SCPE(Self-Correcting Process Editing) 多智能体系统自纠错框架:利用视频生成过程暴露失败原因,再通过分析、反思和工具书更新迭代增强提示,使 I2V 模型在复杂 HOI 编辑中显著提升交互准确性与推理能力。