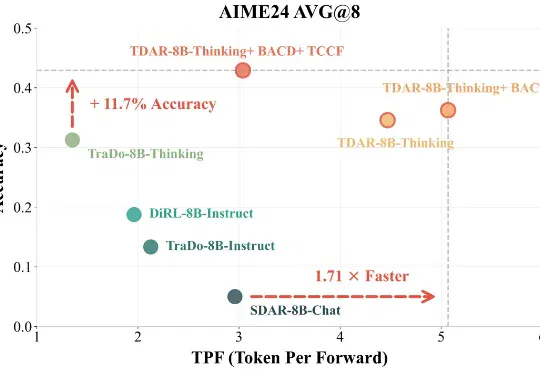
复旦北大联合美团LongCat提出TDAR:用“粗思考,细求证”破解Block Diffusion的速度精度悖论(在新窗口打开)
近期,复旦大学 NLP 实验室(FDU NLP)、北京大学知识计算实验室(KCL)联合美团 LongCat Team 提出了一种 Block Diffusion 推理模型 Test-Time Scaling 新框架 TDAR,通过引入 “粗思考,细求证” (Think Coarse Critic Fine, TCCF) 范式与有界自适应置信度解码
共 76 篇
近期,复旦大学 NLP 实验室(FDU NLP)、北京大学知识计算实验室(KCL)联合美团 LongCat Team 提出了一种 Block Diffusion 推理模型 Test-Time Scaling 新框架 TDAR,通过引入 “粗思考,细求证” (Think Coarse Critic Fine, TCCF) 范式与有界自适应置信度解码
近日,专注低功耗AI模型的初创公司Flourish Inc. 完成5亿美元融资。本次融资由GV、Lux Capital、Catalio Capital Management等知名投资机构及杰夫·贝索斯参与投资。本轮融资亦是2026年6月初全球规模最大的融资轮次之一。
Mirage(原 Captions)宣布获得 7500 万美元 融资,由 General Catalyst 旗下 Customer Value Fund(CVF)提供。这类资金的逻辑,与传统 VC 明显不同,它更关注已经被验证的增长模型与单位经济,而不是单纯押注未来。
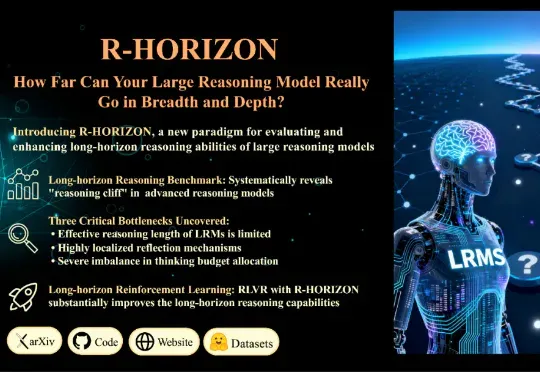
当前的训练与评测范式存在一个根本性的局限:几乎所有主流 Benchmark(如 MATH500、AIME)都聚焦于孤立的单步问题,问题之间相互独立,模型只需「回答一个问题,然后结束」。但真实世界的推理场景往往截然不同: 为填补这一空白,复旦大学与美团 LongCat Team 联合推出 R-HORIZON—— 首个系统性评估与增强 LRMs 长链推理能力的方法与基准。
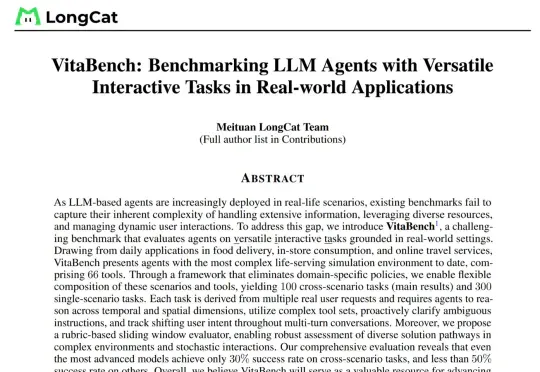
美团LongCat团队发布了当前高度贴近真实生活场景、面向复杂问题的大模型智能体评测基准——VitaBench(Versatile Interactive Tasks Benchmark)。VitaBench以外卖点餐、餐厅就餐、旅游出行三大高频生活场景为典型载体,构建了一个包含66个工具的交互式评测环境,并设计了跨场景综合任务。
来源体验Loopcat的对白与动作输入、视频回合、剧情分支和角色创作,并介绍Kaon团队的产品背景。用户规模与模型接入情况为报道口径,互动视频仍需保持多轮连续性。
美团开放 LongCat-2.5 及 W4A4 量化权重,提供国产算力部署说明。智东西记录了 OpenCode 平台用量,并比较官方评测和调用价格。
01Founder 用 Lobe Bench Hard50 评测 LongCat-2.5。默认设置有 22 道任务三次均通过,推理模式增加到 26 道,平均耗时也随之上升。
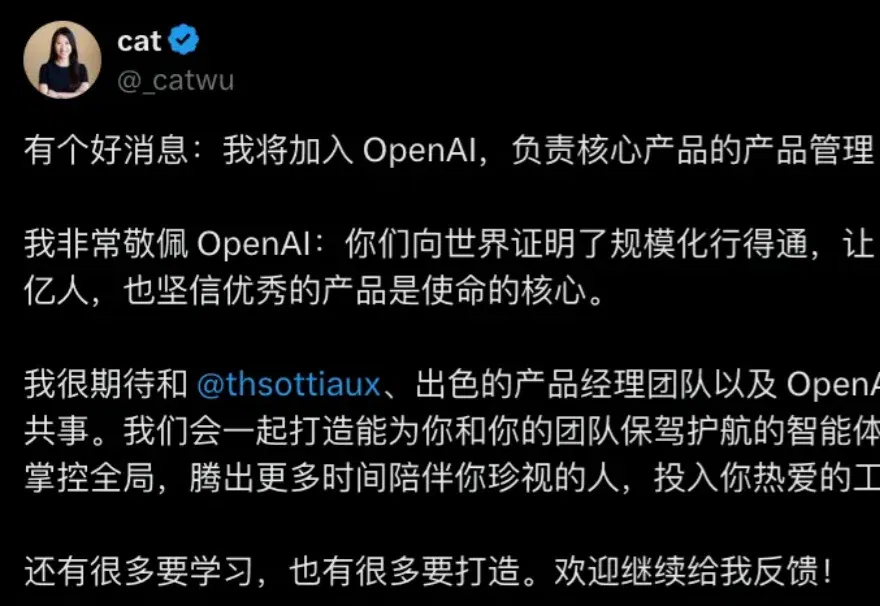
据报道,Cat Wu离开Anthropic后宣布加入OpenAI,参与核心产品管理。文章回顾她在Claude Code及Cowork的工作,并讨论团队人员流动;Anthropic公司收入增长不能全部归于单一产品,也不能从离职直接推断内部矛盾。
LongCat-2.5 总参数量1.6万亿、每token激活约480亿,结合离散视觉token与长程智能体训练。团队报告多项基准和国产加速器训练优化;原作者体验也指出3D细节和PPT排版不足。不同基准有领先与落后,不能概括为全面超过海外模型。