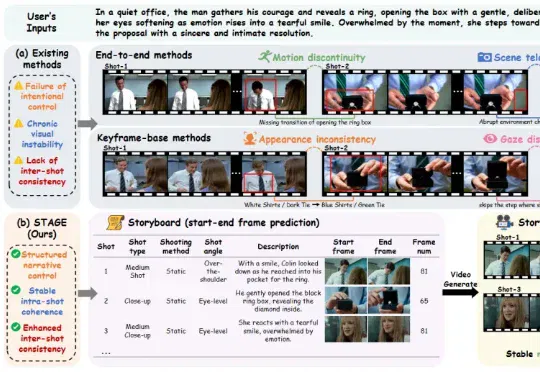
CVPR 2026 | 从「单帧」到「分镜」:STAGE重新定义AI电影叙事(在新窗口打开)
目前,该论文已录用至 CVPR 2026,相关数据集和模型训练训练和推理代码将逐步开源:究其原因,一个好故事并非一堆漂亮镜头的简单拼接,而是一个有结构、有逻辑的叙事整体。
共 62 篇
目前,该论文已录用至 CVPR 2026,相关数据集和模型训练训练和推理代码将逐步开源:究其原因,一个好故事并非一堆漂亮镜头的简单拼接,而是一个有结构、有逻辑的叙事整体。
本文是北京大学彭宇新教授团队在文本生成视频领域的最新研究成果,相关论文已被 CVPR 2026 接收。
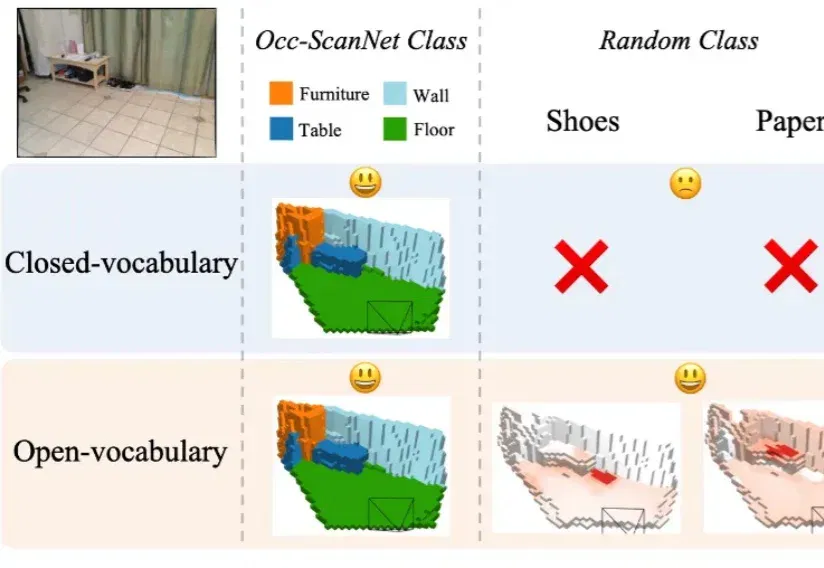
在具身智能研究中,如何让智能体精准理解周围环境的精细几何结构与开放语义信息,始终是具身感知的核心难题。近年来,语义占据预测(Semantic Occupancy Prediction) 将稠密几何与语义信息统一到三维体素网格中,用于构建 3D 语义占据地图,为机器人的空间推理、导航与交互操作提供了场景表达基础。
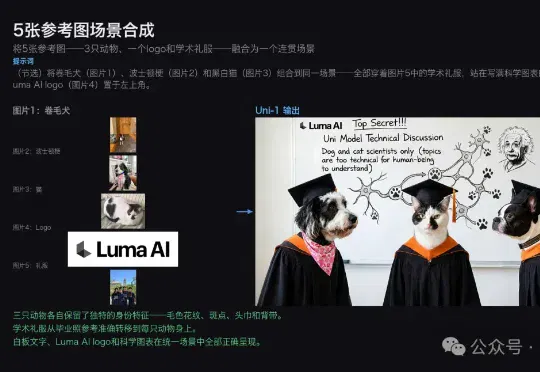
刚刚,Luma AI甩出全新模型Uni-1,正面对标谷歌Nano Banana Pro和GPT Image 1.5。Uni-1是一个统一的图像理解与生成模型。在官方展示中,Uni-1具备角色姿态迁移、故事板生成、草稿+材质结合参考生成、草稿转漫画、多参考图场景合成、草稿引导的照片编辑、UV贴图生成、带有文字的贺卡海报生成等诸多能力。
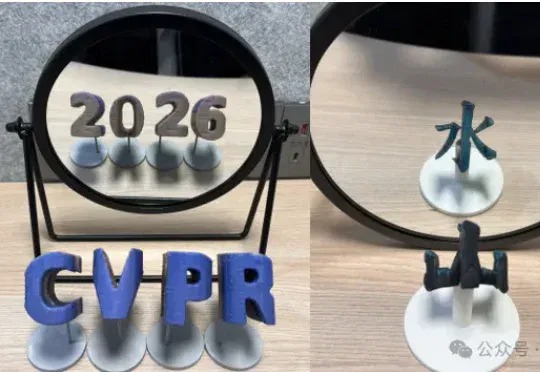
近日,来自清华大学等单位的研究团队提出了AutoMIA,一种自动生成镜像错觉艺术的 AI 设计方法,用户仅需任意指定两张图片,分别对应镜子前和镜子中的图案,AutoMIA就可以自动完成3维艺术品的设计,并且支持直接3D打印出来制作艺术品。
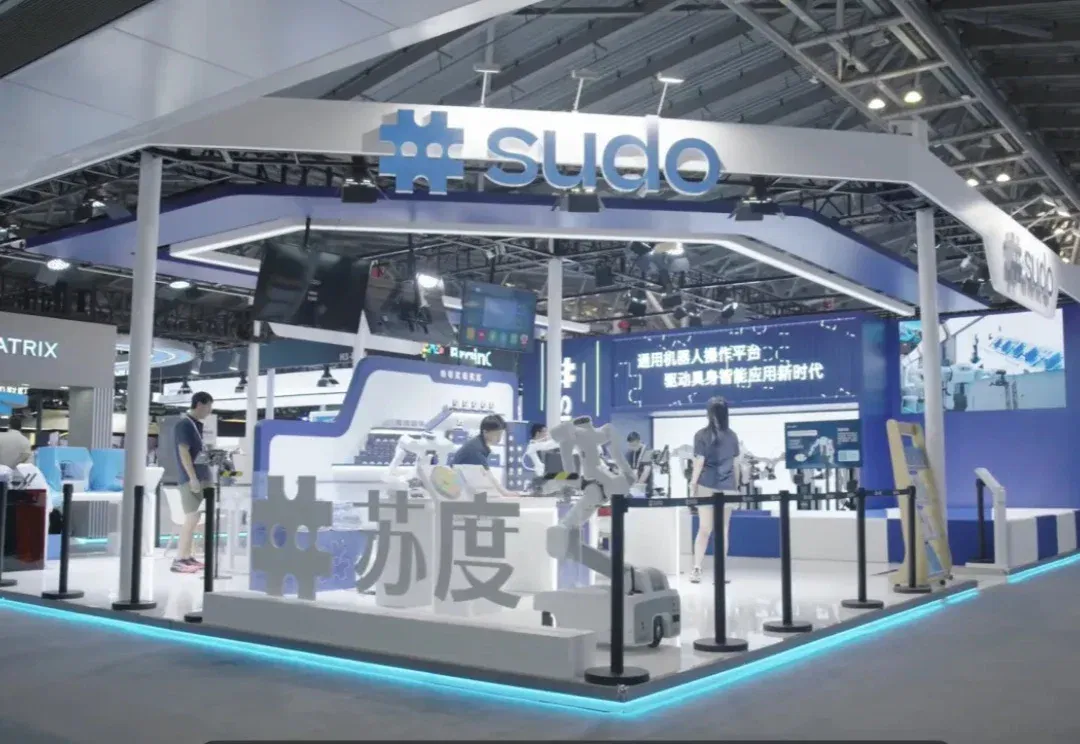
一个月前的CVPR现场,一家中国具身智能公司的展台被围得水泄不通。
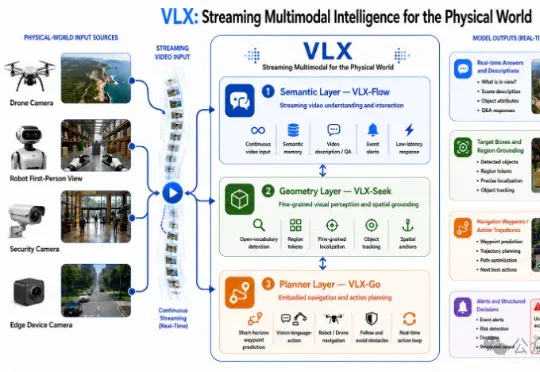
刚刚,Om AI发布全球首个面向物理世界的端侧流式多模态模型系列——VLX。VLX主打真实世界的端侧与具身场景,总共三款模型,三天连发:这三款模型连起来,不仅构成了多模态模型持续感知、精准定位、行动决策的能力闭环。
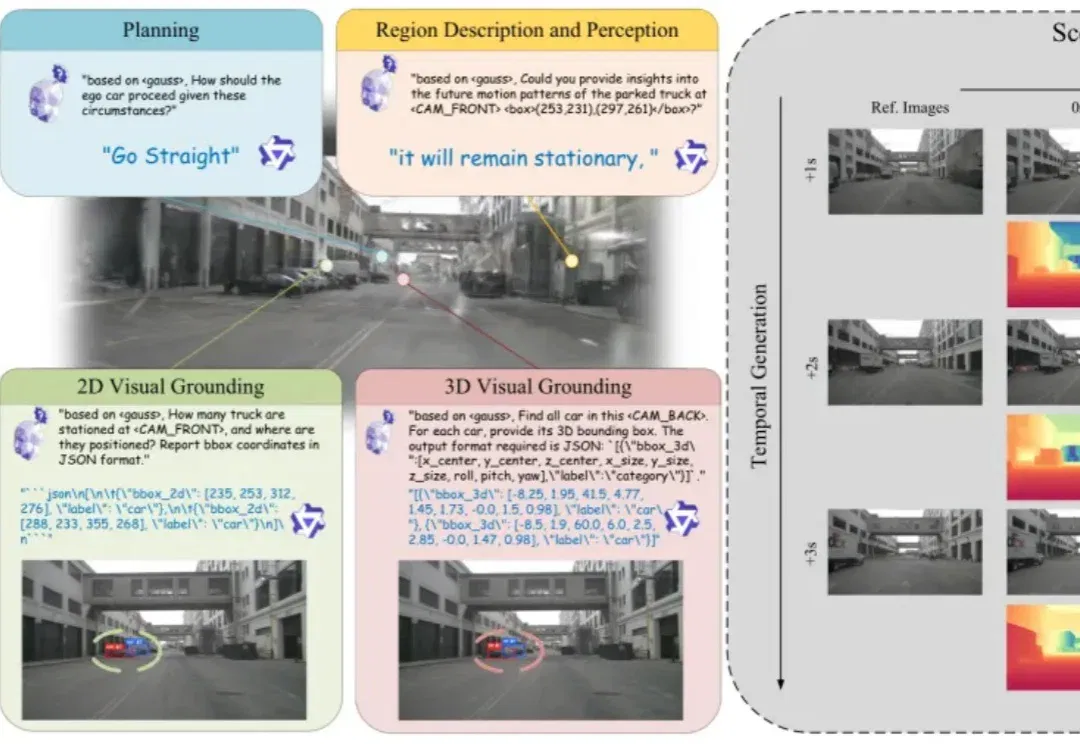
自动驾驶世界模型的研究目标已经从单纯预测未来视觉帧,扩展到构建可用于场景理解、空间定位和后续决策的世界表示。如果模型只能生成外观上合理的未来图像,却无法回答场景中有哪些目标、目标位于何处,以及不同视角下的空间结构如何变化,那么它仍然缺少对三维驾驶环境的显式建模能力。
在南加州大学,王越的 PSI Lab(Physical Superintelligence Lab)是过去两三年里具身智能方向上升最快的年轻团队之一。
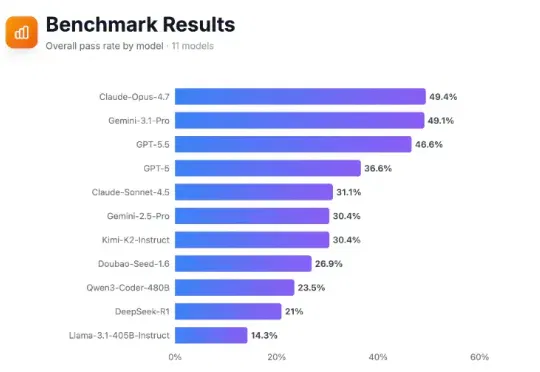
近日,来自清华大学智能产业研究院(AIR)的团队联合北京智源研究院(BAAI)、北京大学、南京大学等机构构建了一个基准:GeoCodeBench。这是一个面向 3D 几何计算机视觉的 PhD 级 coding benchmark,