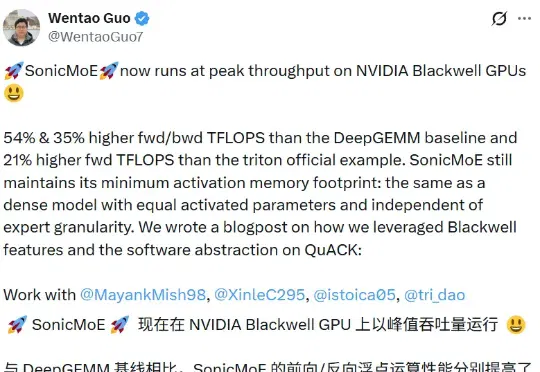
DeepSeek做大→Mega MoE,Tri Dao团队加快→SonicMoE(在新窗口打开)
近日,由普林斯顿大学 Tri Dao(FlashAttention 的一作)和加州大学伯克利分校 Ion Stoica 领导的一个联合研究团队也做出了一个超快的索尼克:SonicMoE。据介绍,SonicMoE 能在英伟达 Blackwell GPU 上以峰值吞吐量运行!并且运算性能超过了 DeepSeek 之前开源并引发巨大轰动的 DeepGEMM。
共 29 篇
近日,由普林斯顿大学 Tri Dao(FlashAttention 的一作)和加州大学伯克利分校 Ion Stoica 领导的一个联合研究团队也做出了一个超快的索尼克:SonicMoE。据介绍,SonicMoE 能在英伟达 Blackwell GPU 上以峰值吞吐量运行!并且运算性能超过了 DeepSeek 之前开源并引发巨大轰动的 DeepGEMM。
近日,AI编程智能体初创公司 Factory 完成1.5亿美元C轮融资,投后估值达到15亿美元,正式跻身独角兽行列。本轮由Khosla Ventures领投,Sequoia Capital、Blackstone、Insight Partners、Evantic Capital、20VC、NEA和Mantis VC参与跟投。
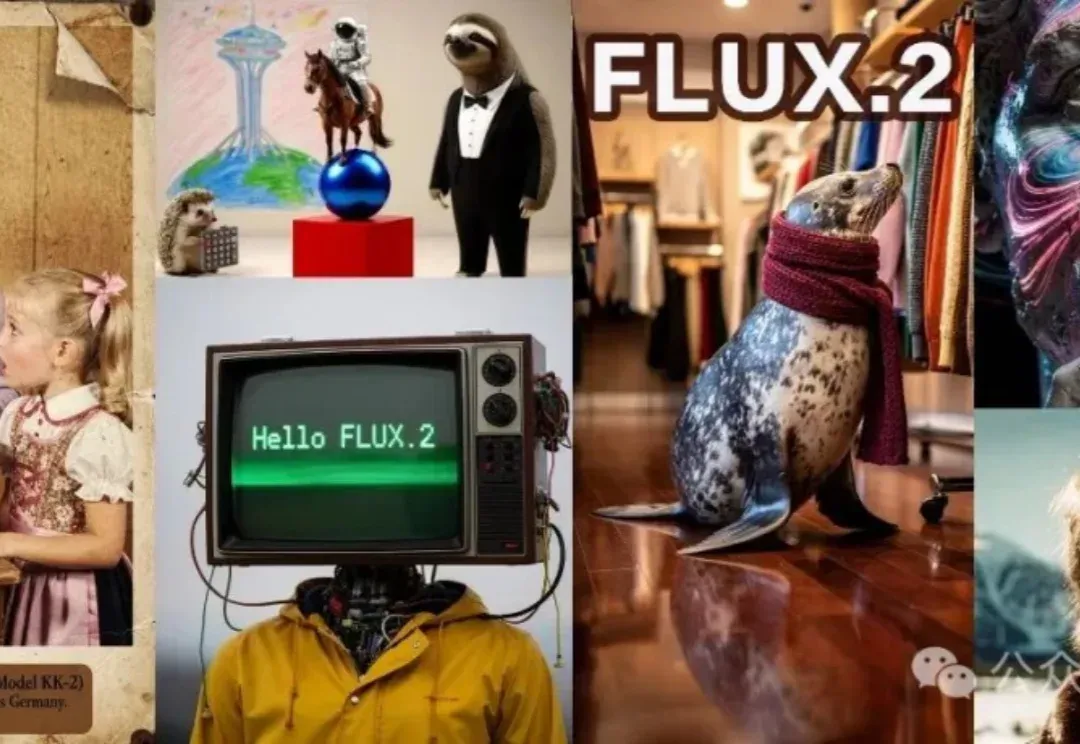
Black Forest Labs的开源视觉模型FLUX.2上新,这是一款专为现实创意工作流程打造,绝非演示噱头的生产力工具,与前代FLUX.1相比,实现了从「会画」到「懂你要画什么」的跃升。
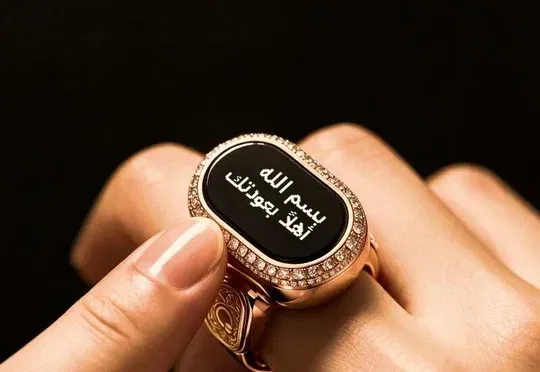
新款戒指采用触控计数、屏幕提示和礼拜提醒,配合应用整理念诵记录;报道提到的400万销量属于品牌累计产品。
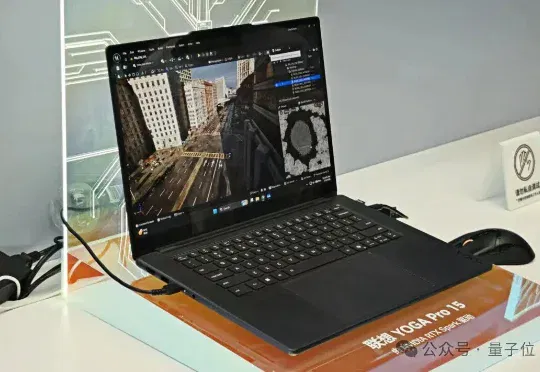
就在这届Bilibili World上,英伟达首次面向大众玩家展示了搭载RTX Spark超级芯片的笔记本电脑。这款芯片专为个人智能体打造,不仅搭载了Blackwell RTX GPU,连CPU也是出自英伟达的Grace CPU。
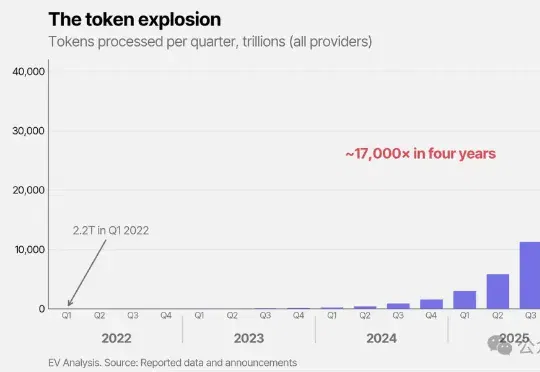
Epoch AI刚刚发布的《梯度更新》报告,做了一件简单粗暴的事:把全球所有Blackwell芯片能处理的Token数量算出来,再和实际需求一比。结论只有一个字——不够。
众所周知,大模型训练成本极高。 但大家又知道,降低训练精度能够显著降低训练成本。DeepSeek-V3 用 FP8 训练把成本打到了 560 万美元,已经让全行业侧目。 在 FP8 成功后,行业仍然在不断探索低精度的边界:从 FP8 降到 FP4,训练成本还能再降多少? 理论上,FP4 的计算吞吐可以是 FP8 的两倍。NVIDIA Blackwell 和 AMD MI350 系列都已经在硬件层面原生支持了 FP4 运算,前者在 B200 上标称 FP4 算力可达 4500 TOPS(稀疏)。硬件已经准备好了,但软件和算法那一侧,一直卡在一个问题上: 用 FP4 从头训练大模型,训练过程非常不
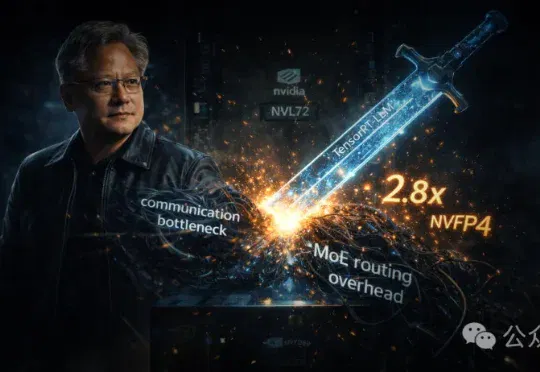
MoE模型的稀疏激活本是优势,却常陷通信瓶颈。NVIDIA以软件为利剑,通过程序化依赖启动和全对全通信革新,在三个月内将GB200的单GPU吞吐提升2.8倍,真正释放Blackwell硬件潜力。
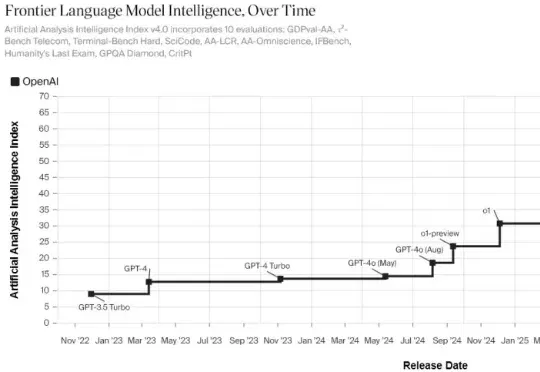
全球AI终局战,牌桌上只剩OpenAI和Anthropic了!现在,两家已经开启了指数级双雄争霸,GPT-5.5救了老黄,Blackwell重锤反击。面对30GW的算力对决和步骤坍塌,谁能拿稳AGI的头等舱门票?
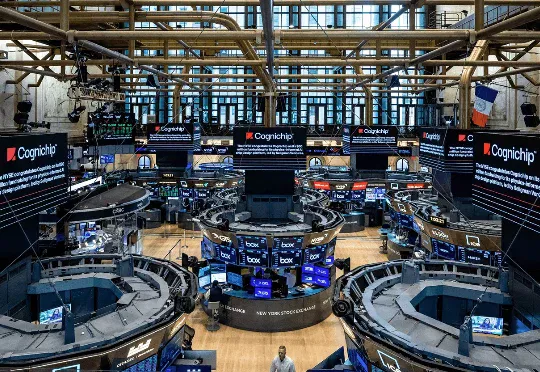
Cognichip正在构建一个深度学习模型,以便在工程师设计新计算机芯片的过程中为其提供协助。它试图解决的问题是该行业数十年来一直面临的一个难题:芯片设计极其复杂、成本高昂且速度缓慢。先进的芯片从概念设计到大规模生产需要三到五年的时间;仅设计阶段就可能长达两年。想想看,英伟达最新的 GPU 系列Blackwell就包含1040 亿个晶体管——要排列这么多晶体管可不是一件容易的事。