刚刚,Meta最强旗舰多项屠榜!智能水平仅落后Opus 5.5两分(在新窗口打开)
Meta发布新一代旗舰模型家族Muse Wonder,推出Muse Wonder和Muse Wonder Full,引入Active Memory与Active Focus,并在Agent、记忆及编程等关键评测中取得领先成绩。
共 68 篇
Meta发布新一代旗舰模型家族Muse Wonder,推出Muse Wonder和Muse Wonder Full,引入Active Memory与Active Focus,并在Agent、记忆及编程等关键评测中取得领先成绩。
十字路口团队内测体验Today AI一周,发现这款Personal AI助理能基于Memory积累和Proactive交互,主动帮创作者推进撰写稿件、整理采访提纲、安排日程等工作,并复盘邮箱、订阅与财务等生活事务,在GUI、Memory与Proactive之间找到了平衡。
本文综合北京大学王选计算机研究所发布的 ProactiveVideoQA 和 MMDuet2 两篇论文,介绍视频多模态大模型如何实现 “主动交互”—— 在视频播放过程中自主决定何时发起回复,而非等待用户提问。ProactiveVideoQA 提出评估指标和 benchmark,MMDuet2 则通过强化学习训练方法实现了 SOTA 性能,无需精确的回复时间标注即可训练出及时、准确的主动交互模型。
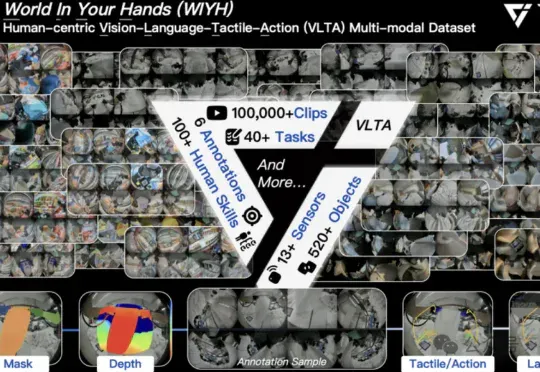
全球首个真实世界具身多模态数据集,它来了! 刚刚,它石智航发布全球首个大规模真实世界具身VLTA(Vision-Language-Tactile-Action)多模态数据集World In Your Hands(WIYH)。
近期Product Hunt热门AI产品Acti、Wispr Flow、Hey Noah、Pazi、Glaze、AnySearch、Context.dev和OpenSEO不再执着于打造更聪明的ChatGPT,而是分别争夺意图入口、任务执行权、软件生产成本降低以及面向Agent的基础设施,将AI嵌入键盘、语音、邮件等日常工作流程。
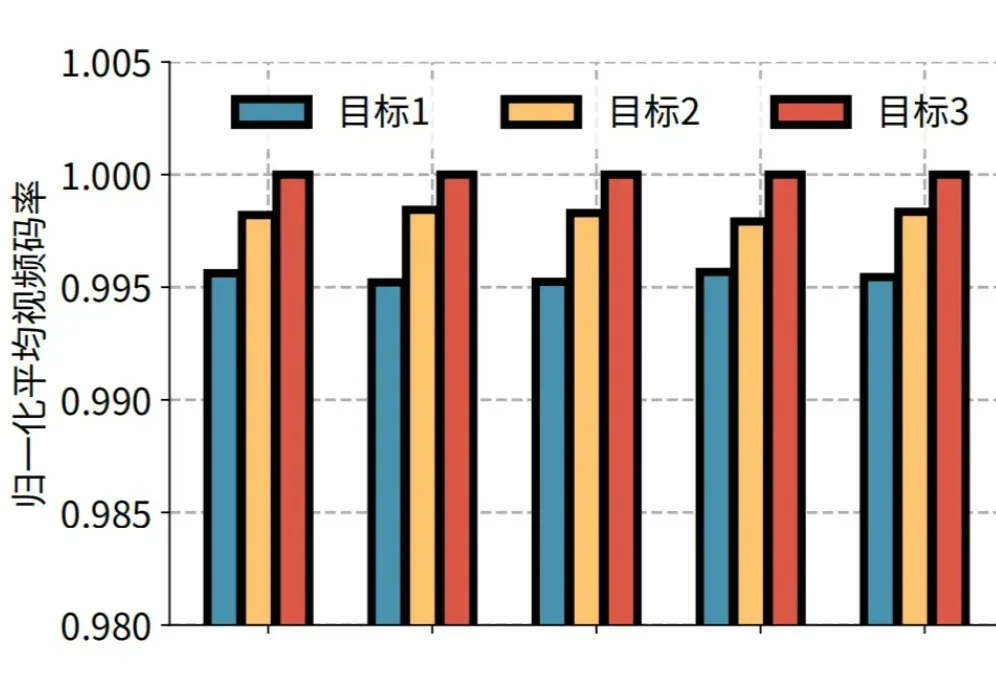
近日,快手与清华大学孙立峰团队联合发表论文《Towards User-level QoE: Large-scale Practice in Personalized Optimization of Adaptive Video Streaming》,被计算机网络领域的国际顶尖学术会议 ACM SIGCOMM 2025 录用。
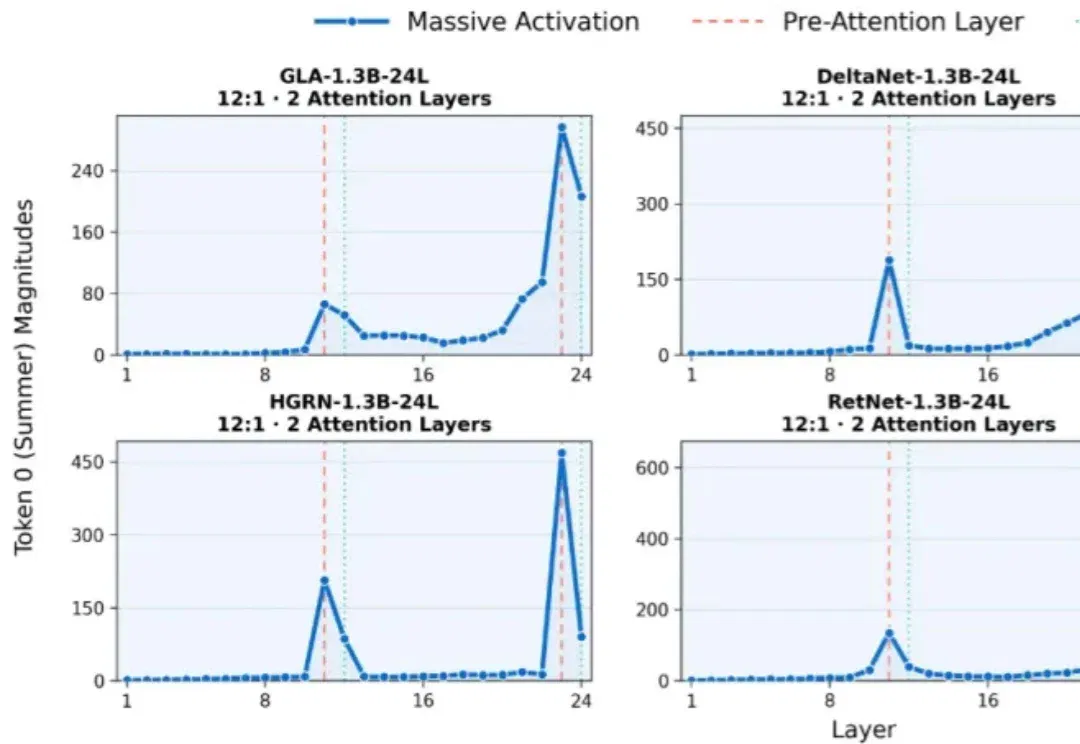
Full Attention 层尚未开始计算,它前一层的激活值已提前「冲上峰值」—— 这就像演唱会主角尚未登台,观众席已提前沸腾。来自 StartLux、清华大学等机构的研究者以 Massive Activations 为探针,首次系统刻画了少数 Full Attention 层在混合线性注意力大模型中留下的「跨层痕迹」,并识别出「注意力前尖峰」(PAS)与「尖峰间平台」(ISP)两种核心形态。
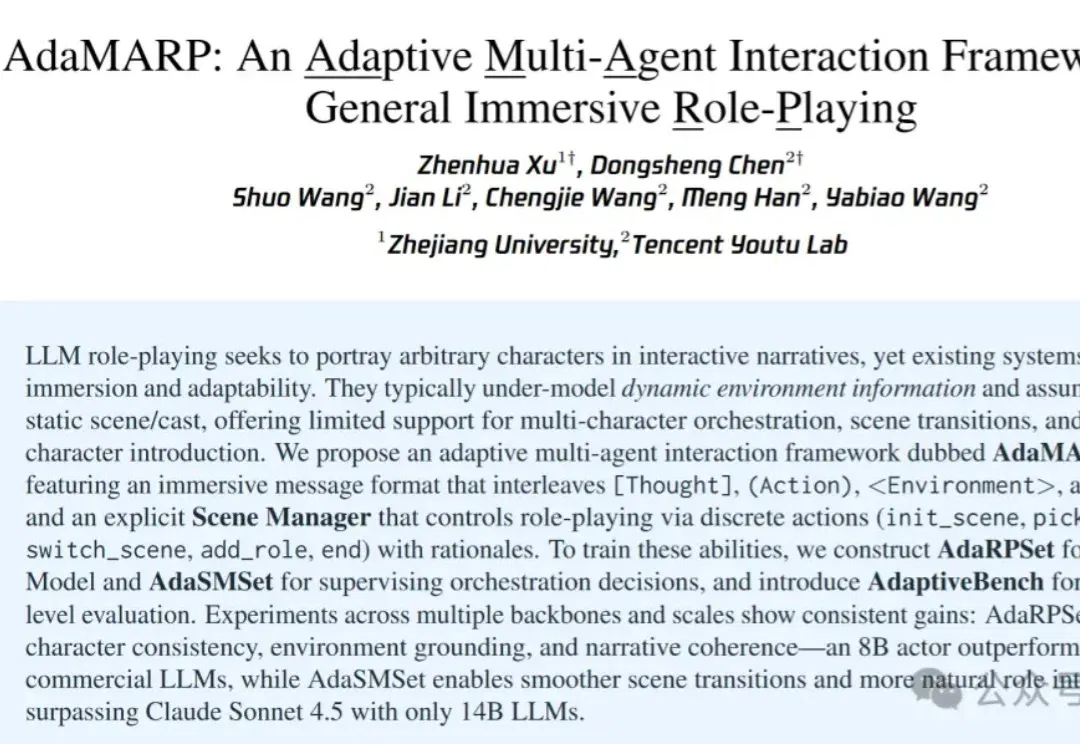
AI能实现真正的沉浸式扮演了。 大语言模型在角色扮演任务上进展迅速,但现有系统往往缺乏沉浸感和适应性: 环境信息未被充分建模,场景与角色也多为静态,难以支撑多角色调度、场景切换、动态引入新人等复杂叙事需求。 现在,浙江大学联合腾讯优图实验室提出AdaMARP(Adaptive Multi-Agent Interaction Framework for General Immersive Role-Playing)—— 一种面向通用沉浸式角色扮演的自适应多智能体交互框架。 该框架通过四通道消息格式和场景管理器,让AI不仅会「说」,还会「想」、会「动」、会「感知环境」,并在复杂叙事中灵活切换场景、
上海交通大学卢策吾、汶川团队联合穹彻提出LIFT(Late Reactive Injection of Force for VLA Post-Training),被CoRL 2026高分收录,该方法在保留预训练知识的前提下,仅通过20至30条在线带力数据后训练即可让VLA学会力反馈,显著提升叠毛巾、插书、汉诺塔圆环放置等接触密集型任务表现。
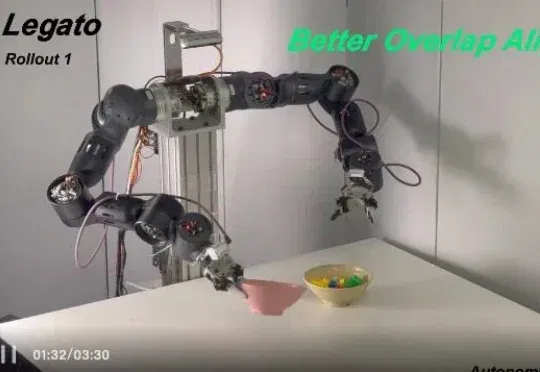
近日,千寻智能高阳团队的研究成果 《Learning Native Continuation for Action Chunking Flow Policies》 被机器人顶会 RSS 2026 接收!这项工作从训练机制出发,让机器人动作天然具有连续性,实现了 "连音" 般的流畅执行,在五个真实世界操作任务上超越了现有方法,为具身智能领域的动作生成研究提供了新的思路。