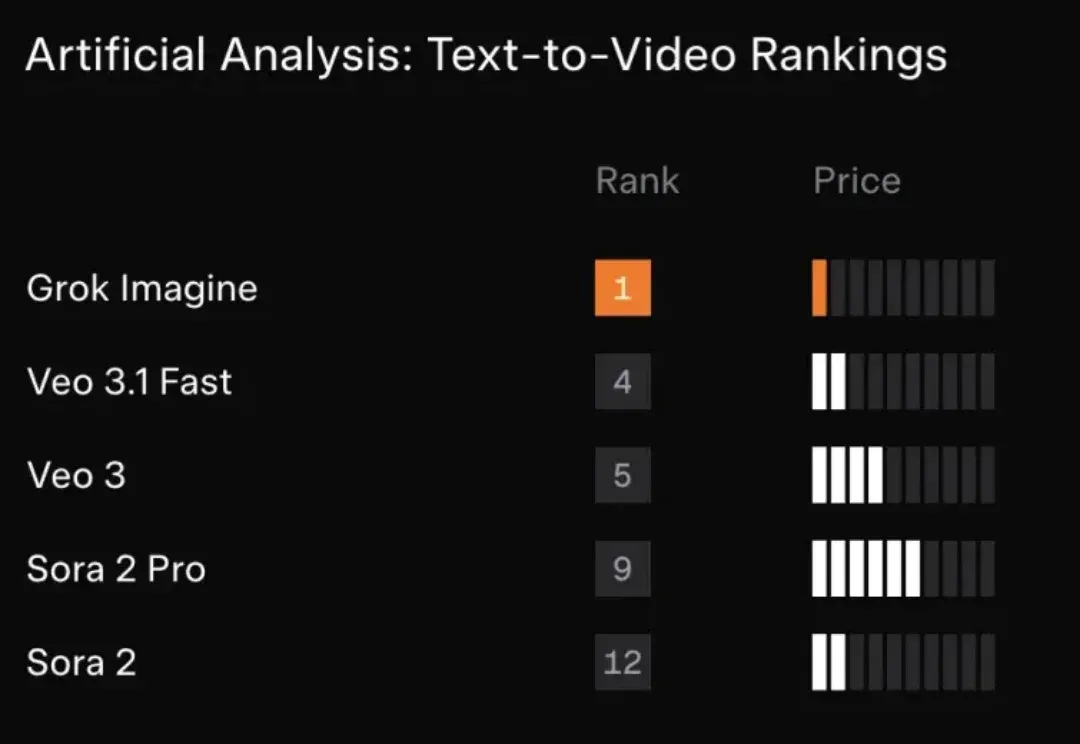
马斯克视频生成模型首次交卷!电影级运镜+音效,免费可玩(在新窗口打开)
xAI“迄今为止最强大的视频音频生成模型”Grok Imagine 1.0版本,正式全面上线。
共 76 篇
xAI“迄今为止最强大的视频音频生成模型”Grok Imagine 1.0版本,正式全面上线。
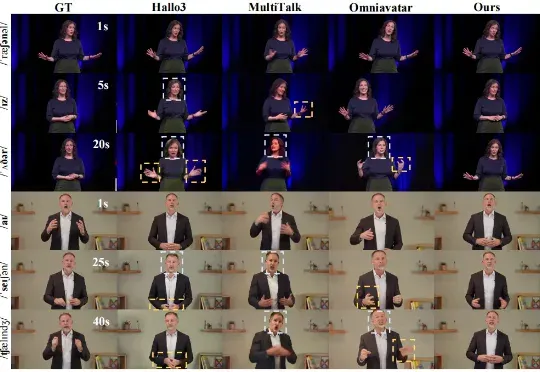
随着内容创作智能化需求的爆发,长时长、高质量数字人视频生成始终是行业痛点。近日,字节跳动商业化 GenAI 团队联合浙江大学推出商用级长时序音频驱动人物视频生成模型 ——InfinityHuman,打破传统音频驱动技术在长视频场景中的局限性,开启 AI 数字人实用化新征程
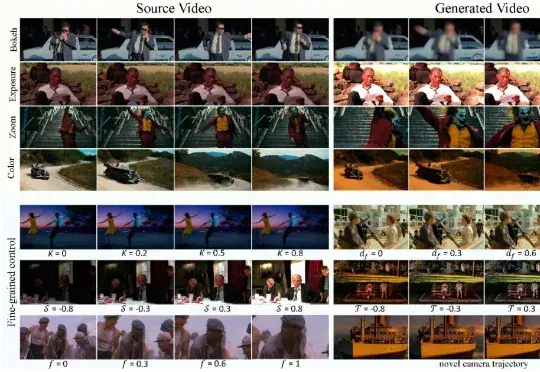
现有视频生成模型往往难以兼顾「运镜」与「摄影美学」的精确控制。为此,华中科技大学、南洋理工大学、商汤科技和上海人工智能实验室团队推出了 CineCtrl。作为首个统一的视频摄影控制 V2V 框架,CineCtrl 通过解耦交叉注意力机制,摆脱了多控制信号共同控制的效果耦合问题,实现了对视频相机外参轨迹与摄影效果的独立、精细、协调控制。
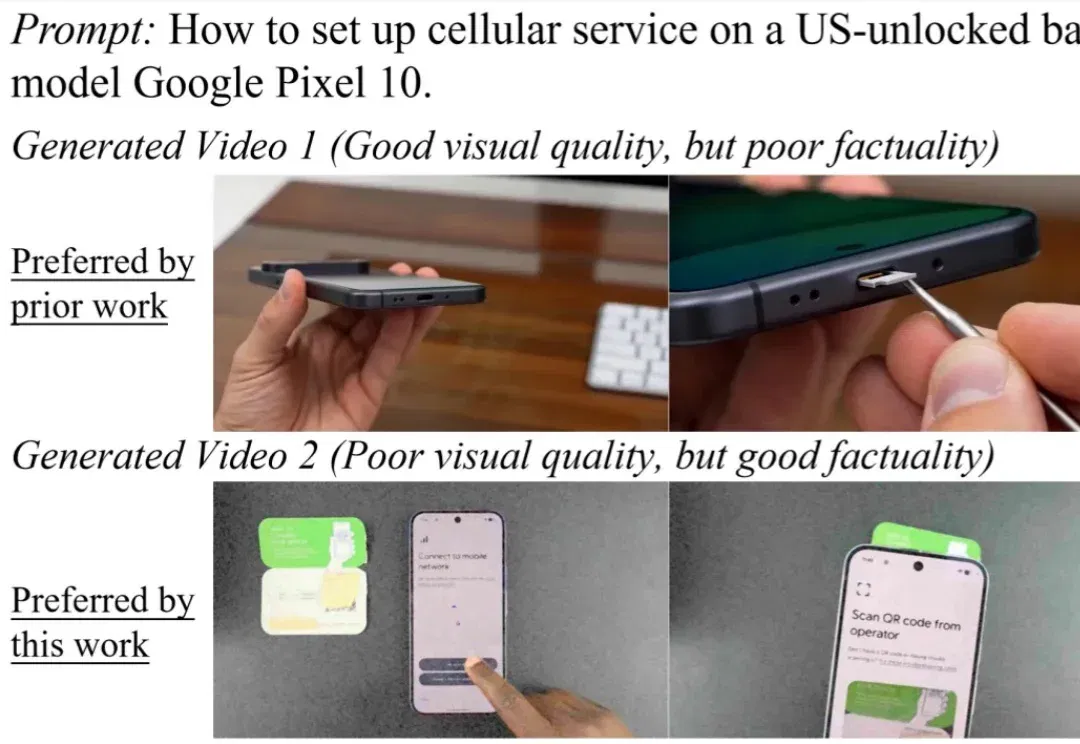
当视频生成模型走出娱乐创作的舒适区,进入科学、医疗、教育等知识密集场景,它们是否还能生成事实准确、清晰可用的视频?
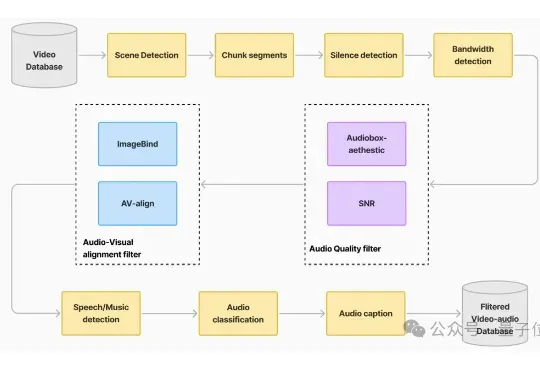
自带声音的视频生成模型,开源版开卷! 最新赶到的是腾讯混元:刚刚正式开源端到端的视频音效生成模型HunyuanVideo-Foley。
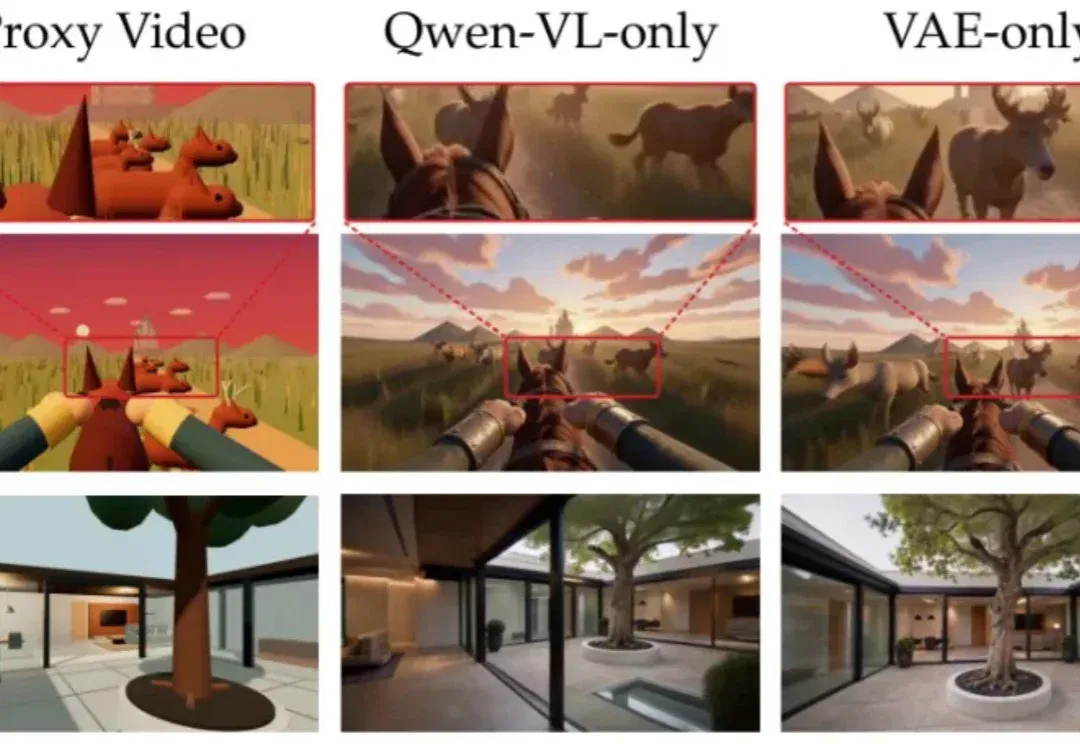
视频生成模型的视觉质量不断提升,但当前主流视频扩散模型仍面临两项根本局限。第一是物理规律约束不足:模型从像素中学习世界的视觉表象,却缺少物理方程的显式约束,画面看似合理,实际却不符合物理规律。
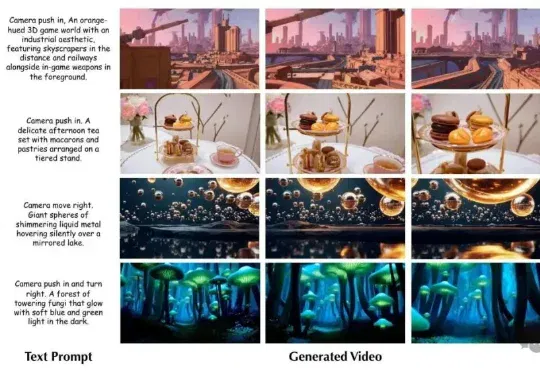
浙大联合微软亚洲研究院最新提出的World-R1,不改架构、不要3D数据,纯靠强化学习就让视频生成模型学会了“理解”三维世界。World-R1 的出发点很简单:预训练的视频模型里面已经有 3D 知识了,只是“沉睡”着。用强化学习把它叫醒就行。
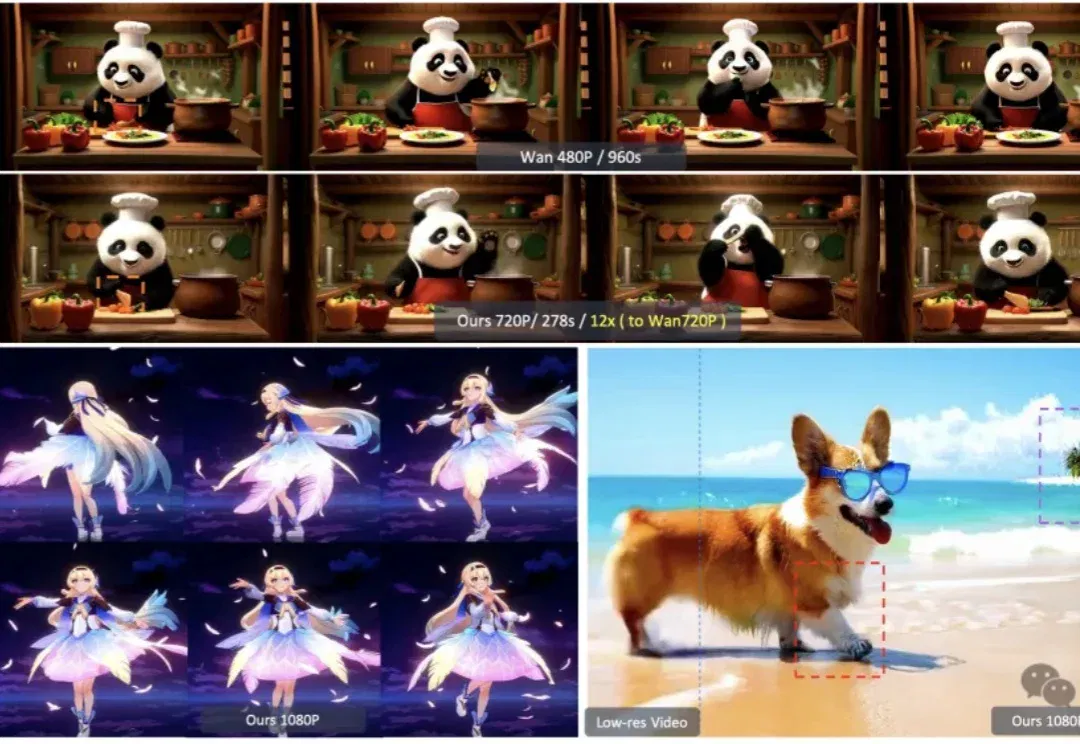
当下视频生成模型正在快速逼近真实世界的画面质感,但一个现实瓶颈也越来越突出—— 那就是分辨率越高,生成所需要的时间就越长。
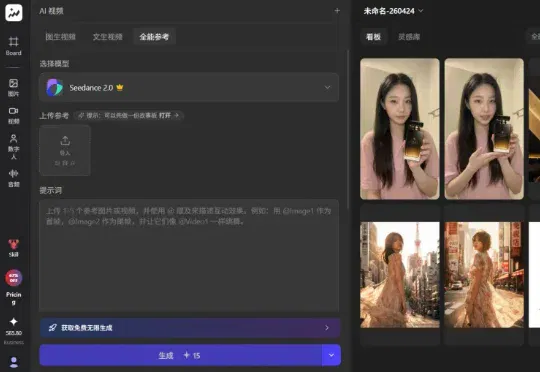
做过 AI 视频的都懂,除了 Seedance 2.0 本身的高定价,废片所烧掉的 token 算力也是一笔不小的开支。但在 Topview 平台,直接把这笔最大试错成本给重新定义了!热门视频生成模型 Seedance 2.0,加上最新的图片生成模型 Image 2,订阅 Ultra Plan,可不限量使用。
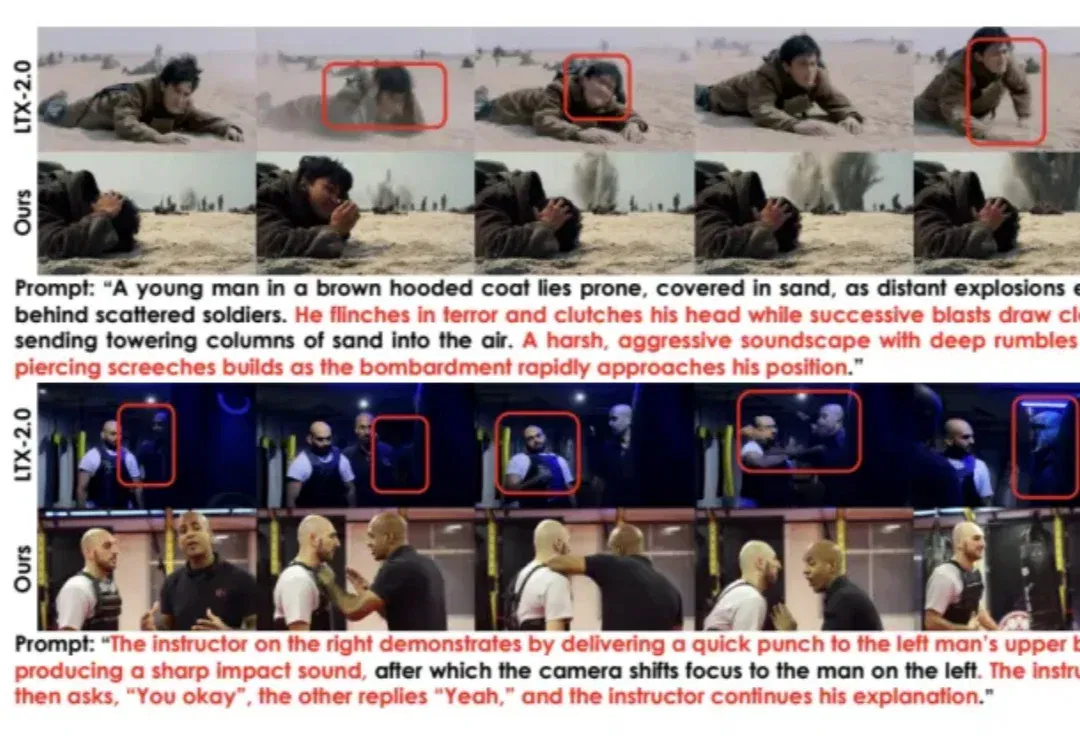
当用户给出一句简单提示词时,当前的音视频生成模型往往已经能够生成具有不错质量的视听内容。然而,一旦提示词变得复杂,问题便开始暴露出来。