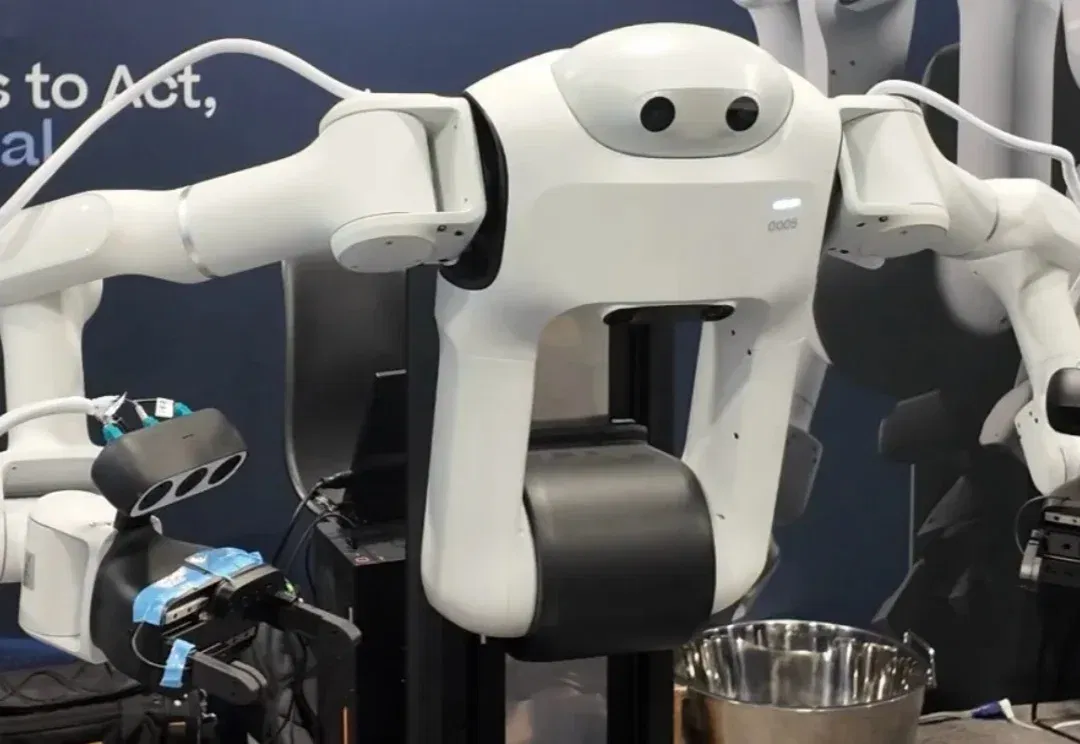
Z Potentials|CVPR 现场对话苏度科技团队:没有遥控器,没有隔离带,只有真实世界随机的考卷(在新窗口打开)
2026 年 6 月的科罗拉多州丹佛市,全球计算机视觉与模式识别领域的顶级学术盛会 CVPR 正在召开,最前沿的视觉模型、机器人技术、下一代智能系统全都在同一个舞台上被反复讨论和辩证。
共 22 篇
2026 年 6 月的科罗拉多州丹佛市,全球计算机视觉与模式识别领域的顶级学术盛会 CVPR 正在召开,最前沿的视觉模型、机器人技术、下一代智能系统全都在同一个舞台上被反复讨论和辩证。
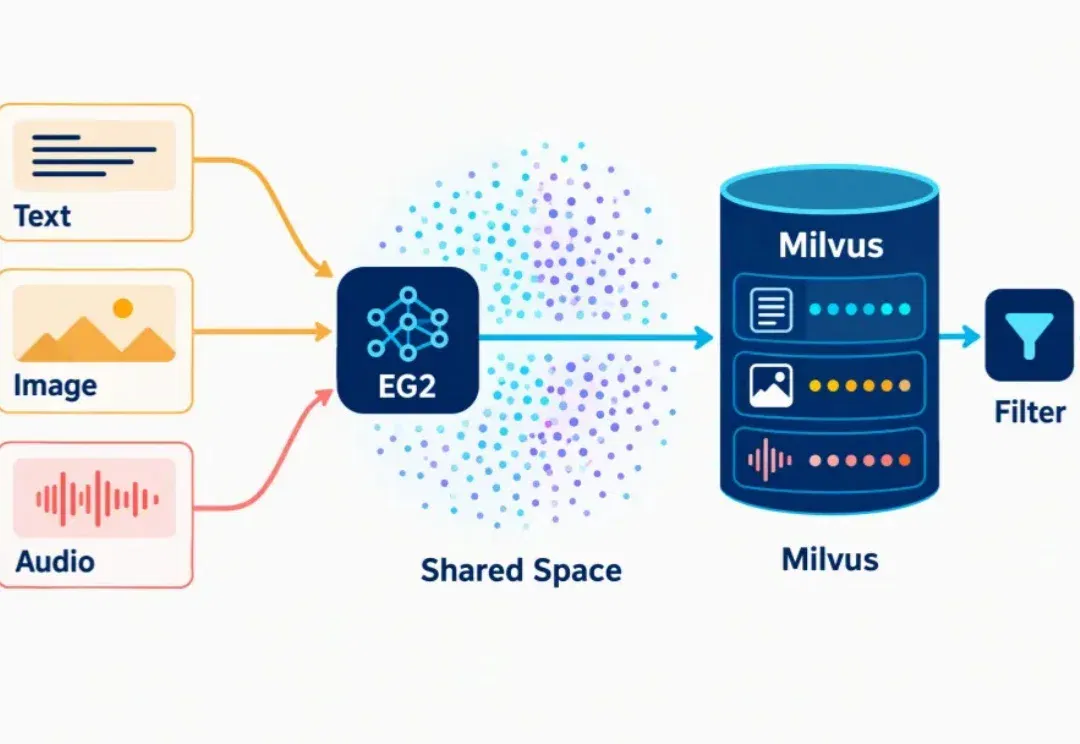
传统多模态检索,往往要维护多套embedding模型。文本用一套 embedding,图片用一套视觉模型,音频再单独接一条链路。
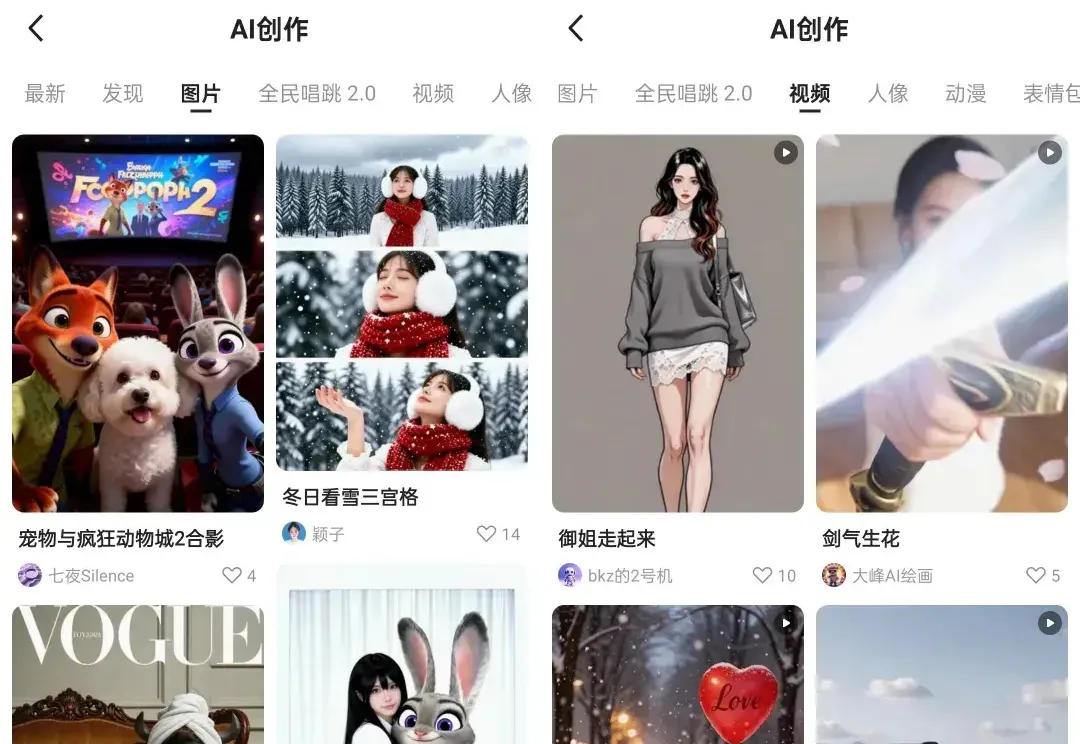
千问 App,大家都用上了吧? 这个被阿里委以重任的 AI 应用,今天迎来了一波史诗级更新:正式接入了阿里最强的两大视觉模型 —— Qwen-Image 和 Wan 2.5。 在 Hugging Face 等开源社区,Qwen-Image 系列模型长期霸榜,被全球开发者玩出了花;而 Wan 2.5 则是业内少有、具备「原生音画同步」能力的视频生成新贵。 但过去,想用上这些 SOTA 模型,你得会跑代码、部署 ComfyUI,或者苦等海外大厂的内测资格。 今天,门槛消失了。 千问 App 将这两大顶流模型深度整合,让普通用户在手机上也能拥有一座「掌上影像工作室」。 我们第一时间实测了这项更新,结
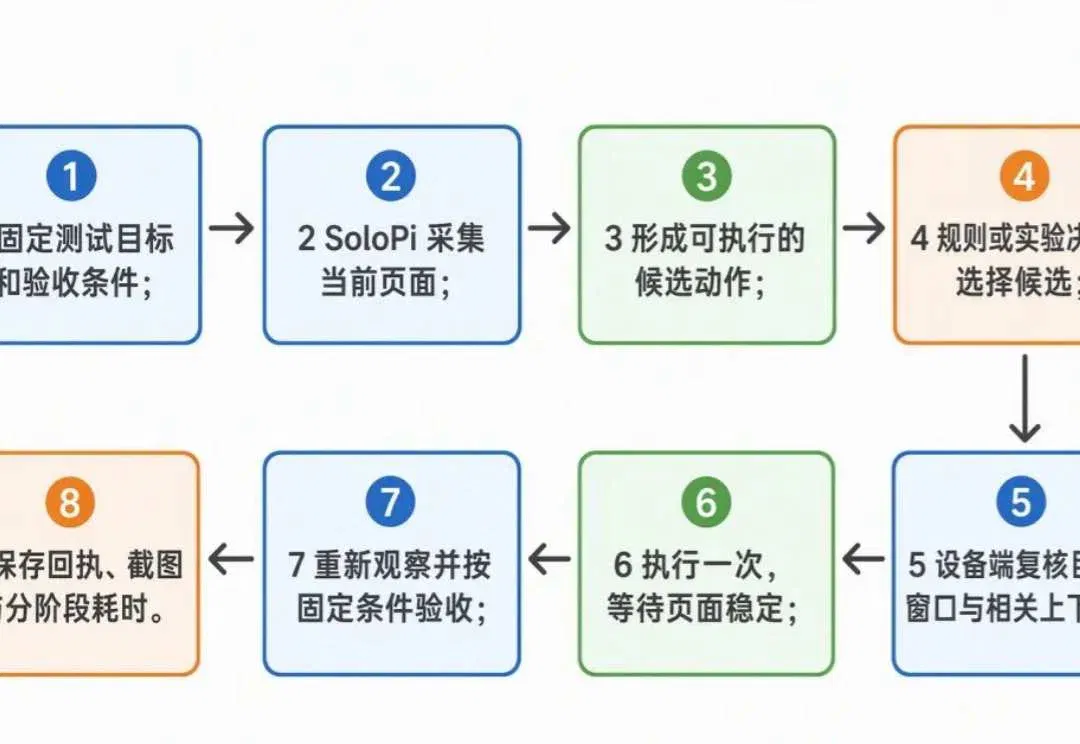
项目作者在两条支付宝浏览流程比较耗时,并单独评测本地文字及视觉模型;实测提速来自执行器,模型增益尚未证实。
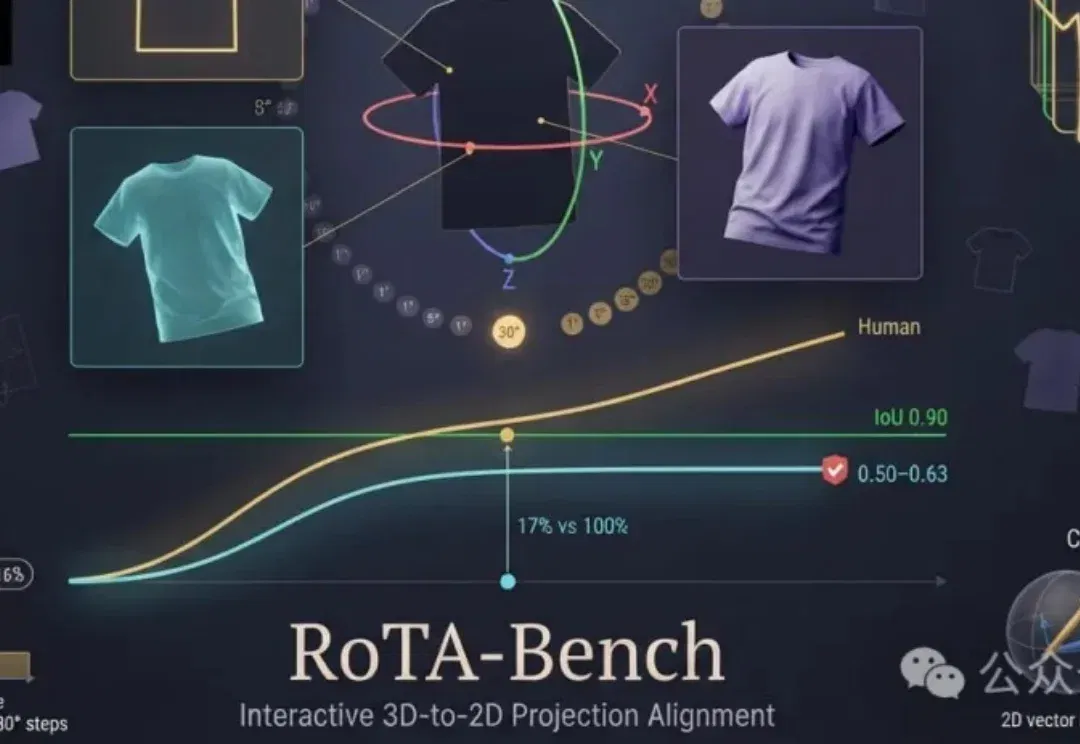
厦门大学与南洋理工大学团队用可逆旋转构造交互任务。在 100 个测试任务中,所测最高模型成功率为 17%,本科生组 400 次运行全部成功。论文还分析了旋转方向、角度和交互历史。
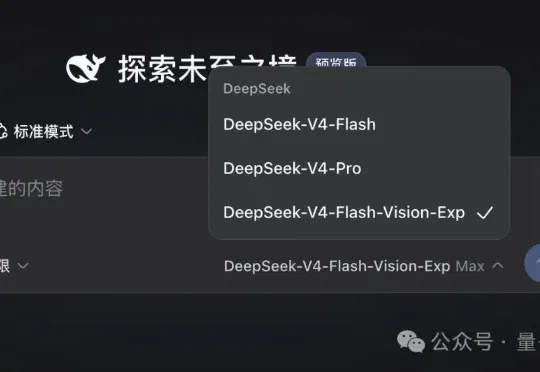
等了四个月,DeepSeek的多模态模型:deepseek-v4-flash-vision-exp,终于发布。我也是第一时间赶到现场,连夜开始实测。相比V4 Flash最大的不同,就是支持原生支持图片输入了,但图片生成当然还是没有的。
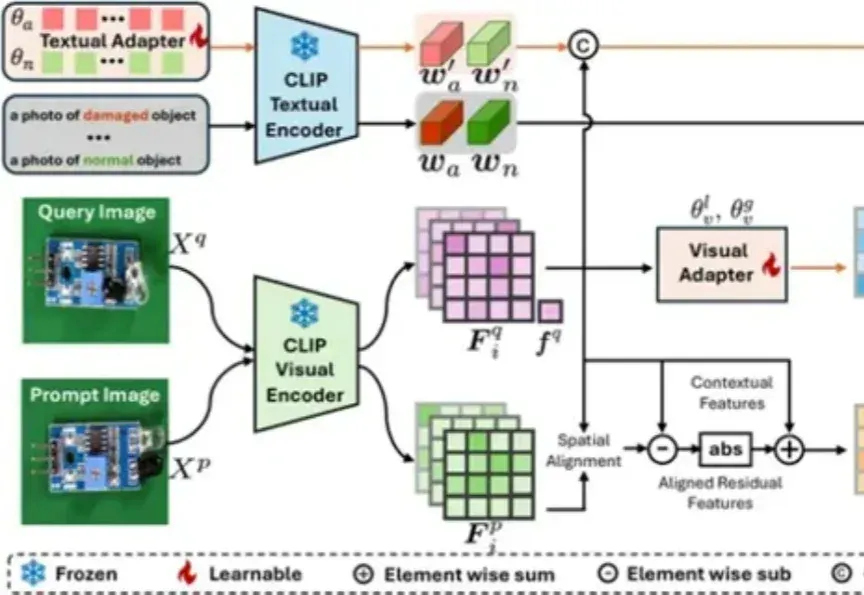
视觉模型用于工业“缺陷检测”等领域已经相对成熟,但当前普遍使用的传统模型在训练时对数据要求较高,需要大量的经过精细标注的数据才能训练出理想效果。
REG 是一种简单而有效的方法,仅通过引入一个 class token 便能大幅加速生成模型的训练收敛。其将基础视觉模型(如 DINOv2)的 class token 与 latent 在空间维度拼接后共同加噪训练,从而显著提升 Diffusion 的收敛速度与性能上限。在 ImageNet 256×256 上,
DeepSeek Harness这下真快被网友「插成万物」了。小黑鲸上线还没多久,单单在GitHub上打着dsh-plugin标签的公开仓库,就已经冲到了700+个???有人给它装浏览器、长期记忆、数据库和任务管理;有人嫌DeepSeek不会看图,现场接了个视觉模型进去。
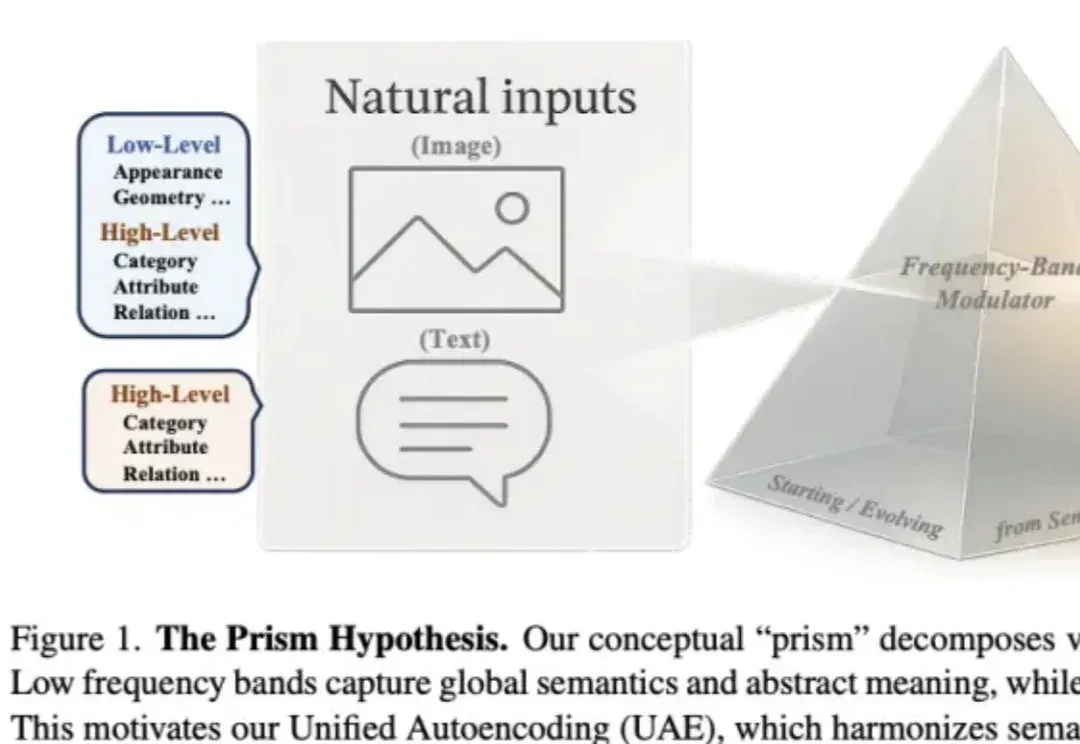
作者来自 Nanyang Technological University(MMLab) 与 SenseTime Research,提出 Prism Hypothesis(棱镜假说) 与 Unified Autoencoding(UAE),尝试用 “频率谱” 的统一视角,把语义编码器与像素编码器的表示冲突真正 “合并解决”。