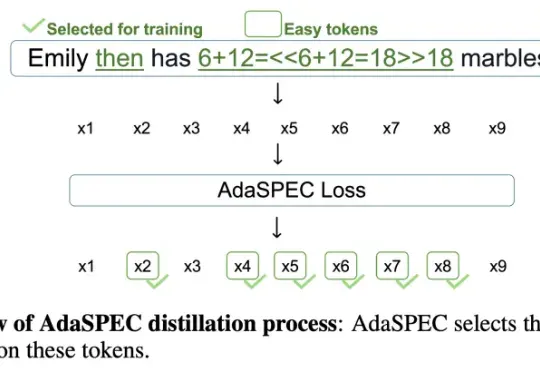
NeurIPS 2025 Spotlight | 选择性知识蒸馏精准过滤:推测解码加速器AdaSPEC来了(在新窗口打开)
目前,最先进的对齐方法是使用知识蒸馏(Knowledge Distillation, KD)在所有 token 上最小化 KL 散度。然而,最小化全局 KL 散度并不意味着 token 的接受率最大化。由于小模型容量受限,草稿模型往往难以完整吸收目标模型的知识,导致直接使用蒸馏方法的性能提升受限。在极限场景下,草稿模型和目标模型的巨大尺寸差异甚至可能导致训练不收敛。
共 86 篇
目前,最先进的对齐方法是使用知识蒸馏(Knowledge Distillation, KD)在所有 token 上最小化 KL 散度。然而,最小化全局 KL 散度并不意味着 token 的接受率最大化。由于小模型容量受限,草稿模型往往难以完整吸收目标模型的知识,导致直接使用蒸馏方法的性能提升受限。在极限场景下,草稿模型和目标模型的巨大尺寸差异甚至可能导致训练不收敛。

UIUC等团队提出A2D,用冻结师生模型的分歧与兼容性训练出题器,再以生成问题进行在策略蒸馏。论文在数学、代码和智能体任务上报告增益,代理信号仍有适用边界。
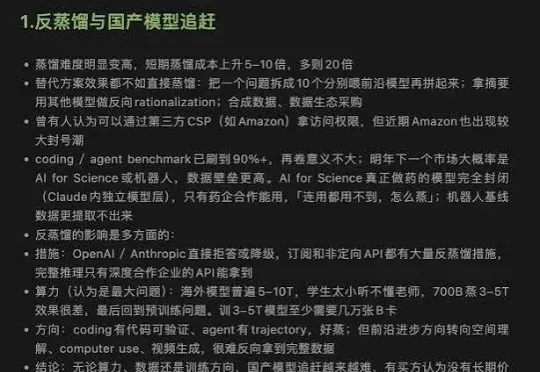
文章整理一场10月初的讨论,记录参会者对蒸馏难度、模型竞争、AI制药和云渠道分成的不同判断。文中金额、算力和领先时间多为讨论中的估计,部分数据未经验证。
过去一年,AI数据市场经历了几轮剧烈的主题切换:从标准Coding到垂直行业,从合成蒸馏到真实场景,从任务够长就是好数据到什么任务值得解。需求每两个月刷新一次,供给侧的生存法则也在同步重写。在这个过程中,一些原本隐身于产业链深处的角色开始浮出水面——数商,就是其中之一。
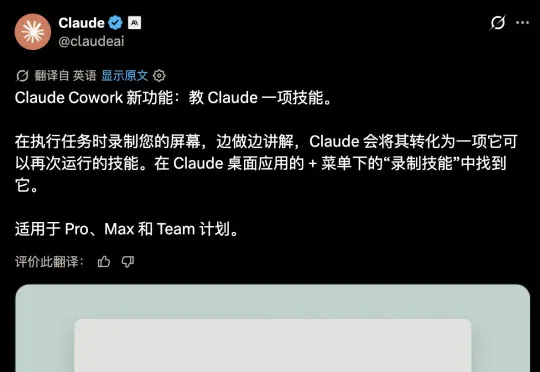
现在,你可以通过录屏 + 语音讲解的方式,彻底把自己蒸馏成 Skill 了。7 月 21 日,Anthropic 在 Claude 桌面端 Cowork 的 + 菜单里加了一项「Record a Skill」:录屏,一边操作一边用语音讲解,录完后 Claude 自动把演示转化成一个可复用的 Skill。
难怪Meta CTO都不得不承认“内部士气快跌到历史谷底”了。围绕AI,小扎又整出了新的幺蛾子:之前不是说要把员工们全蒸馏了吗?这事紧急叫停了,因为数据搞!泄!露!啦!
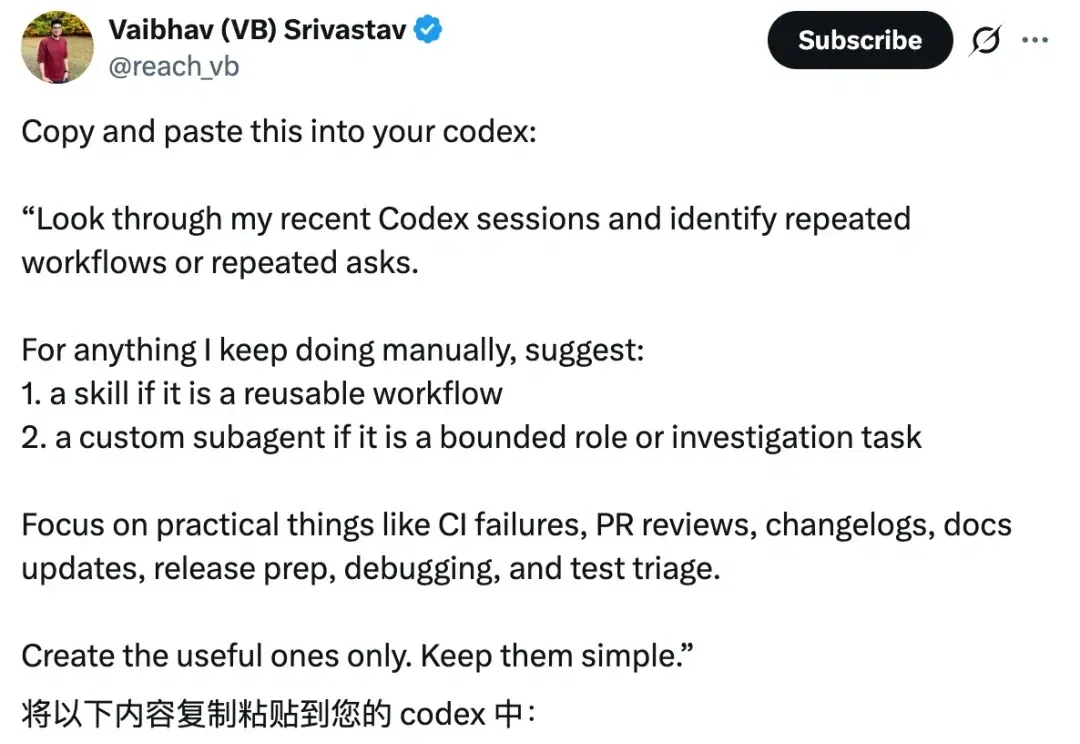
Codex自家程序员,直接把Codex「自我蒸馏」的秘籍给爆出来了…
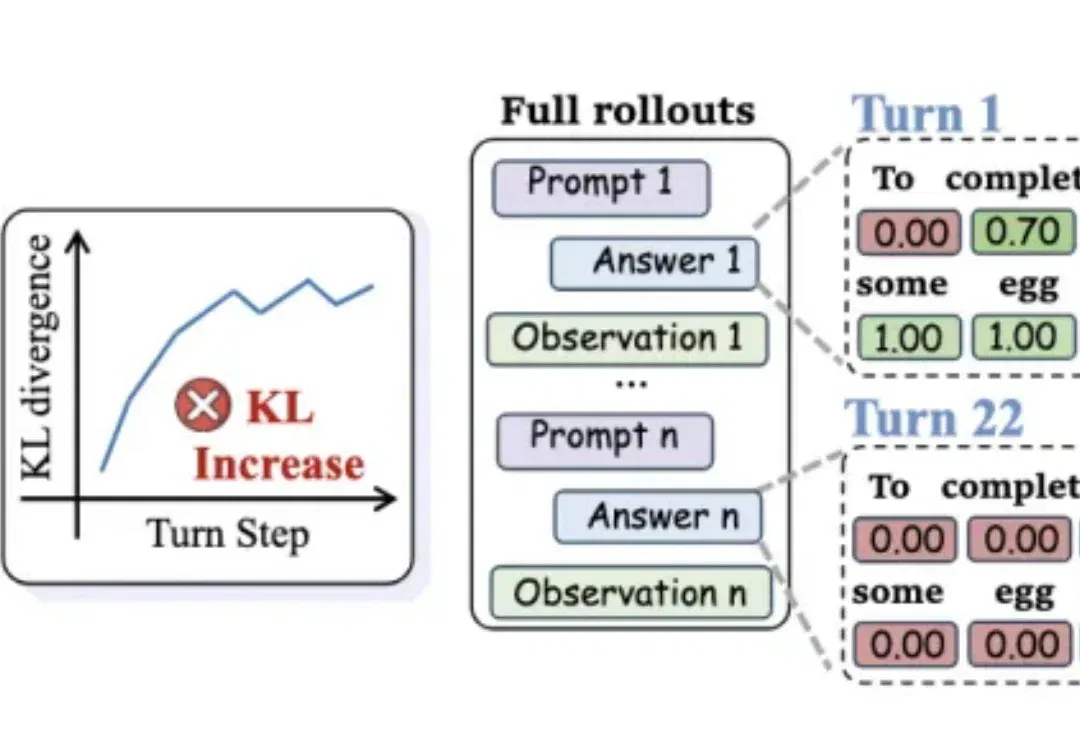
把强大模型的能力“蒸馏”给小模型,听起来很美—— 但放到多轮对话Agent场景里,效果往往一塌糊涂。
继skill同事之后,有聪明人迁移泛化了一下: 既然可以蒸馏任何人,那为什么不让乔布斯马斯克给我打工呢?
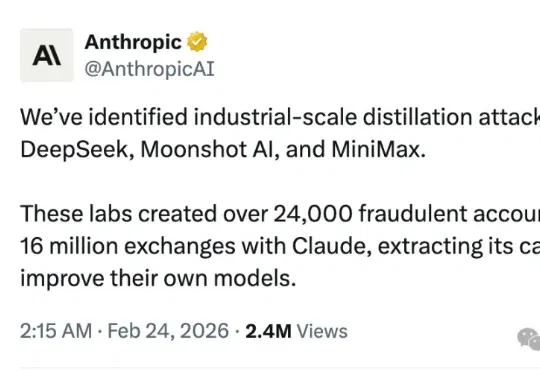
刚刚, Anthropic 发推称,DeepSeek、Moonshot AI和MiniMax三家国内的 AI 公司对Claude进行大规模的蒸馏攻击。OK, A 社你真的很讨厌中国公司了。简单说就是:这三家公司用大量假账号,疯狂地向 Claude 提问,然后拿 Claude 的回答去训练自己的模型。