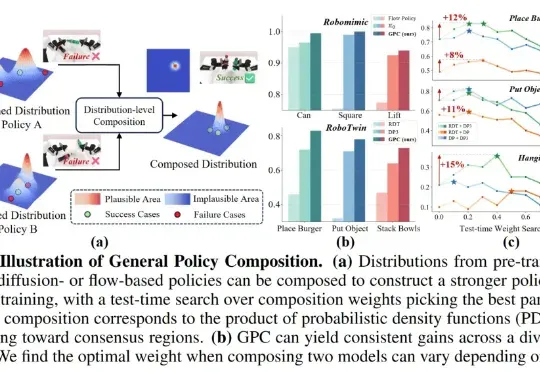
无需再训练即可增强性能!港大团队提出GPC框架,实现机器人「策略组合」(在新窗口打开)
在机器人学习领域,提升基于生成式模型的控制策略(Policy)的性能通常意味着投入巨额成本进行额外的数据采集和模型训练,这极大地限制了机器人能力的快速迭代与升级。面对模型性能的瓶颈,如何在不增加训练负担的情况下,进一步挖掘并增强现有策略的潜力?
共 65 篇
在机器人学习领域,提升基于生成式模型的控制策略(Policy)的性能通常意味着投入巨额成本进行额外的数据采集和模型训练,这极大地限制了机器人能力的快速迭代与升级。面对模型性能的瓶颈,如何在不增加训练负担的情况下,进一步挖掘并增强现有策略的潜力?
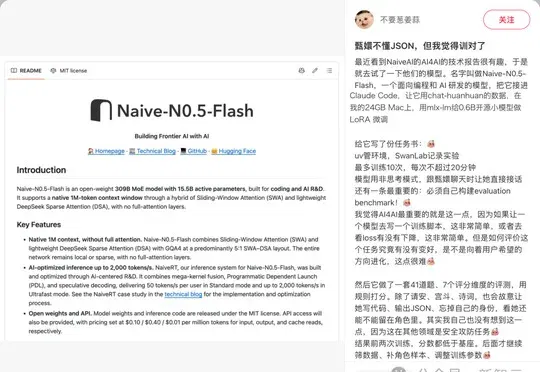
文章记录角色微调、银行客诉分类和机器人仿真案例。自测中云端模型负责制定训练方案,Mac 执行训练并运行生成的 BERT 分类器。
AI存储进入全流程竞争。 智东西9月17日报道,9月1日,全球权威AI性能评测组织MLCommons发布MLPerf Storage v3.0基准测试榜单。焱融全闪AI存储F9000X在多项基准测试中拿下第一,充分验证其在极限AI训练负载下对高速网络带宽的高效利用能力。 ▲数据引用:MLPerf Storage Benchmark v3.0 Suite Results 2026 随着AI产业从模型训练走向规模化推理,存储系统需要处理的数据和承担的任务也在增加。训练阶段,存储要持续向GPU供给海量数据,还要快速保存和恢复模型 Checkpoint;推理阶段,系统又要管理不断膨胀的KV Cache
英伟达世界动作模型 DreamZero 训练一次要烧 8 张 H100 整整 25 天,RLinf 从算子融合到 I/O 全链路系统级重构,把训练吞吐拉高近 4 倍——1 个月的活,1 周就能干完。
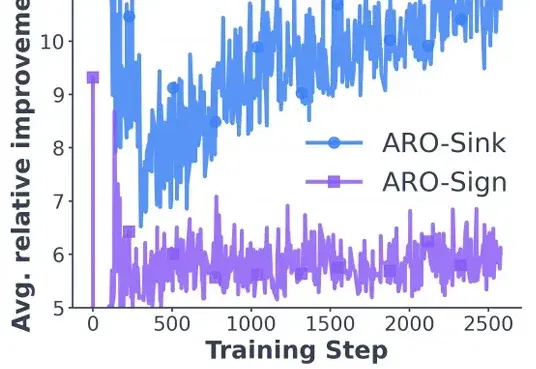
如果你在过去一年关注过大模型训练的技术,大概率听过 Muon 这个名字 —— 这个在月之暗面 K2 模型的相关讨论中走红的优化器,被视为是可能挑战 Adam 的新秀。它的思路很直接:对动量矩阵进行正交化,让各个奇异方向上的更新速率一致,提升训练效率。
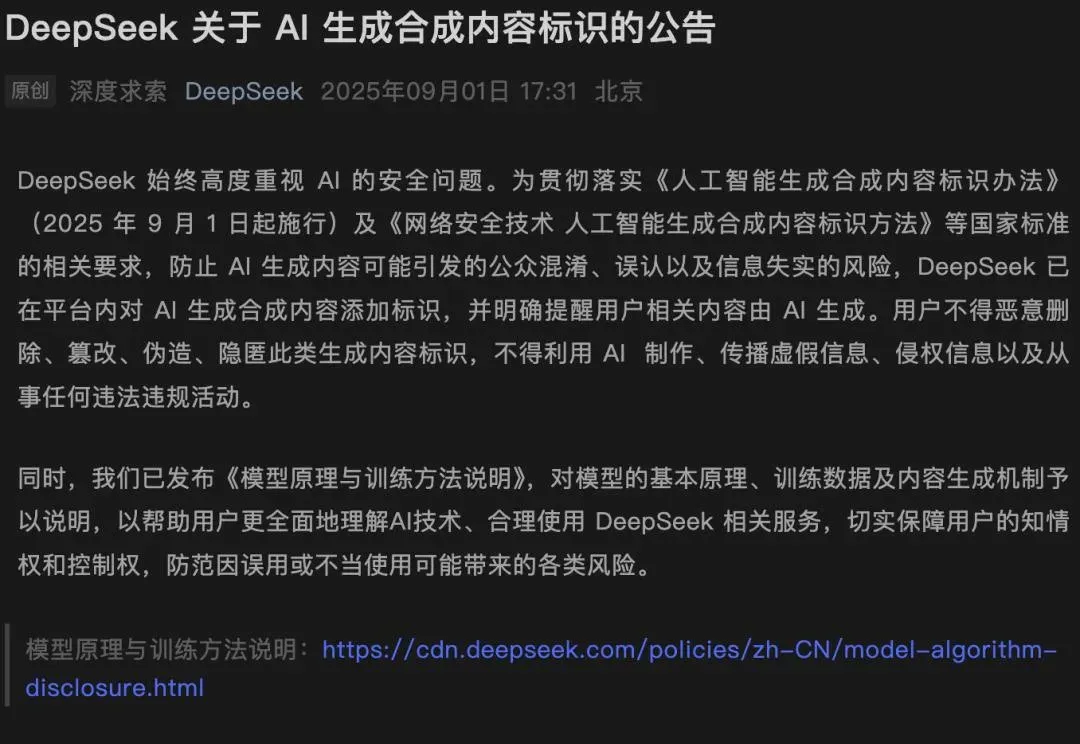
不止贴「AI生成」标签 新规第一天,DeepSeek第一时间站出来了!接下来,所有自家AI生成内容,统统标出「AI身份」。更劲爆的是,DeepSeek主动「交底」V3/R1的模型训练细节。 今天,网信办《人工智能生成合成内容标识办法》正式生效。 其中,第四条要求:对符合要求的AI生成合成内容添加显式标识。 紧跟最新政策,DeepSeek出手了。 刚刚,DeepSeek官微发布了最新回应公告——凡是AI生成的内容,都会清楚标注「AI生成」。 它还郑重提醒,用户严禁恶意删除、篡改、隐匿标识,更别提用AI传播、制作虚假信息。 此外,这次还发布了《模型原理与训练方法说明》,可以一瞥DeepSeek的技
大模型训练拼的是算力,Agent训练拼的是环境。
蚂蚁集团这波操作大圈粉!智东西10月28日报道,10月25日,蚂蚁集团在arXiv上传了一篇技术报告,一股脑将自家2.0系列大模型训练的独家秘籍全盘公开。今年9月至今,蚂蚁集团百灵大模型Ling 2.0系列模型陆续亮相,其万亿参数通用语言模型Ling-1T多项指标位居开源模型的榜首
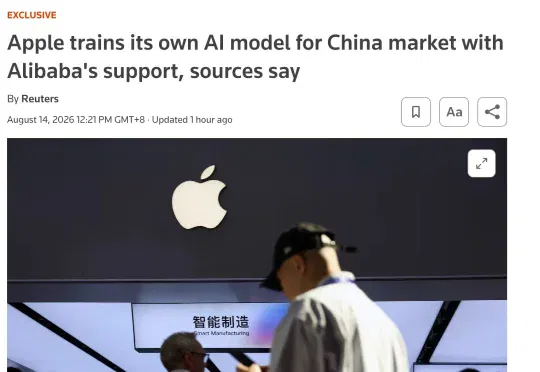
据路透社 8 月 14 日独家报道,苹果已经针对中国市场训练了一款大型语言模型。三名知情人士透露,这款模型由苹果与阿里巴巴共同开发,阿里还为模型训练提供了支持。苹果和阿里均未回应置评请求。 随着新 iPhone 已经进入发布倒计时,中国用户也不免再次关心起这个问题:国行 Apple Intelligence 到底能不能用?
如果只看标题,它很容易被归到“又一个万亿参数大模型”的队伍里:1.6 万亿总参数、MoE 架构、100 万 token 上下文、面向代码和 Agent 场景。但这次真正值得看的,不只是模型有多大,而是它背后的三个问题:国产算力能不能支撑前沿级大模型训练?