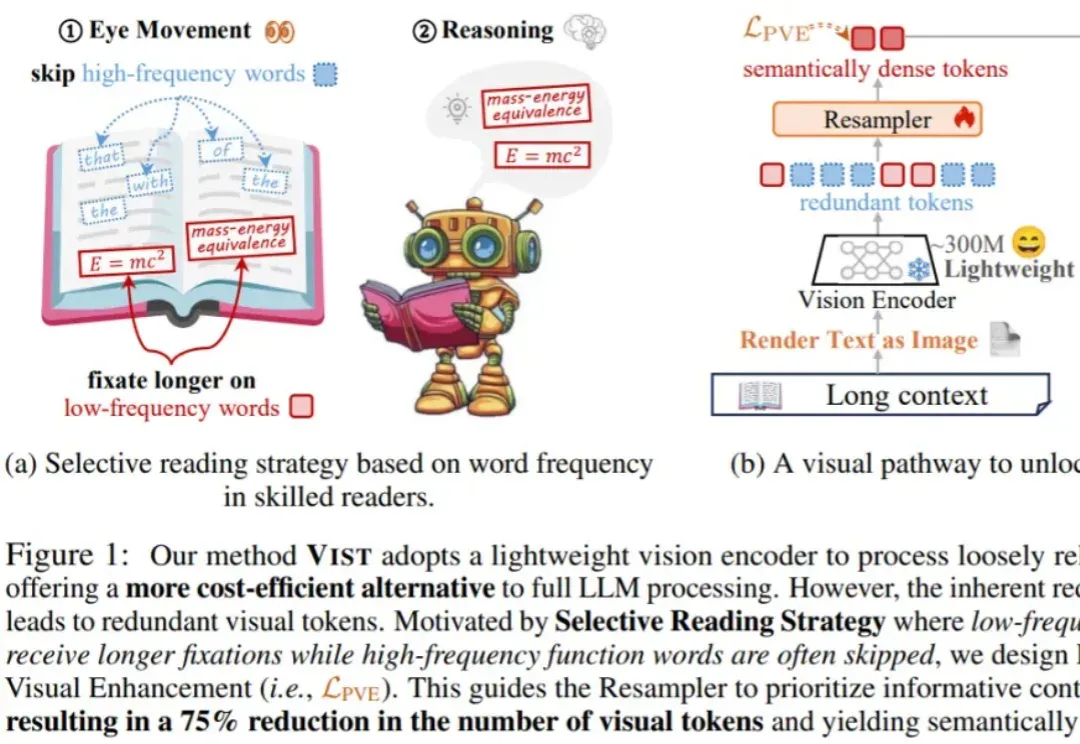
与DeepSeek-OCR不谋而合,NeurIPS论文提出让LLM像人一样读长文本(在新窗口打开)
在处理短文本时,大语言模型(LLM)已经表现出惊人的理解和生成能力。但现实世界中的许多任务 —— 如长文档理解、复杂问答、检索增强生成(RAG)等 —— 都需要模型处理成千上万甚至几十万长度的上下文。
共 16 篇
在处理短文本时,大语言模型(LLM)已经表现出惊人的理解和生成能力。但现实世界中的许多任务 —— 如长文档理解、复杂问答、检索增强生成(RAG)等 —— 都需要模型处理成千上万甚至几十万长度的上下文。
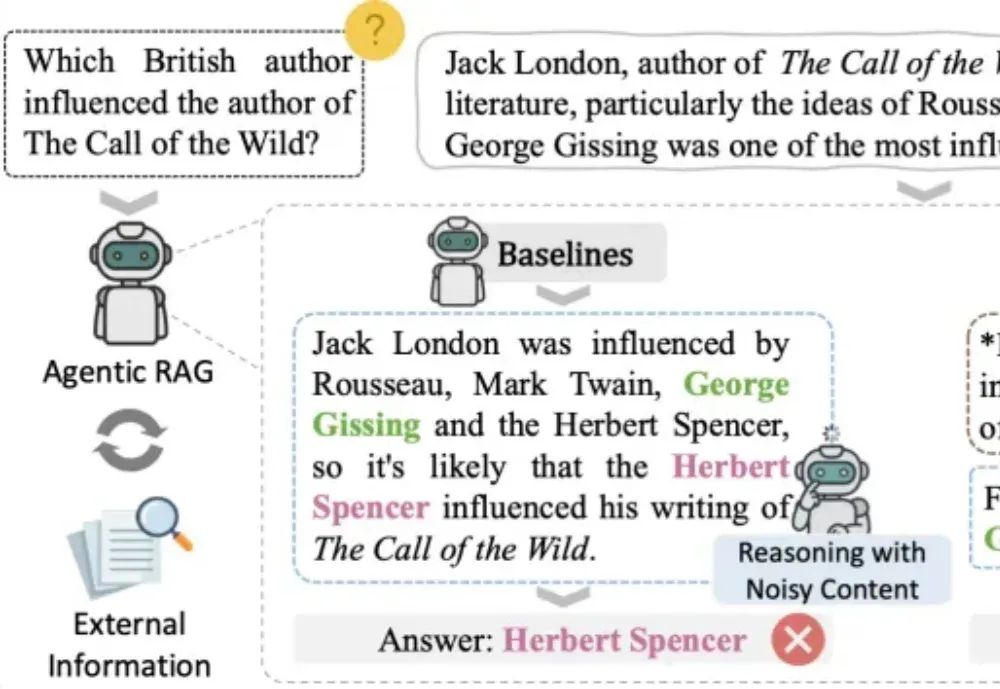
在检索增强生成(RAG)飞速发展的当下,研究者们面临的最大困境并非「生成」,而是「稳定」。
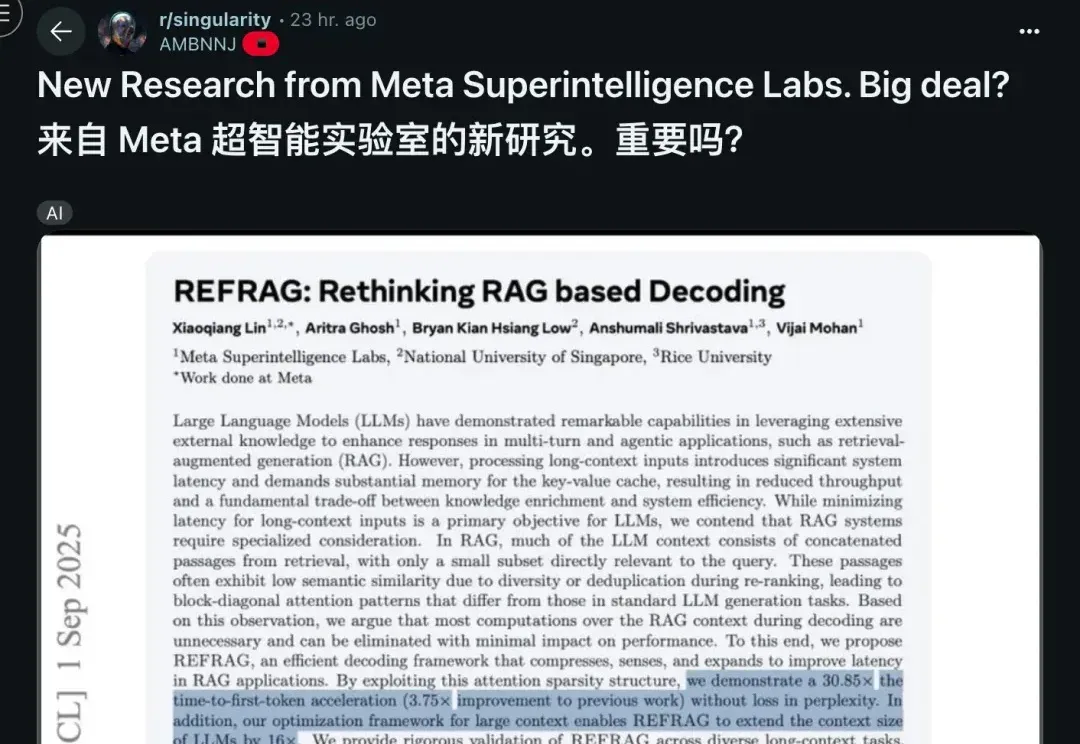
Meta超级智能实验室的首篇论文,来了—— 提出了一个名为REFRAG的高效解码框架,重新定义了RAG(检索增强生成),最高可将首字生成延迟(TTFT)加速30倍。
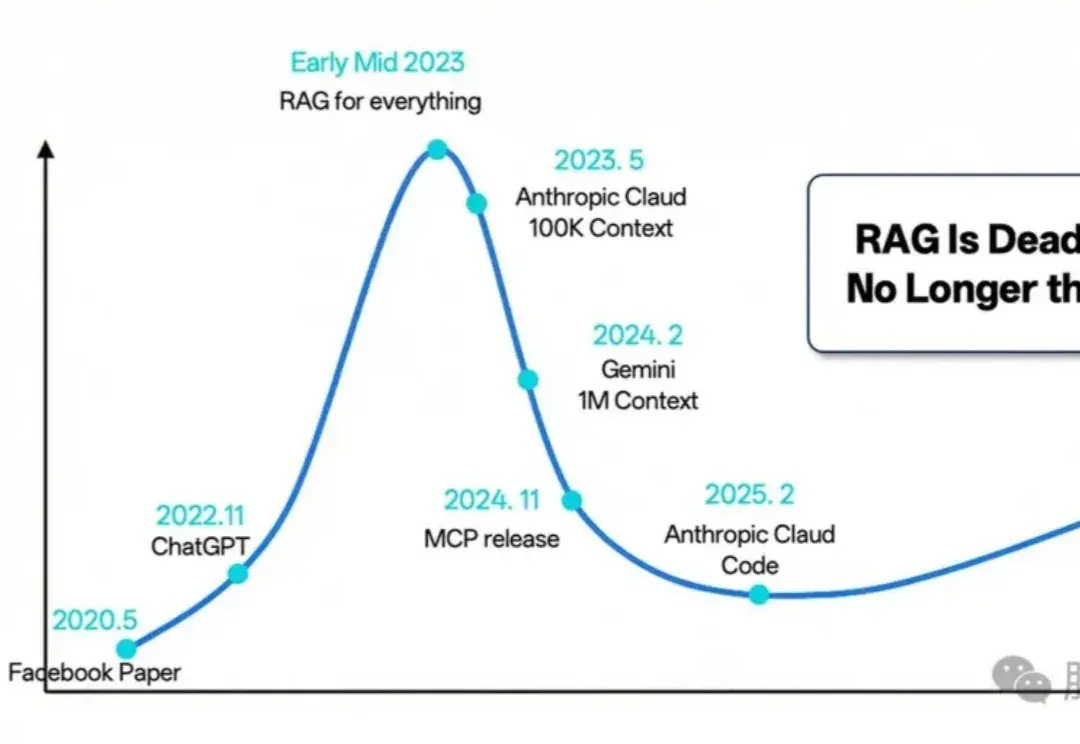
过去的 2025 年,对于检索增强生成(RAG)技术而言,是经历深刻反思、激烈辩论与实质性演进的一年。
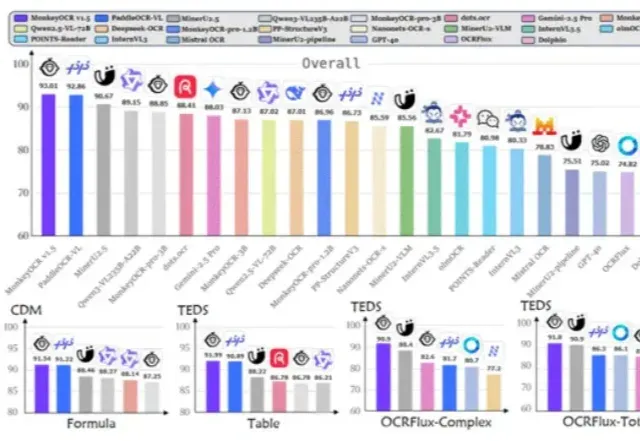
是金山派来的猴子,复杂文档解析有救了! 2025年6月以来,多模态文档解析领域迎来新一轮研究热潮,该方向逐渐成为多模态理解及大模型数据来源的重要前沿课题。 在数字化办公与AI技术深度融合的今天,文档智能解析技术已成为信息抽取、检索增强生成和自动化文档分析的核心基石。然而,现实世界中的文档往往布局复杂、表格嵌套、内含图片公式,甚至跨页分布,这让许多现有的OCR(光学字符识别系统,Optical Character Recognition)系统感到棘手。 MonkeyOCR v1.5是一个全新的统一视觉-语言文档解析框架。它在全能多模态文档解析基准OmniDocBench v1.5,OCRFlux
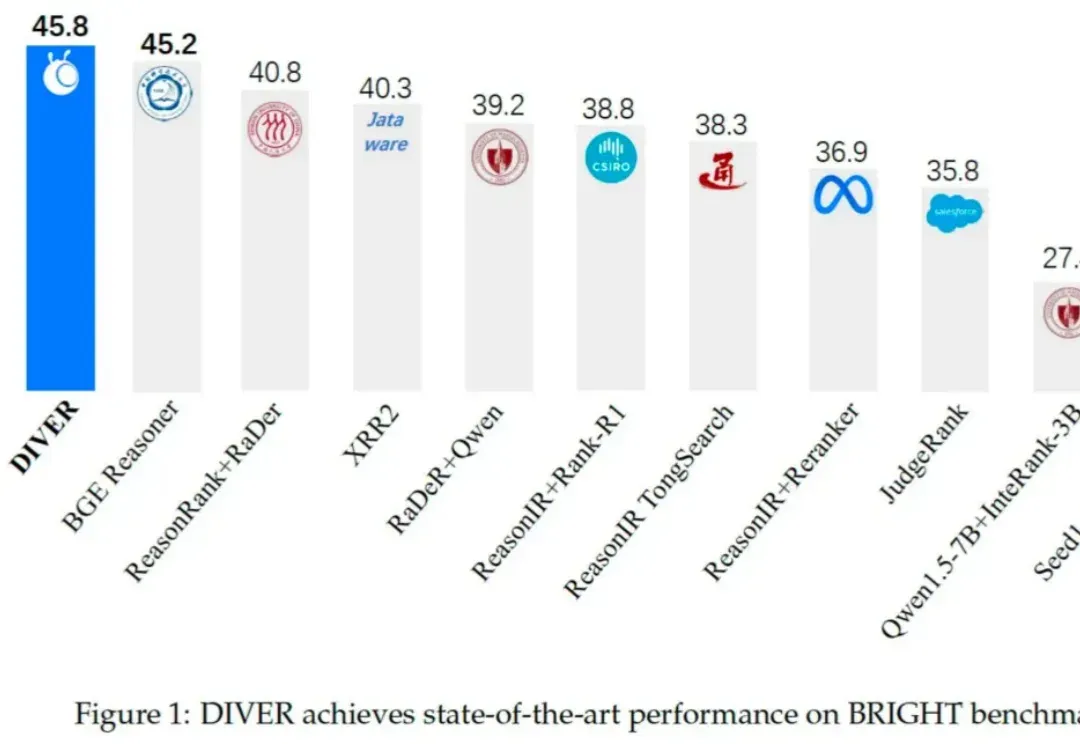
在当前由大语言模型(LLM)驱动的技术范式中,检索增强生成(RAG)已成为提升模型知识能力与缓解「幻觉」的核心技术。然而,现有 RAG 系统在面对需多步逻辑推理任务时仍存在显著局限,具体挑战如下: