刚刚,智源悟界·Emu3.5重塑世界模型格局,原生具备世界建模能力(在新窗口打开)
今天,北京智源人工智能研究院(BAAI)重磅发布了其多模态系列模型的最新力作 —— 悟界・Emu3.5。这不仅仅是一次常规的模型迭代,Emu3.5 被定义为一个 “多模态世界大模型”(Multimodal World Foudation Model)。
共 19 篇
今天,北京智源人工智能研究院(BAAI)重磅发布了其多模态系列模型的最新力作 —— 悟界・Emu3.5。这不仅仅是一次常规的模型迭代,Emu3.5 被定义为一个 “多模态世界大模型”(Multimodal World Foudation Model)。
为破解机器人产业「一机一调」的开发困境,智源研究院开源了通用「小脑基座」RoboBrain-X0。它创新地学习任务「做什么」而非「怎么动」,让一个预训练模型无需微调,即可驱动多种不同构造的真实机器人,真正实现了零样本跨本体泛化。
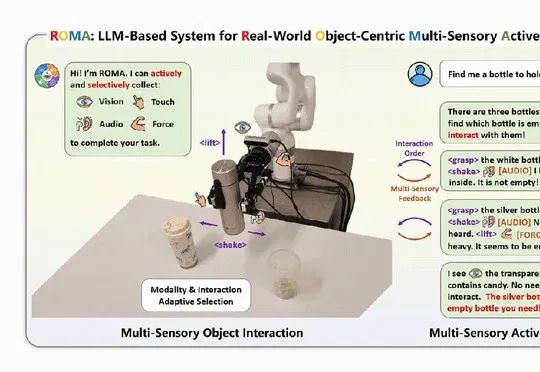
人大高瓴 GeWu-Lab、智源研究院与燧行 AresoX 等机构提出 ROMA,构建 ROMI-2K、ROMA Bench 及 ROMA-7B,使机器人融合视听触力主动探索物体,并在 ROMA Bench 上以 72.9% 总体任务成功率基本追平 GPT-6 Astra。
当大模型逐渐掌握对话、推理、编程和工具调用之后,自主研究被视为人工智能领域的「The Next Big Thing」。
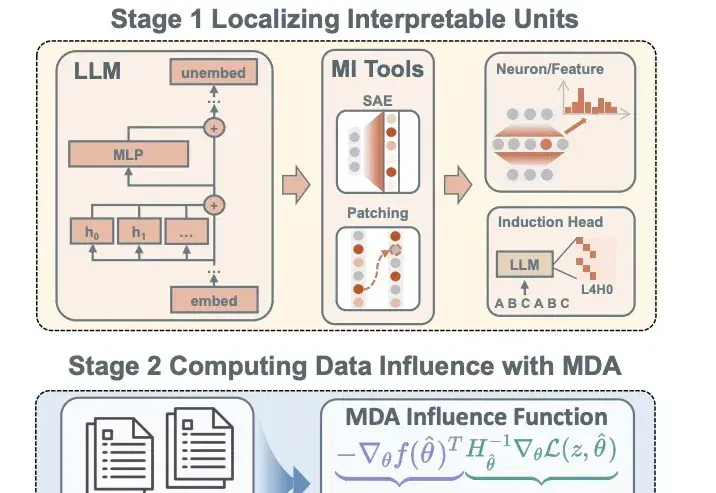
近年来,大语言模型展现出了越来越强的能力,从上下文学习(In-Context Learning, ICL)到复杂推理、代码生成,这些能力不断刷新人们对模型能力边界的认知。
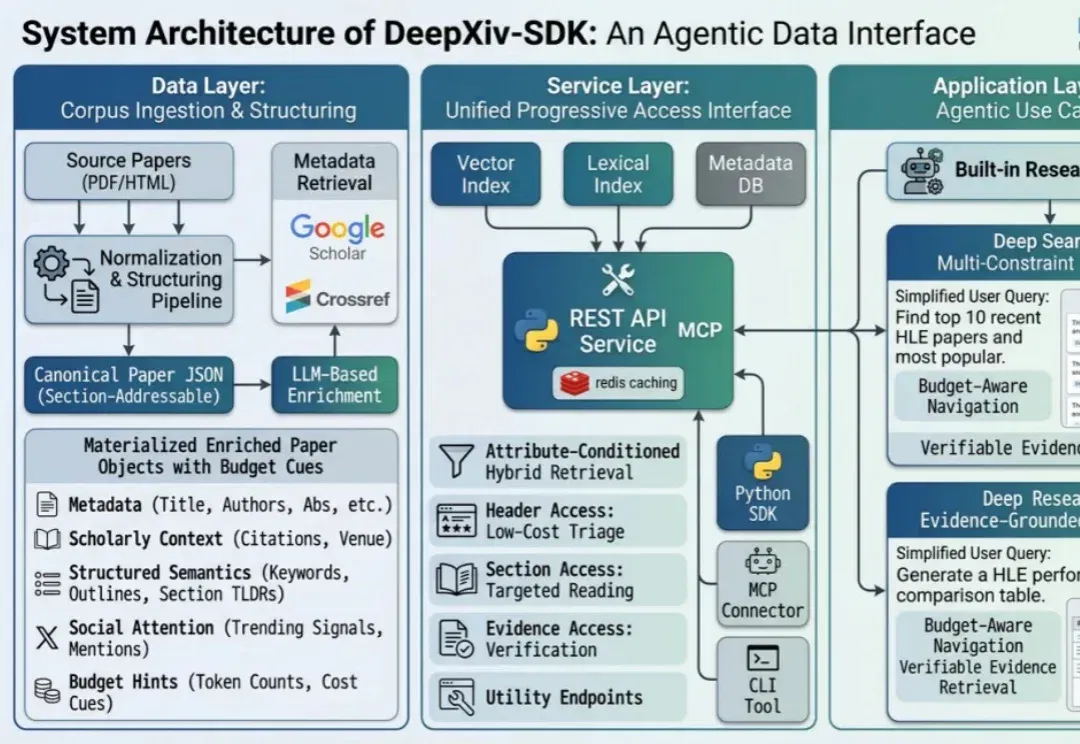
DeepXiv 是专为智能体设计的科技文献基础设施,把论文搜索、渐进式阅读、热点追踪和深度调研变成可调用、可编排、可自动化的能力。
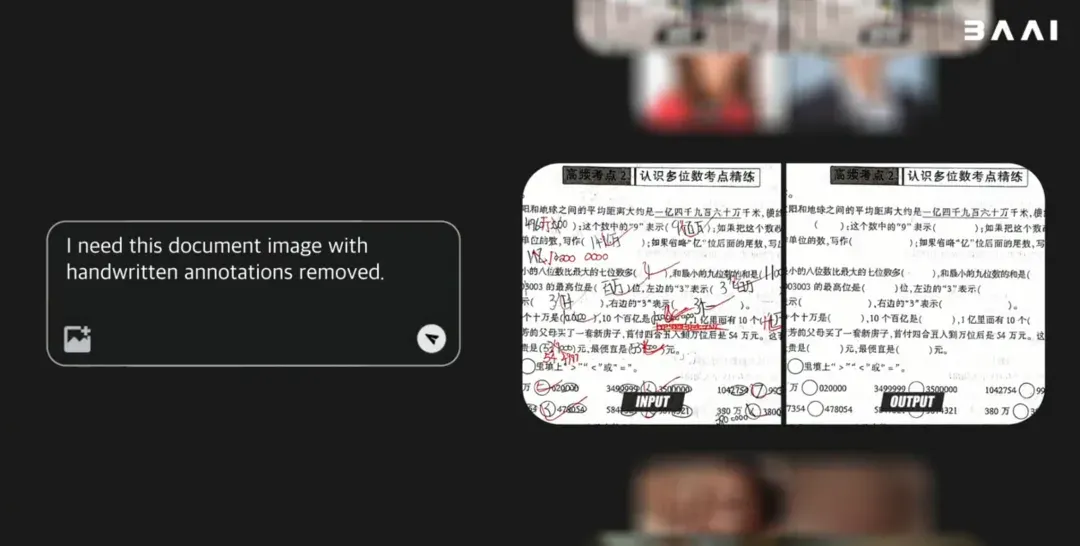
最新最强的开源原生多模态世界模型—— 北京智源人工智能研究院(BAAI)的悟界·Emu3.5来炸场了。 图、文、视频任务一网打尽,不仅能画图改图,还能生成图文教程,视频任务更是增加了物理真实性。
随着多模态大模型的不断演进,指令引导的图像编辑(Instruction-guided Image Editing)技术取得了显著进展。然而,现有模型在遵循复杂、精细的文本指令方面仍面临巨大挑战,往往需要用户进行多次尝试和手动筛选,难以实现稳定、高质量的「一步到位」式编辑。
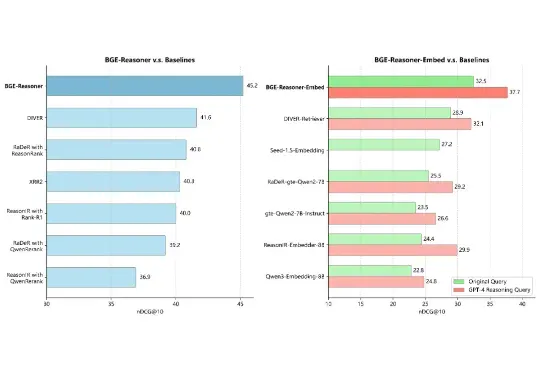
人工智能的浪潮正将我们推向一个由 RAG 和 AI Agent 定义的新时代。然而,要让这些智能体真正「智能」,而非仅仅是信息的搬运工,就必须攻克一个横亘在所有顶尖团队面前的核心难题。这个难题,就是推理密集型信息检索(Reasoning-Intensive IR)。