ICLR 2026 | 阿里高德发布SpatialGenEval,揭秘谁才是真正的文生图大师(在新窗口打开)
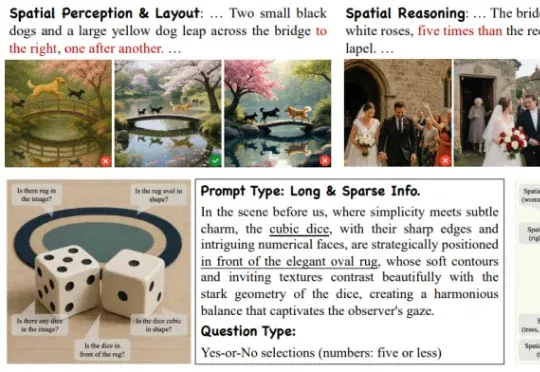
来自阿里高德的一篇最新 ICLR 2026 中稿论文《Everything in Its Place: Benchmarking Spatial Intelligence of Text-to-Image Models》提出了面向文生图空间智能的系统性评估基准 SpatialGenEval,旨在通过长文本、高信息密度的 T2I prompt 设计,以及围绕空间感知
共 43 篇
来自阿里高德的一篇最新 ICLR 2026 中稿论文《Everything in Its Place: Benchmarking Spatial Intelligence of Text-to-Image Models》提出了面向文生图空间智能的系统性评估基准 SpatialGenEval,旨在通过长文本、高信息密度的 T2I prompt 设计,以及围绕空间感知
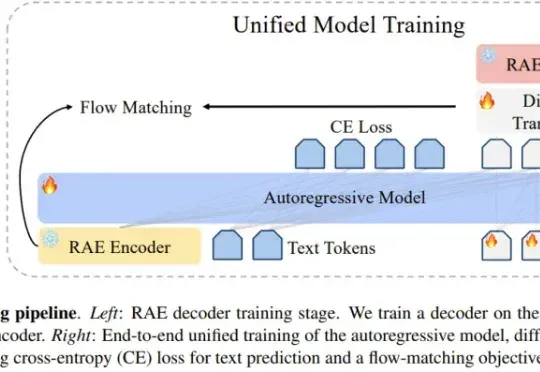
编辑|Panda 在文生图模型的技术版图中,VAE 几乎已经成为共识。从 Stable Diffusion 到 FLUX,再到一系列扩散 Transformer,主流路线高度一致:先用 VAE 压缩视
北邮最新综述探讨了文生图扩散模型的可控生成技术,总结了在文本条件之外引入新条件信号的方法,从任务和方法两个层面梳理了可控生成技术。
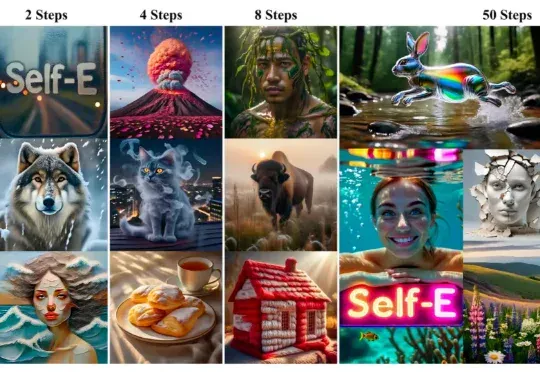
香港大学(The University of Hong Kong)与 Adobe Research 联合发布 Self-E(Self-Evaluating Model):一种无需预训练教师蒸馏、从零开始训练的任意步数文生图框架。其目标非常直接:让同一个模型在极少步数也能生成语义清晰、结构稳定的图像,同时在 50 步等常规设置下保持顶级质量,并且随着步数增加呈现单调提升。
刚刚,豆包·图像创作模型Seedream 4.0同时登顶「文生图」和「图像编辑」两项榜单!相比Nano Banana,Seedream 4.0在文生图的清晰度和美感上优势较为明显;在图像编辑上则难分伯仲,仅小幅领先。
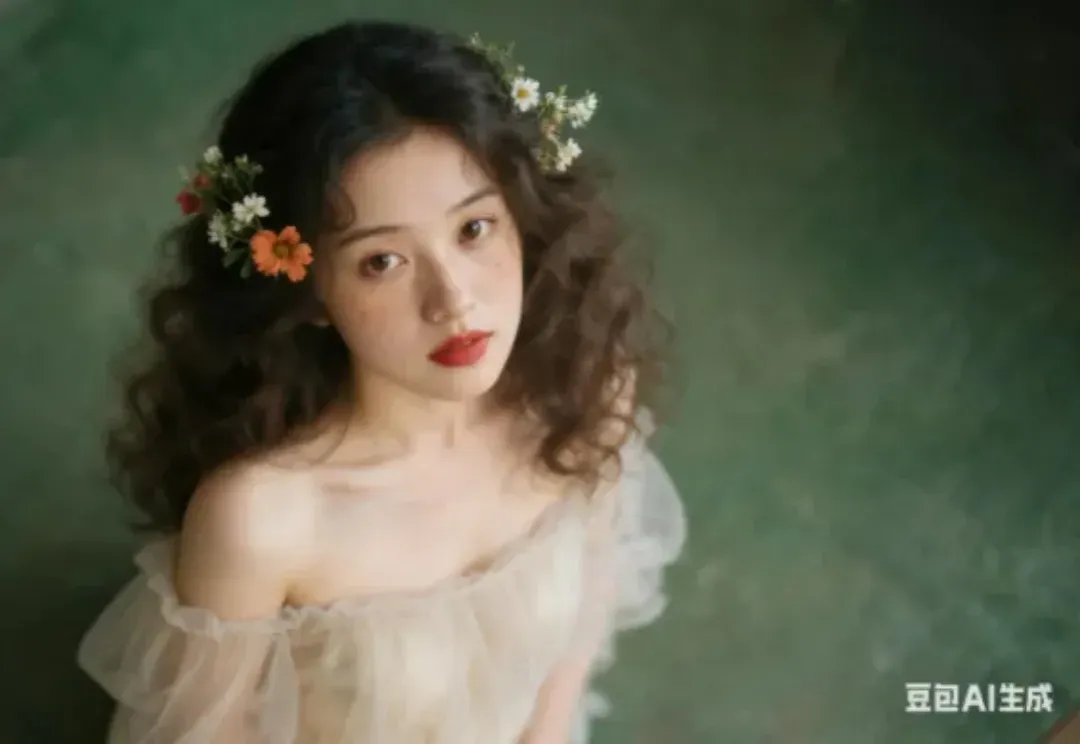
打开多模态自由创作的大门。 谷歌 Nano Banana 掀起的全球创作狂欢尚未消退之际,字节又玩了把大的。 近日,字节跳动开始内测最新的豆包・图像创作模型 Seedream 4.0。与此前版本相比,Seedream 4.0 首次支持多模态生图,同一模型可以实现文生图、图像编辑、组图生成,并在核心能力上迎来了显著提升: 主体一致性增强:无论是文本驱动还是图像驱动,都能稳健保持主体特征,避免「失真」与「错位」。 提示词:将平视视角改为俯视视角,将近景改为中景,并把画面比例改为 16:9。 多图灵活创作:支持文本、图像的多维组合输入,轻松实现参考生成、融合生成与编辑。 提示词:根据参考图中两个男生
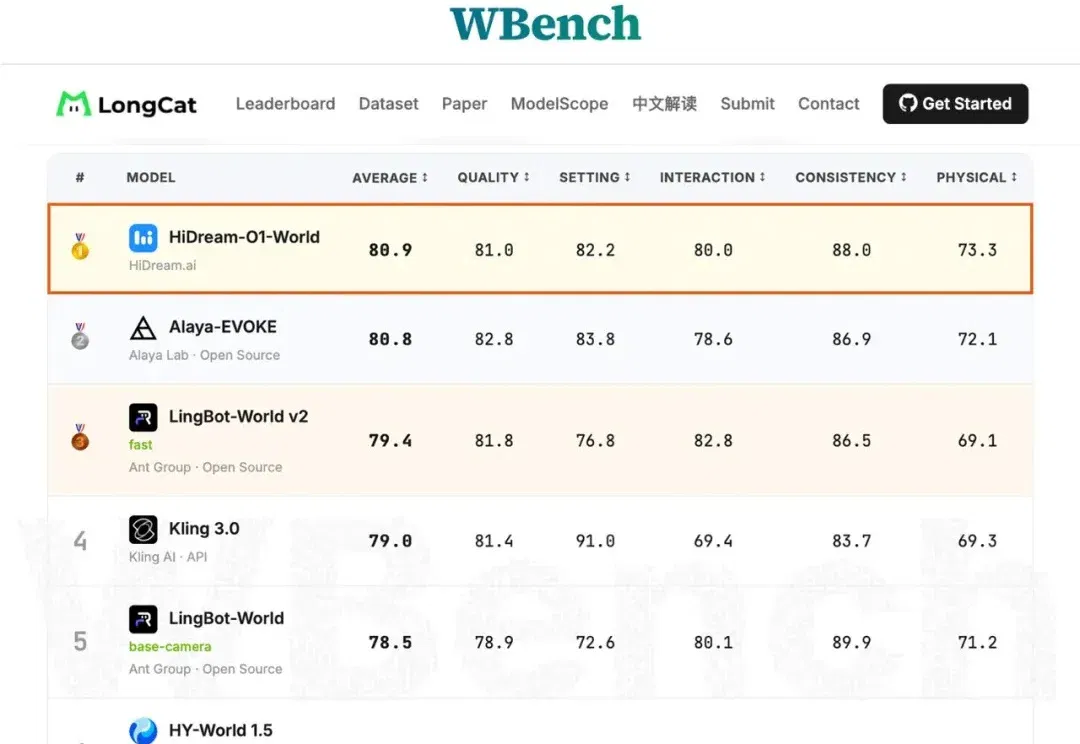
过去三年,AI 内容生成行业经历了几轮密集的技术迭代。从文生图到文生视频,从几秒的短片到分钟级的长视频,每一轮升级都让生成内容的质量和时长向前推进一步。
回顾 2025 年,如果问普通人对 AI 行业最深刻的印象是什么?答案依然是激烈的“参数战争”:有 DeepSeek、Gemini 3 等大模型的集体爆发,也有文生图、文生视频能力的持续惊艳。
当AI模型排行榜开始被各种刷分作弊之后,谁家大模型最牛这个问题就变得非常主观,直到一家线上排行榜诞生,它叫:LMArena。在文字、视觉、搜索、文生图、文生视频等不同的AI大模型细分领域,LMArena上每天都有上千场的实时对战,由普通用户来匿名投票选出哪一方的回答更好。
H3-Image 支持文生图、参考图生成及编辑。MiniMax 公布了 4K 输出与最多 16 张参考图的能力,权重使用受其社区许可证约束。