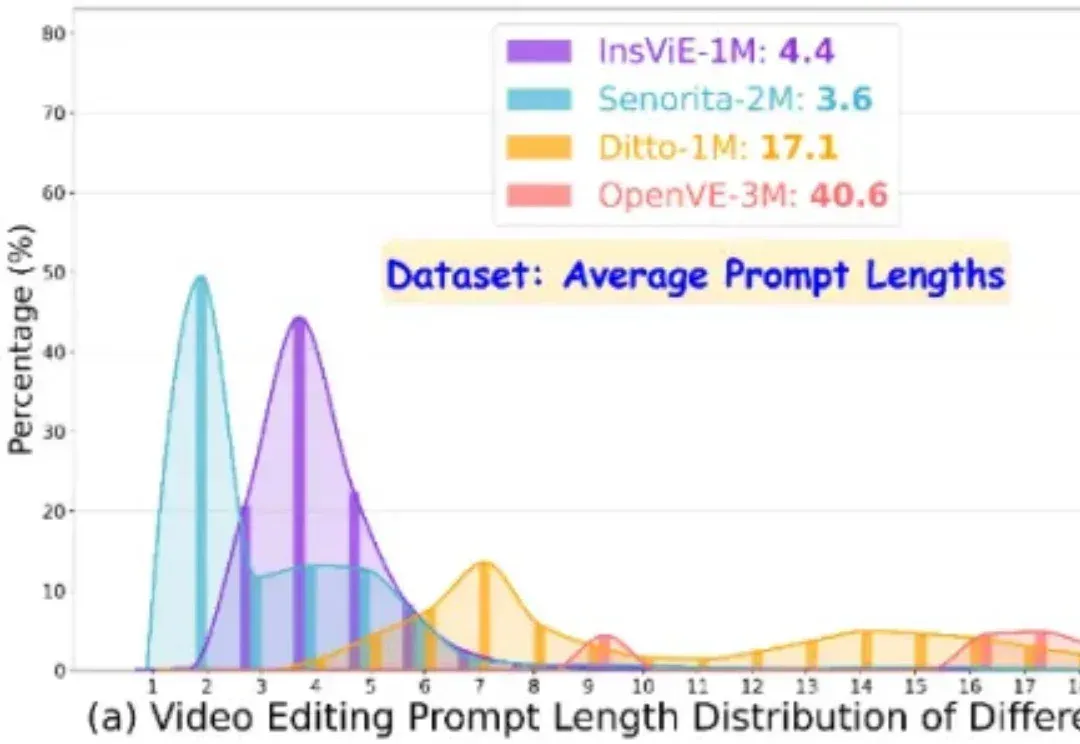
浙大联手字节:开源大规模指令跟随视频编辑数据集OpenVE-3M(在新窗口打开)
作者提出了一个大规模、高质量、多类别的指令跟随的视频编辑数据集 OpenVE-3M,共包含 3M 样本对,分为空间对齐和非空间对齐 2 大类别共 8 小类别。
共 74 篇
作者提出了一个大规模、高质量、多类别的指令跟随的视频编辑数据集 OpenVE-3M,共包含 3M 样本对,分为空间对齐和非空间对齐 2 大类别共 8 小类别。
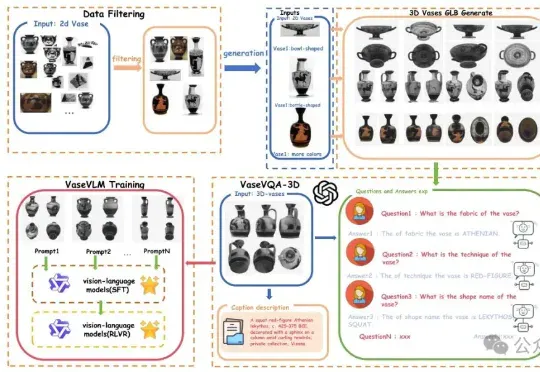
现在AI都懂文物懂历史了。一项来自北京大学的最新研究引发关注:他们推出了全球首个面向古希腊陶罐的3D视觉问答数据集——VaseVQA-3D,并配套推出了专用视觉语言模型VaseVLM。这意味着,AI正在从“识图机器”迈向“文化考古Agent”。
复旦大学NLP实验室研发Game-RL,利用游戏丰富视觉元素和明确规则生成多模态可验证推理数据,通过强化训练提升视觉语言模型的推理能力。创新性地提出Code2Logic方法,系统化合成游戏任务数据,构建GameQA数据集,验证了游戏数据在复杂推理训练中的优势。
谷歌DeepMind研究团队一年前的研究成果直到昨晚才姗姗揭秘,提出了一种叫做GDR的新方法,颠覆了传统训练中设法剔除脏数据的思路,将饱含恶意内容的数据「变废为宝」,处理后的数据集用于训练,甚至比直接剔除脏数据训练出的模型效果还好,「出淤泥而不染」,「择善而从」。
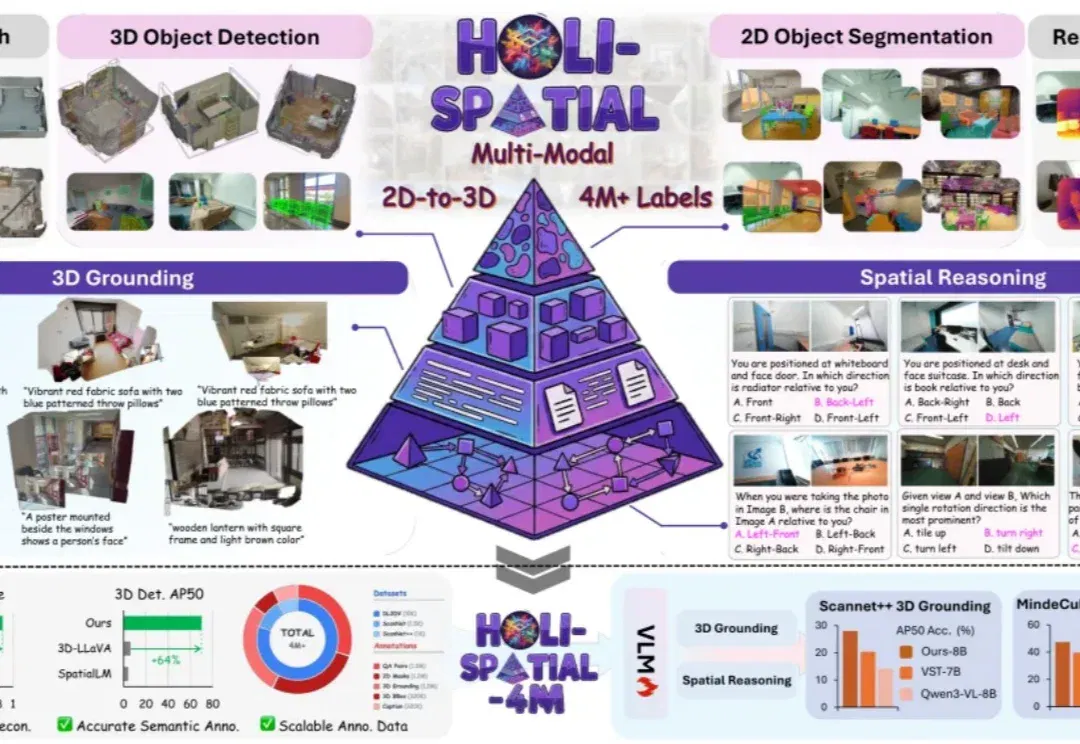
从原始视频出发,无需人工介入,自动生成 3D 重建、深度、2D mask、3D 框、实例描述、3D grounding 和空间问答。Holi-Spatial 试图把「空间智能」的数据生产,推进到自动化、可扩展的新阶段。
4 月 10 日晚,灵初智能发布了大模型、数据集与合作计划:包括策略模型 Psi-R2、世界模型 Psi-W0,以及总规模近 10 万小时的人类操作数据。它想回答的问题也很直接 —— 当真机数据不再是唯一解,机器人还能靠什么继续 scaling?
迅策介绍 TokenRouters 的数据集、模型、应用和场景资源匹配思路,并结合 PCB 质检等案例讨论数据治理与企业小模型部署。文中的专用 Token 交换、审计和商业模式属于公司方案,具体效果需结合场景验证。
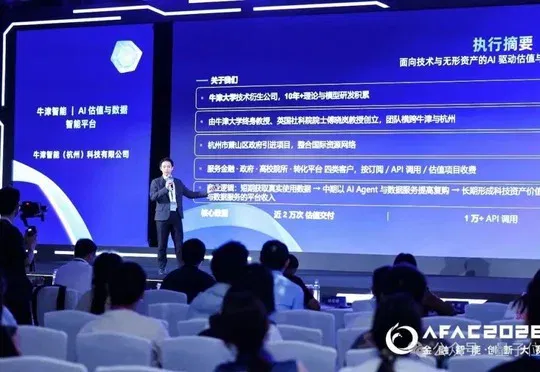
AFAC2026金融智能创新大赛总决赛落幕,全球5027支队伍近2万名选手参赛,主办方联合30余家机构推出四道贴近真实金融场景的赛题,并正式发布覆盖13万条评测样本的"AFAC百万金融智能数据集"实现百亿级金融科技数据开源。
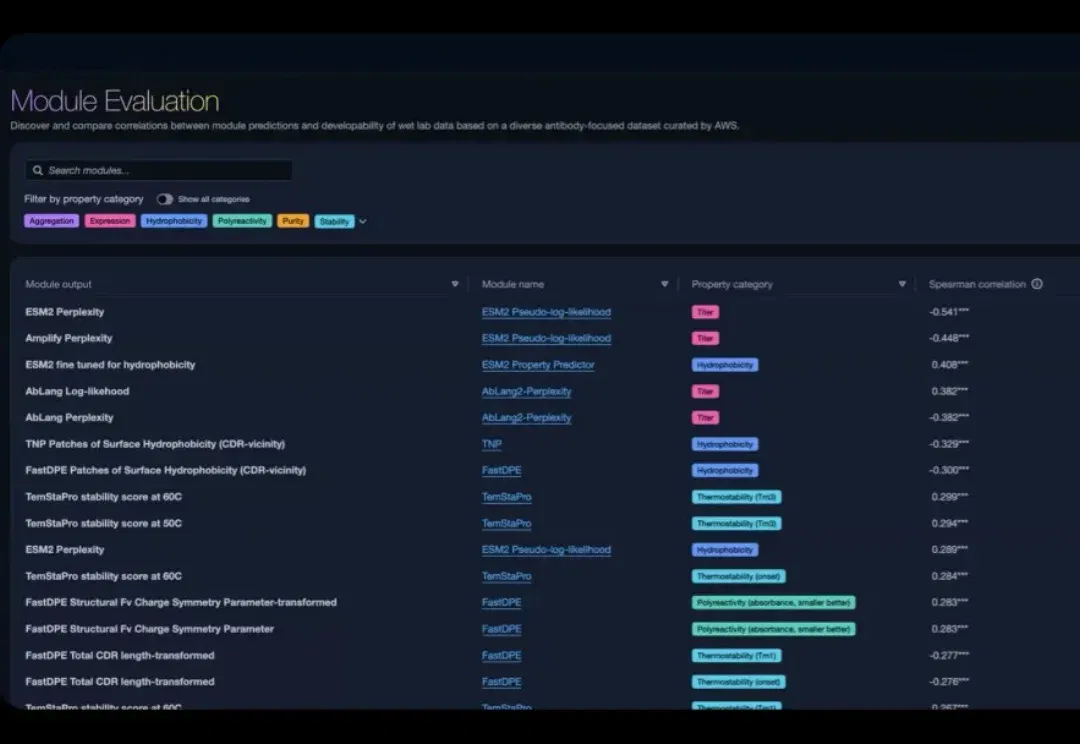
巨头亚马逊,也深度入局生命科学了。 就在今天(美东4月14日),亚马逊正式推出Amazon Bio Discovery。 这是一款专为生命科学设计的AI智能体,重点面向早期药物发现。 它集成了超过40个行业顶级生物医药大模型,用于生成和评估潜在的药物分子,为科研人员提供一站式干湿试验闭环平台,将候选药物从计算筛选到实验室测试的整个流程缩短至数周。 同一天,亚马逊与顶级医疗大学约翰斯·霍普金学院共同发布,全球AI抗体设计数据库。 该数据库是行业最大、最多样化的AI抗体数据集,涵盖50种种子抗体、4种结构格式和42种抗原,多样性是现有公开库的20倍。 亚马逊布局AI Agent+药物研发,这个时间
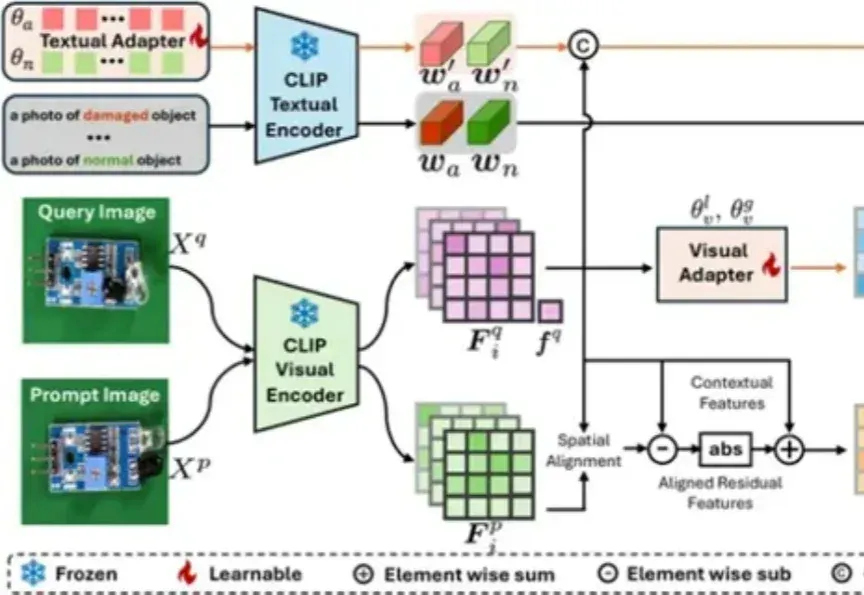
视觉模型用于工业“缺陷检测”等领域已经相对成熟,但当前普遍使用的传统模型在训练时对数据要求较高,需要大量的经过精细标注的数据才能训练出理想效果。