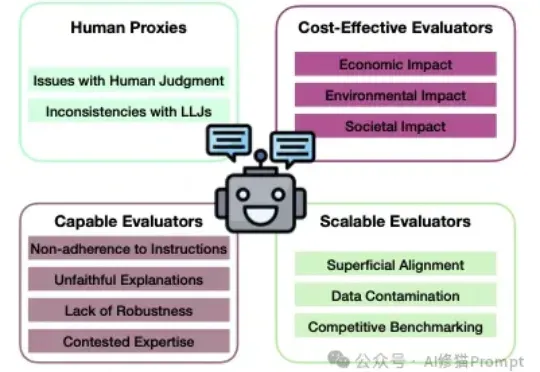
你的怀疑是对的!LLM作为Judge,既无效又不可靠,终于有论文向LLJ开炮了(在新窗口打开)让LMM作为Judge,从对模型的性能评估到数据标注再到模型的训练和对齐流程,让AI来评判AI,这种模式几乎已经是当前学术界和工业界的常态。