搜索

关于“扩散模型”的结果

共 85 篇

清华、NVIDIA、斯坦福提出DiffusionNFT:基于前向过程的扩散强化学习新范式,训练效率提升25倍

清华、NVIDIA、斯坦福提出DiffusionNFT:基于前向过程的扩散强化学习新范式,训练效率提升25倍(在新窗口打开)

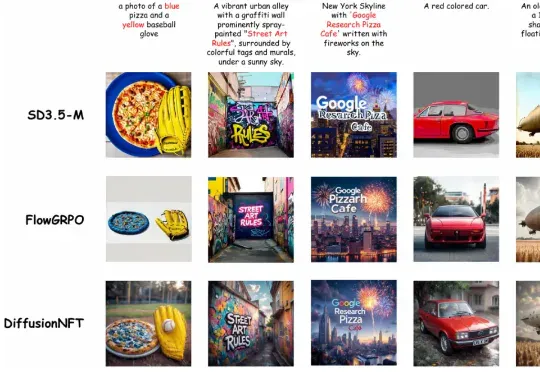
清华大学朱军教授团队,NVIDIA Deep Imagination 研究组与斯坦福 Stefano Ermon 团队联合提出了一种全新的扩散模型强化学习(RL)范式 ——Diffusion Negative-aware FineTuning (DiffusionNFT)。该方法首次突破现有 RL 对扩散模型的基本假设,直接在前向加噪过程(forward process)上进行优化
AI技术文章
0
大道至简,何恺明团队新作pMF开启像素级「无潜、单步」生成范式

大道至简,何恺明团队新作pMF开启像素级「无潜、单步」生成范式(在新窗口打开)

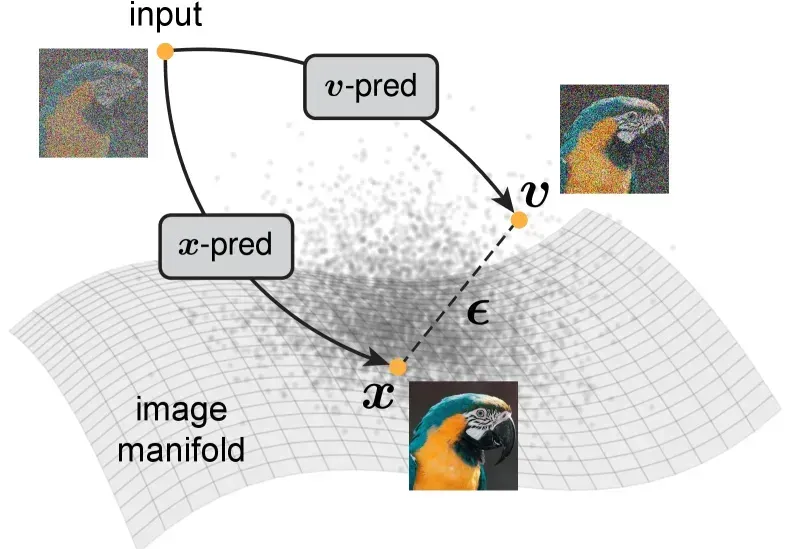
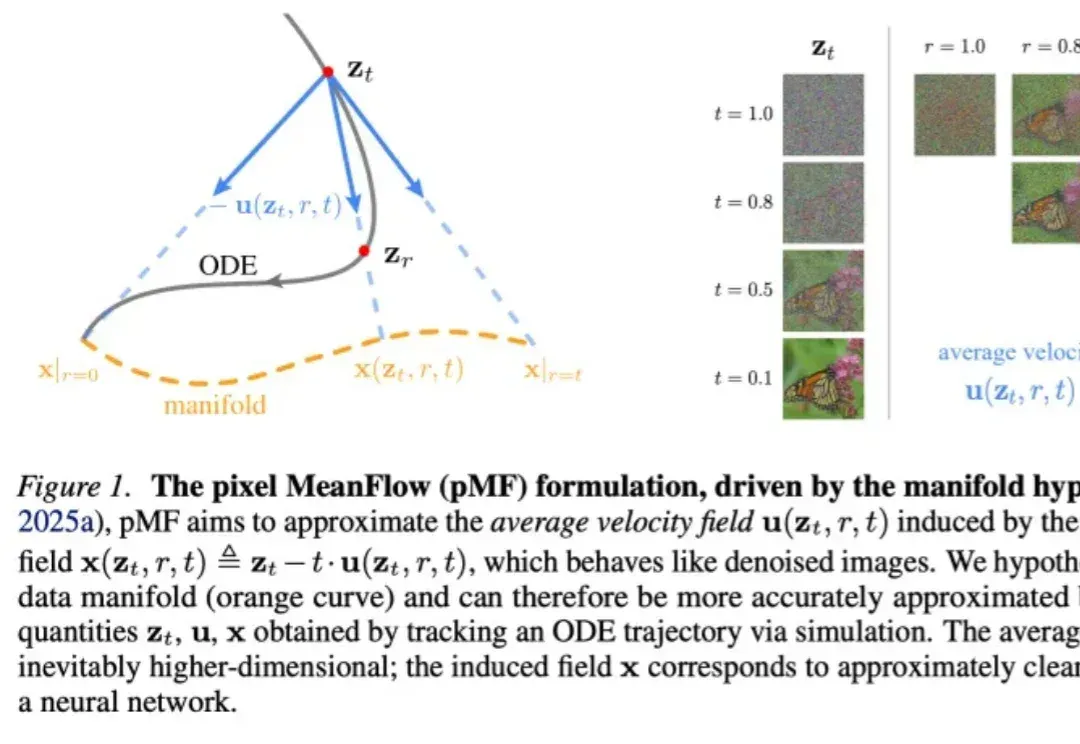
何恺明团队新论文,再次「大道至简」。 此次研究直指当前以 DiT 为代表的主流扩散模型与流匹配模型存在的通病,并提出了一种用于单步、无潜空间(Latent-free)的图像生成新框架。 论文标题:One-step Latent-free Image Generation with Pixel Mean FlowsarXiv 地址:https://arxiv.org/pdf/2601.22158v1 在生成式 AI 领域,追求更高效、更直接的生成范式一直是学界的核心目标。 当前,以 DiT 为代表的主流扩散模型与流匹配模型主要依赖两大支柱来降低生成难度,一是通过多步采样将复杂的分布转换分解为微小

AI技术文章
0
NeurIPS 2025 Spotlight | 中国联通以全局优化重塑扩散模型加速

NeurIPS 2025 Spotlight | 中国联通以全局优化重塑扩散模型加速(在新窗口打开)

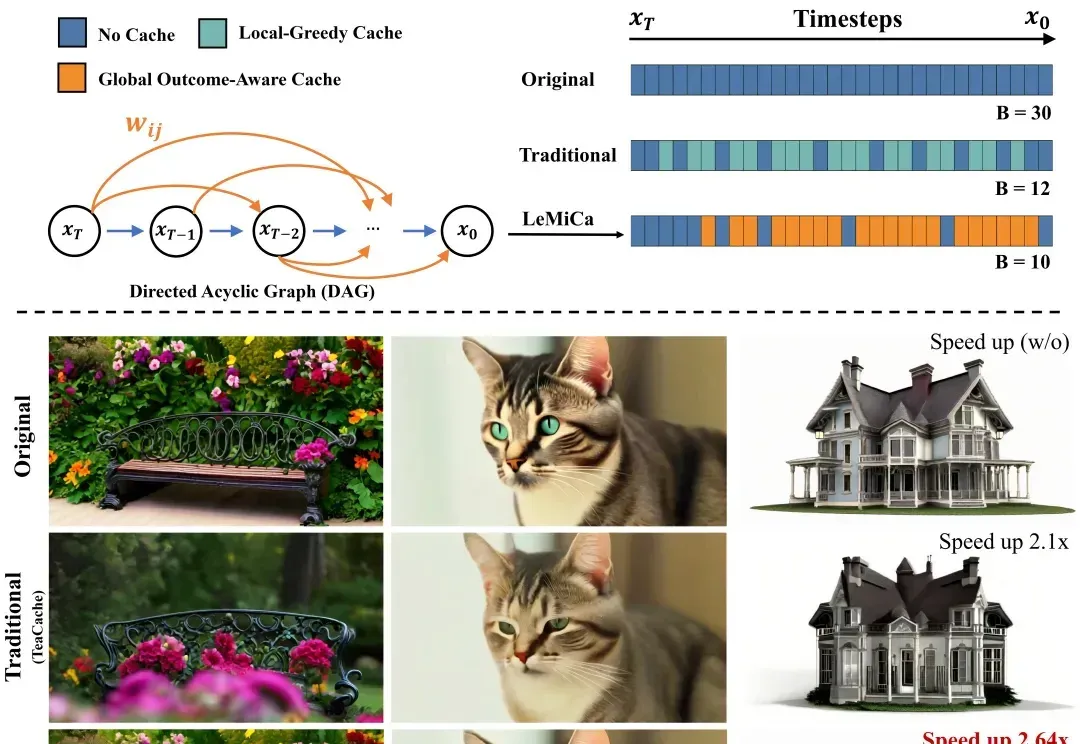
当前,视频生成模型性能正在快速提升,尤其是基于Transformer架构的DiT模型,在视频生成领域的表现已经逐渐接近真实拍摄效果。然而,这些扩散模型也面临一个共同的瓶颈:推理时间长、算力成本高、生成速度难以提升。随着视频生成长度持续增加、分辨率不断提高,这个瓶颈正在成为影响视频创作体验的主要障碍之一。

AI技术文章
0
兼得快与好!训练新范式TiM,原生支持FSDP+Flash Attention

兼得快与好!训练新范式TiM,原生支持FSDP+Flash Attention(在新窗口打开)

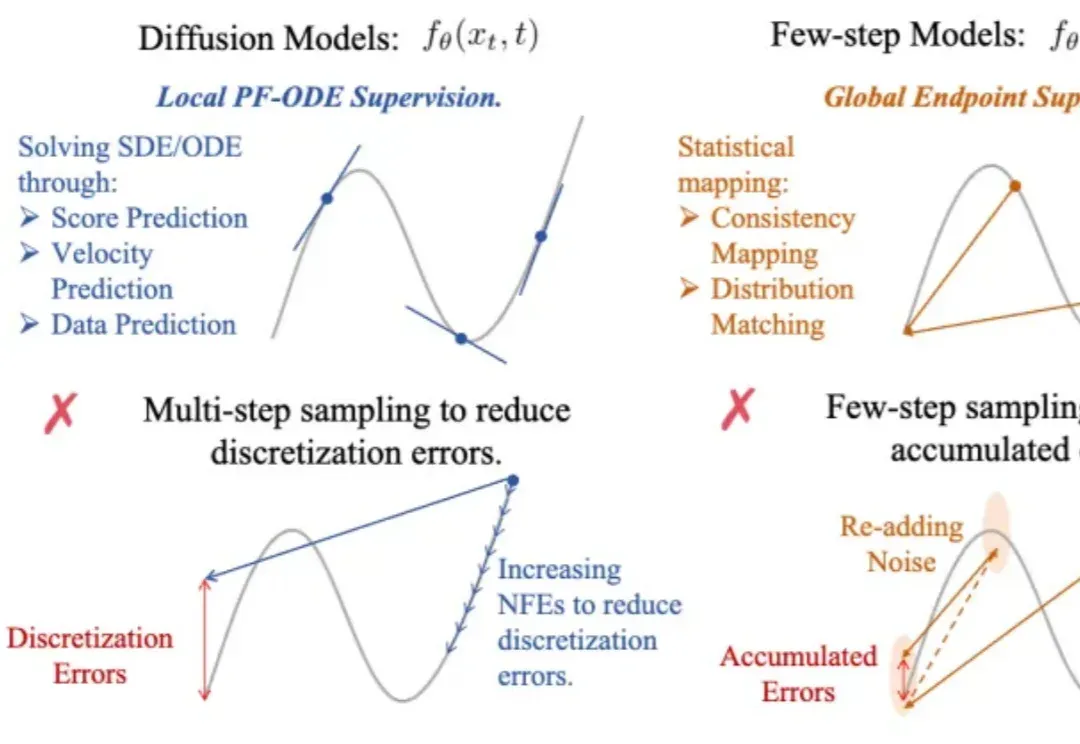
生成式AI的快与好,终于能兼得了? 从Stable Diffusion到DiT、FLUX系列,社区探索了很多技术方法用于加速生成速度和提高生成质量,但是始终围绕扩散模型和Few-step模型两条路线进行开发,不得不向一些固有的缺陷妥协。 这便是训练目标引发的“生成质量”与“生成速度”之间的矛盾根源: 要么只监督无穷小局部动力学(PF-ODE),要么只学习有限区间的端点映射,两者都各有内在限制。 一项新研究提出了名为Transition Model(TiM)的新范式,试图从根本上解决这一矛盾。 它放弃了传统扩散模型学习“瞬时速度场”或Few-step模型学习“端点映射”的做法,转而直接建模任意两

AI技术文章
0
ICLR 2026 | 把视频扩散模型压到4bit,还能接近满血效果? QVGen让「超低比特视频生成量化」真正可用

ICLR 2026 | 把视频扩散模型压到4bit,还能接近满血效果? QVGen让「超低比特视频生成量化」真正可用(在新窗口打开)

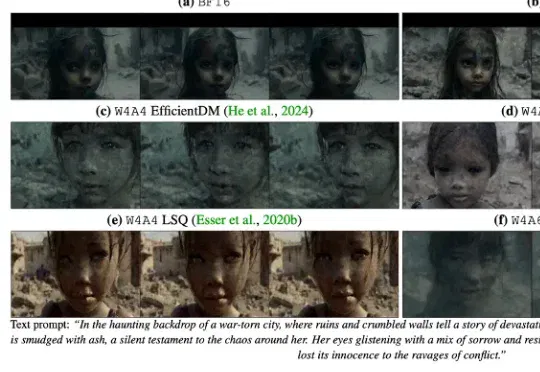
香港科技大学 & 北航 & 商汤等提出了一个专门面向视频生成扩散模型的 QAT 范式 ——QVGen,在 3-bit / 4-bit 都能把质量拉回来,并且让 4-bit 首次接近全精度表现成为现实。该论文现已被 ICLR 高分接收:rebuttal 前 88666(top 1.4%),rebuttal 后 88886 (top 0.5%)。

AI技术文章
0