搜索

关于“强化学习”的结果

共 198 篇

斯坦福英伟达推出测试时强化学习:微调开源模型胜过顶级闭源模型,仅需几百美元

斯坦福英伟达推出测试时强化学习:微调开源模型胜过顶级闭源模型,仅需几百美元(在新窗口打开)

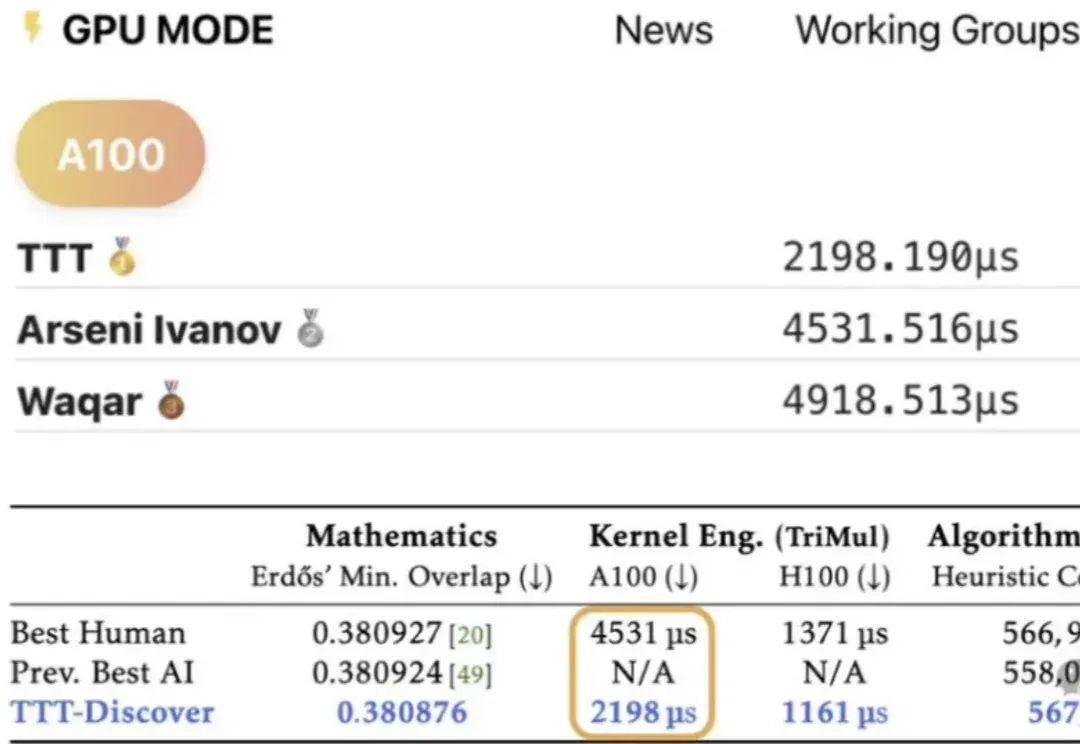
大模型持续学习,又有新进展! 来自斯坦福、英伟达等研究机构的最新研究,针对解决开放的科学问题,提出全新思路—— Test-Time Training to Discover (TTT-Discover)。 其基于开源模型gpt-oss-120b,在多个领域达到SOTA,优于人类专家与闭源前沿模型。 该方法不再沿用“测试时缩放”(Test-time Scaling)只通过Prompt调度冻结模型的做法。 而是在测试阶段,针对单个具体问题,引入强化学习(RL)对模型权重进行更新。 这种“测试时训练”使模型能够从该问题的失败尝试中实时获取经验,更新参数,实现模型能力的定向进化。 数学:给出了Erdő
AI技术文章
0
强化学习之父给LLM判死刑!站队LeCun:我们全搞错了

强化学习之父给LLM判死刑!站队LeCun:我们全搞错了(在新窗口打开)

当全世界都在狂热追逐大模型时,强化学习之父、图灵奖得主Richard Sutton却直言:大语言模型是「死胡同」。在他看来,真正的智能必须源于经验学习,而不是模仿人类语言的「预测游戏」。这番话无异于当头一棒,让人重新思考:我们追逐的所谓智能,究竟是幻影,还是通向未来的歧路?

AI资讯
0
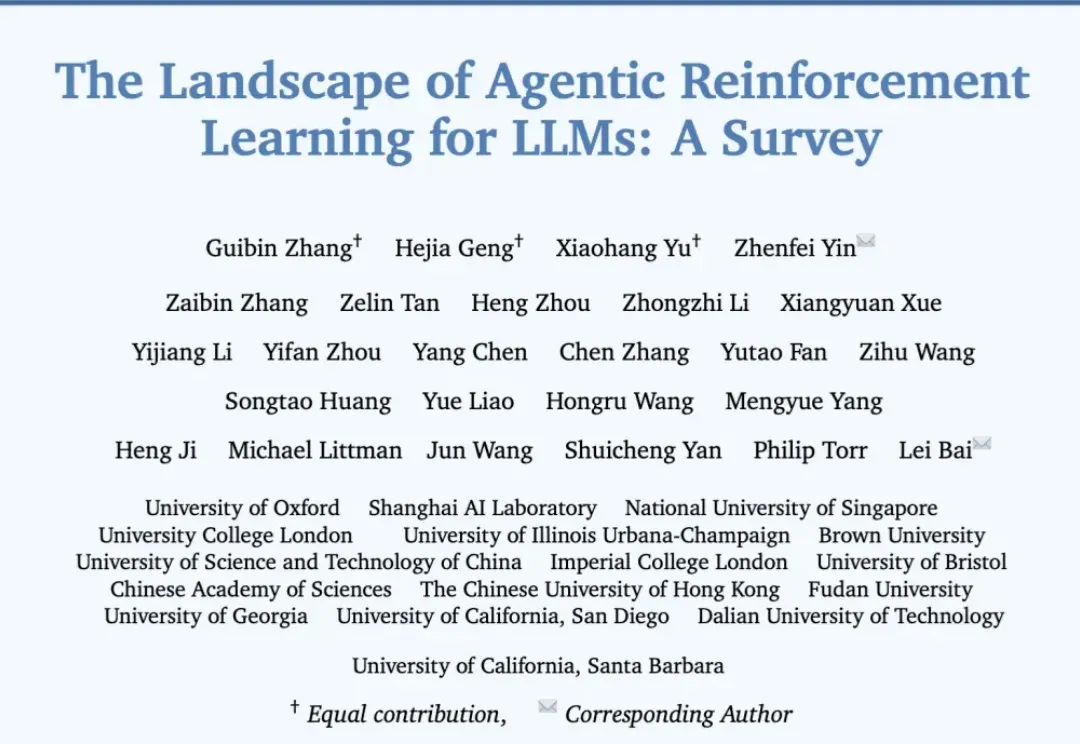
从「会说」迈向「会做」,LLM下半场:Agentic强化学习范式综述

从「会说」迈向「会做」,LLM下半场:Agentic强化学习范式综述(在新窗口打开)

过去几年,大语言模型(LLM)的训练大多依赖于基于人类或数据偏好的强化学习(Preference-based Reinforcement Fine-tuning, PBRFT):输入提示、输出文本、获得一个偏好分数。这一范式催生了 GPT-4、Llama-3 等成功的早期大模型,但局限也日益明显:缺乏长期规划、环境交互与持续学习能力。

AI技术文章
0
日榜第二!北大开源,强化学习数据策略接入更简单、对比更公平

日榜第二!北大开源,强化学习数据策略接入更简单、对比更公平(在新窗口打开)

这个问题正随着推理模型和 RLVR 的发展变得更加重要。随着强化学习在大模型后训练中的作用不断增强,模型练什么、怎么练,也需要更仔细地安排。为了解决数据策略接入和效果比较中的麻烦问题,北大DCAI团队联合UCAS、上海算法创新研究院、中关村学院最新发布DataFlex-RL。

AI技术文章
0