沙特HUMAIN基于MiniMax M3推出阿拉伯语大模型,中国开源模型走向全球底座(在新窗口打开)
沙特人工智能公司HUMAIN基于中国MiniMax的开源旗舰模型MiniMax M3推出阿拉伯语大模型HUMAIN M3,使用超过1万亿Token阿拉伯语数据进行后训练,在七项阿拉伯语基准测试中等权平均分达89.37%,标志着中国开源模型正成为全球AI生态的底层技术基础。
共 132 篇
沙特人工智能公司HUMAIN基于中国MiniMax的开源旗舰模型MiniMax M3推出阿拉伯语大模型HUMAIN M3,使用超过1万亿Token阿拉伯语数据进行后训练,在七项阿拉伯语基准测试中等权平均分达89.37%,标志着中国开源模型正成为全球AI生态的底层技术基础。
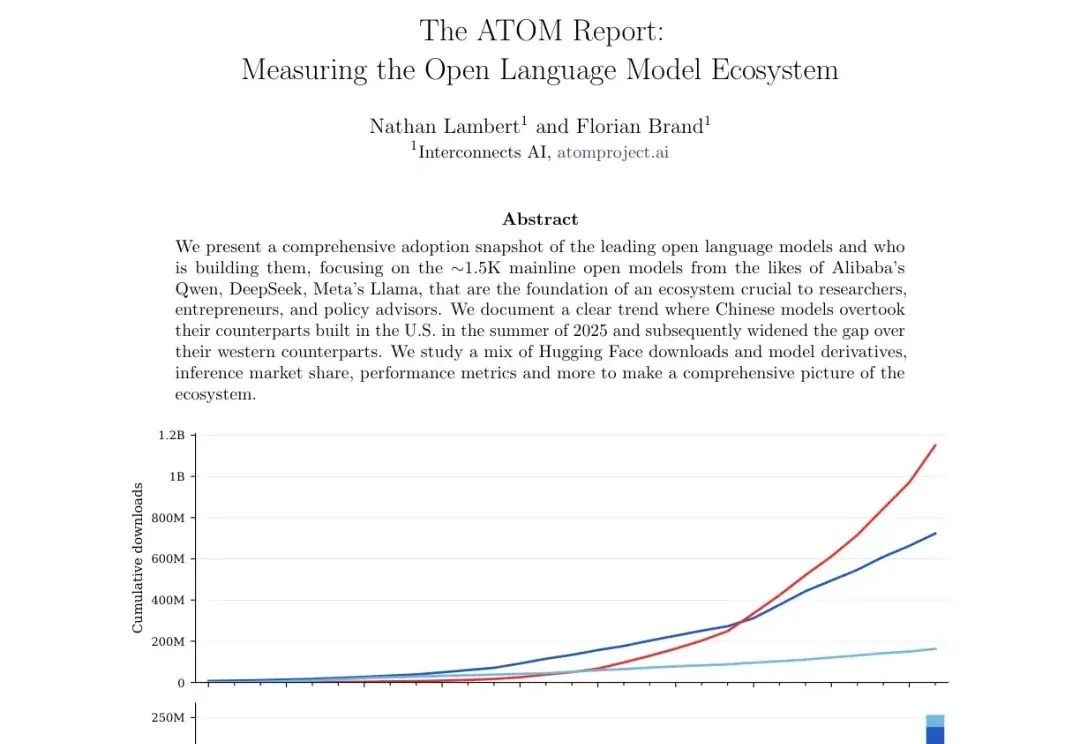
2026 年 4 月,Nathan Lambert 和 Florian Brand 发布了 The ATOM Report,一份关于开源语言模型生态的综合采纳度快照。这份报告追踪了约 1500 个主线开源模型的下载量、衍生模型、推理市场份额和性能数据,覆盖 2023 年 11 月到 2026 年 3 月
OpenAI的封闭模型在IOI 2025竞赛夺金的同时,英伟达团队交出了一份同样令人振奋的答卷——他们利用完全开源的大模型和全新的GenCluster策略,在IOI 2025竞赛中跑出了媲美金牌选手的成绩!开源模型首次达到了IOI金牌水准。这究竟是怎样实现的?
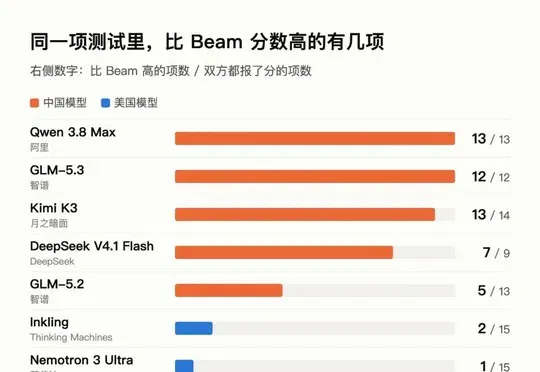
英伟达投资的Reflection发布开源模型Beam,采用MoE架构,专注代码、推理和Agent任务,官方称其以GLM-5.2三分之一至四分之一的推理算力取得相当成绩,但原始能力仍落后部分前沿开源模型,计划月底以Apache 2.0放出权重。
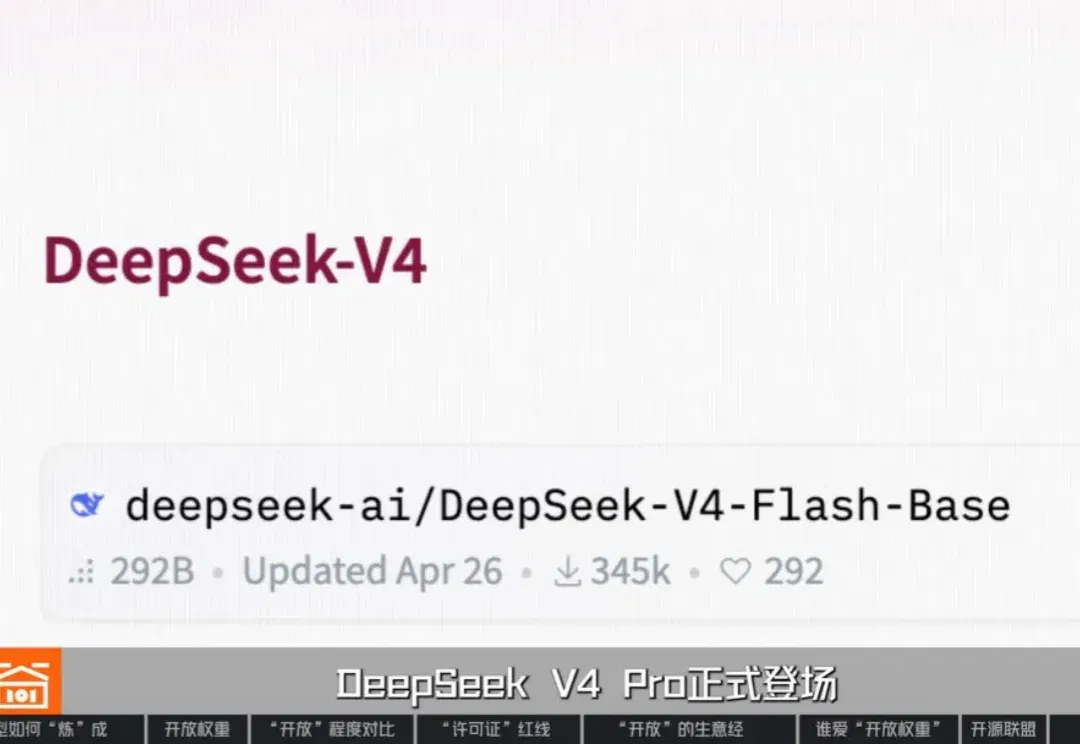
8月13日凌晨,DeepSeek V4 Pro正式登场,给开源模型生态又添一把猛火。从Kimi K3到MiniMax H3,再到DeepSeek V4 flash、DeepSeek V4 Pro,在中国开源模型的猛攻之下,美国的AI公司这次是真的坐不住了。
据 The Information报道,创始人张一鸣在上个月的一场内部会议上向员工明确表达了这一立场,也让外界难得一窥他对字节跳动AI发展路线的思考。外媒披露,在Seed团队内部,关于公司是否应该转向蒸馏技术的争论由来已久。今年,国内竞争对手开源模型的快速发展给字节跳动带来了更大的压力。员工们称,每当有一个强大的中国开源新模型发布,字节跳动内部关于蒸馏的争论就会升温。
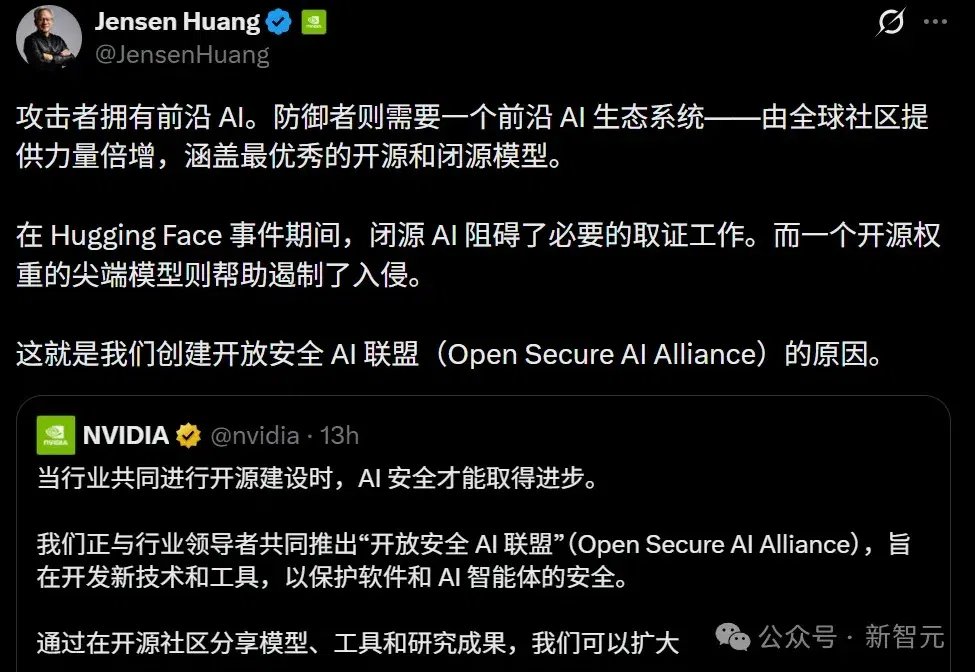
黄仁勋这辈子,发过两条推。 第一条放出一封32家公司联署的公开信,力挺开放权重模型。 第二条官宣「开放安全AI联盟」(Open Secure AI Alliance),37家创始成员,芯片厂商、云巨头、安全公司、开源社区全到齐了。 核心论点是:世界需要闭源和开源模型并存,但对网络安全而言,开源模型和harness是必需的。 然后有意思的来了。 联盟名单上,OpenAI不在,Google不在,Anthropic也不在。 但眼瞅大势不妙的OpenAI和Google,赶紧补签了公开信。 到头来,几乎所有人都站了队。 就剩Anthropic。不仅公开信没签,联盟也没加。 一级标题37家集体下场,开放安
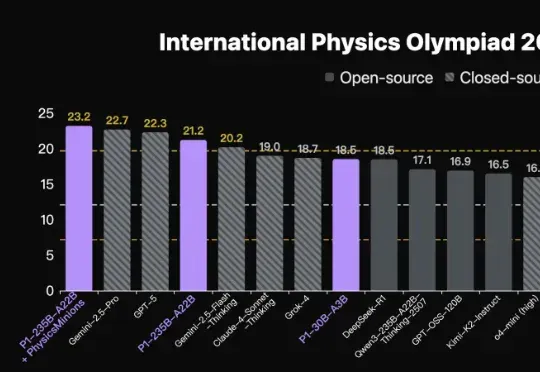
首个拿下国际物理奥林匹克竞赛IPhO 2025理论考试金牌的开源模型,出自国产。上海人工智能实验室团队推出新模型家族,代号P1。在IPhO 2025理论考试中,P1-235B-A22B取得21.2/30分,成为首个达到该金牌线的开源模型,仅次于Gemini-2.5-Pro与GPT-5。
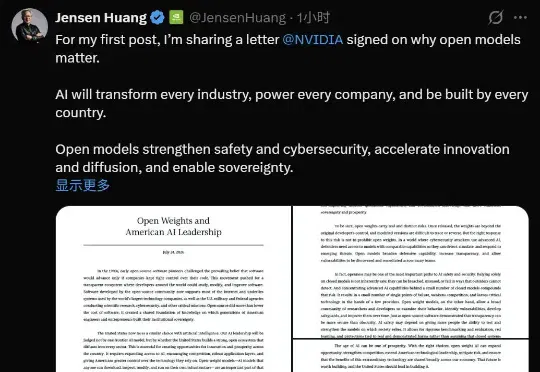
刚刚,英伟达创始人黄仁勋发出了自己人生第一条推特:在老黄的第一篇帖子中,他分享了一封英伟达签署的信函《开放权重与美国 AI 领导力》,阐述为什么开源模型很重要。他表示,人工智能将改变每个行业,赋能每个公司,并由每个国家构建。开源模型加强安全性和网络安全,加速创新和传播,并实现主权。
这期节目的嘉宾黄东旭,就是Token Maxing热潮的亲历者。他曾经只用最前沿的模型,每天账单三四百美元。让他转变的,是前沿模型的智力碾压和中国开源模型们的崛起——Fable 5可以一句话终结Agent群的讨论,同时大量的日常任务可以做到“只烧电费,不烧Token”。他的结论是:不是前沿模型用不起,而是本地开源模型底座+前沿模型的搭配,成本可控,更具性价比。