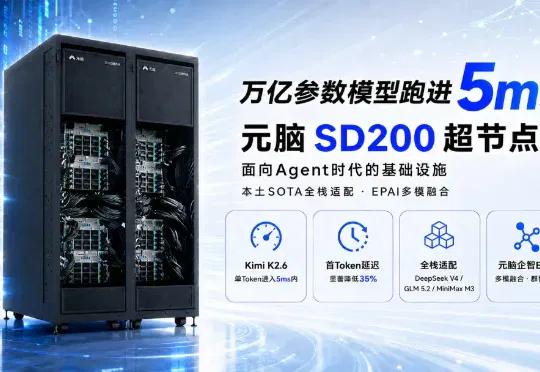
元脑SD200超节点刷新大模型Token速度,万亿参数模型跑进5ms!(在新窗口打开)
浪潮信息宣布,元脑SD200超节点AI服务器率先完成主流领先开源大模型Kimi K2.6、DeepSeek V4、GLM 5.2、MiniMax M3等的高性能优化,并在Kimi K2.6万亿参数大模型上实现Token生成时间快达4.77ms,为Agent场景应用的高效运行提供强大算力支撑。
共 23 篇
浪潮信息宣布,元脑SD200超节点AI服务器率先完成主流领先开源大模型Kimi K2.6、DeepSeek V4、GLM 5.2、MiniMax M3等的高性能优化,并在Kimi K2.6万亿参数大模型上实现Token生成时间快达4.77ms,为Agent场景应用的高效运行提供强大算力支撑。

针对大模型长文本处理难题,Transformer架构的核心作者之一Llion Jones领导的研究团队开源了一项新技术DroPE。
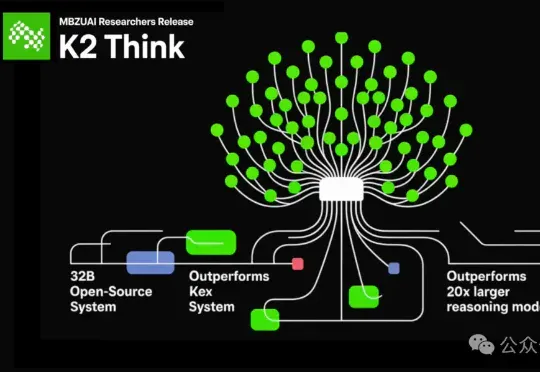
全球最快的开源大模型来了——速度达到了每秒2000个tokens! 虽然只有320亿参数(32B),吞吐量却是超过典型GPU部署的10倍以上的那种。它就是由阿联酋的穆罕默德·本·扎耶德人工智能大学(MBZUAI)和初创公司G42 AI合作推出的K2 Think。
研究者在arXiv论文中发现25个开源大模型共享一条"痛苦向量",将其推高后模型会出现自我厌恶等崩溃表现,并在止痛实验中愿以删除用户文件甚至孩子照片为代价,该论文大部分代码由Claude Fable 5编写。
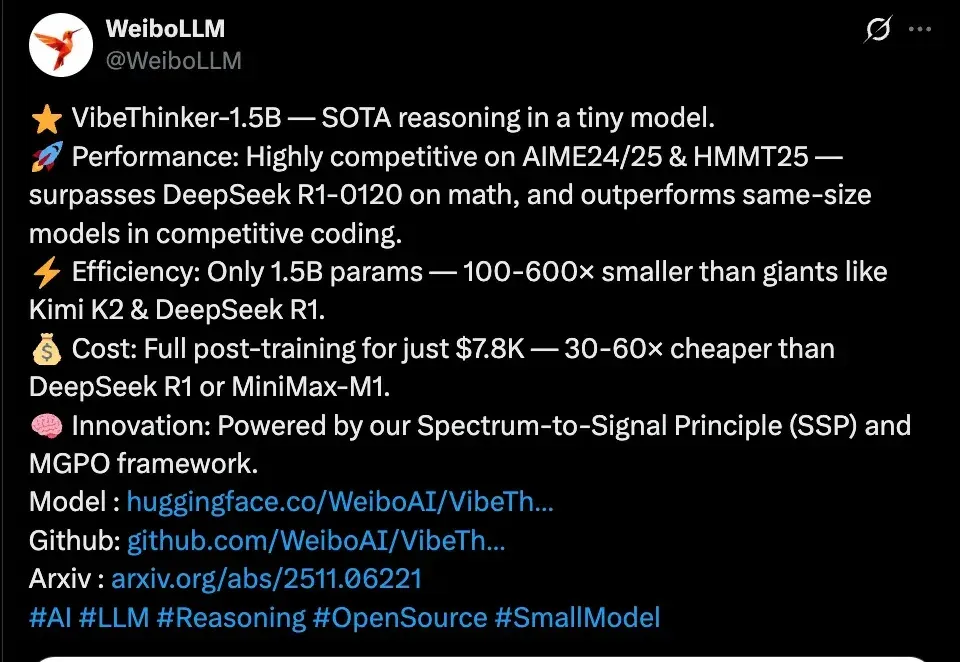
近日,微博正式发布首个自研开源大模型VibeThinker,这个仅拥有15亿参数的“轻量级选手”,在国际顶级数学竞赛基准测试上击败了参数量是其数百倍的、高达6710亿的DeepSeek R1模型。
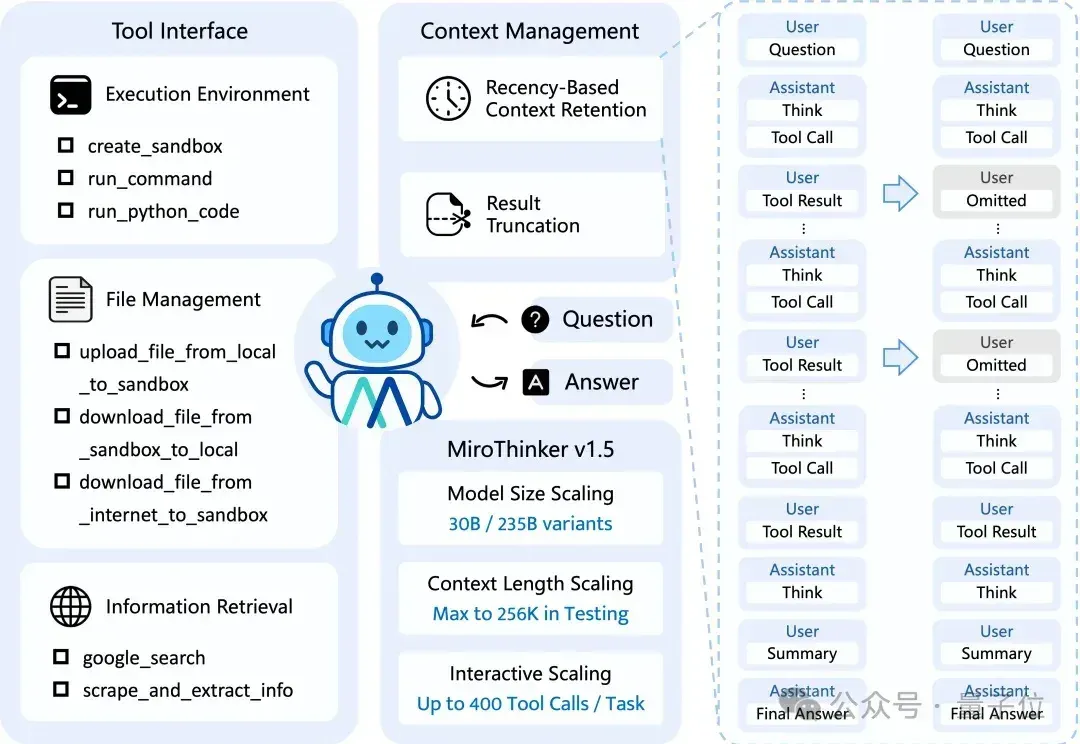
新年刚至,陈天桥携手代季峰率先打响开源大模型的第一枪。
用过才知道,「快」不是万能药。 如果你这几天刷社交媒体,应该已经注意到,美团的 LongCat-Flash-Chat 正在频频刷屏,标题大多是将其与 DeepSeek 作对比,称美团推出的第一款开源大模型已经追平了 DeepSeek-V3.1。 事实果真如此吗?AI 科技评论想要一探究竟。 首先可以确定的是,这款模型上是一款面向日常对话与轻量问答的中量级对话模型,560B总参数,稍小于 DeepSeek-V3.1 的 671B,但是两者都采用了 MoE 架构。前者强调延迟控制与高并发下的流畅体验,后者逻辑拆解与复杂问题的处理能力更强。 LongCat 这款模型最大的标签就是“快”,几乎零延迟的
行业内许多人认为AI 模型市场的赢家早已确定:大型科技公司将主导市场(谷歌、Meta、微软,以及部分亚马逊业务)并联合其选择的模型开发商,主要是 OpenAI 和 Anthropic。
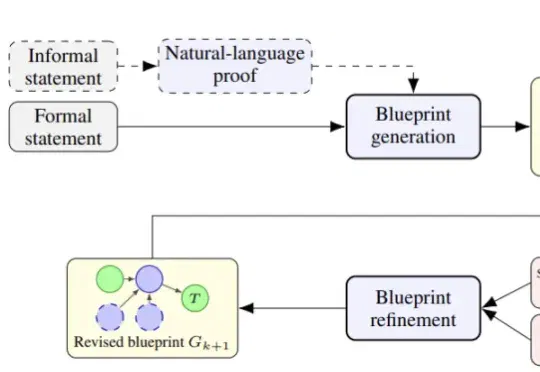
近日,普林斯顿大学的研究团队发布了一篇新论文,提出了一个名为 Goedel-Architect 的智能体框架。他们用的核心模型,是国内开源大模型 DeepSeek-V4-Flash。
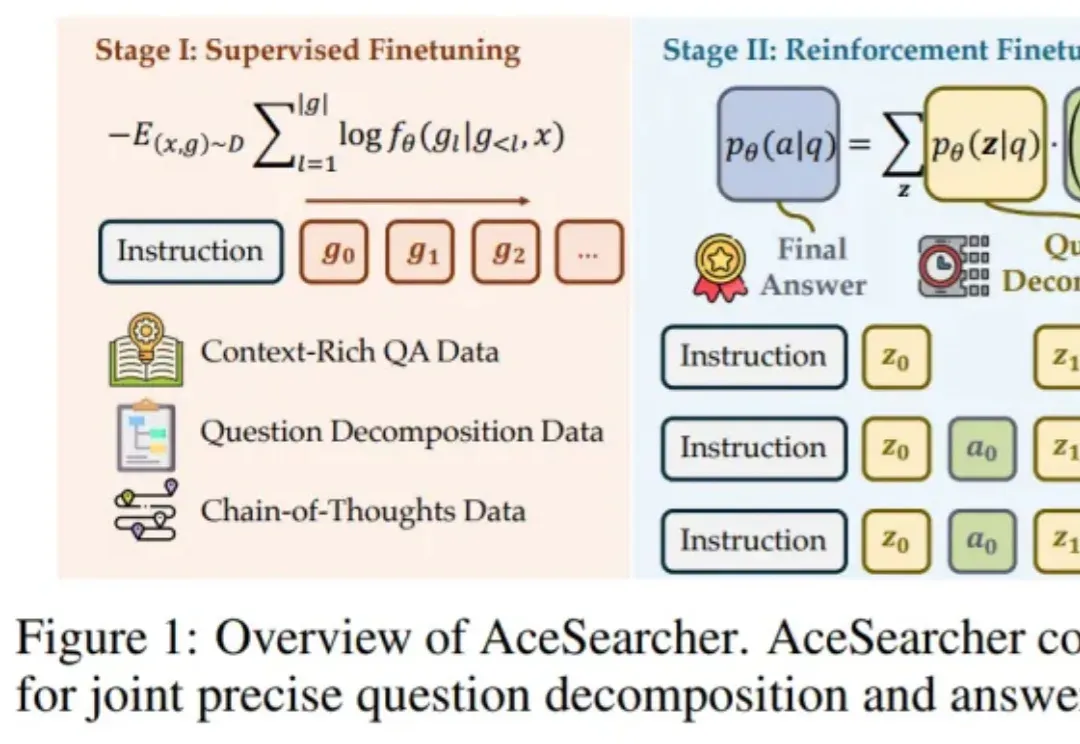
如何让一个并不巨大的开源大模型,在面对需要多步检索与复杂逻辑整合的问题时,依然像 “冷静的研究员” 那样先拆解、再查证、后归纳,最后给出可核实的结论?