搜索

关于“大模型”的结果

共 1517 篇

DeepSeek之后,智源大模型登Nature:事关“世界模型”统治路线!

DeepSeek之后,智源大模型登Nature:事关“世界模型”统治路线!(在新窗口打开)

▲图片由AI生成 一场押注AI未来的技术豪赌。 智东西2月1日报道,北京时间1月29日,北京智源人工智能研究院推出的多模态大模型“悟界·Emu”登上Nature正刊,成为继DeepSeek之后第二个达成此成就的中国大模型团队研究成果,也是中国首篇围绕多模态大模型路线的Nature论文。 ▲Nature官网截图 Nature编辑点评道:“Emu3仅基于‘预测下一个token’实现了大规模文本、图像和视频的统一学习,其在生成与感知任务上的性能可与使用专门路线相当,这一成果对构建可扩展、统一的多模态智能系统具有重要意义,有望推动原生多模态助手、世界模型以及具身智能等方向的发展。” ▲Emu3有望推动
AI技术文章
0
DeepSeek V4-Flash登顶OpenRouter全球调用榜

DeepSeek V4-Flash登顶OpenRouter全球调用榜(在新窗口打开)

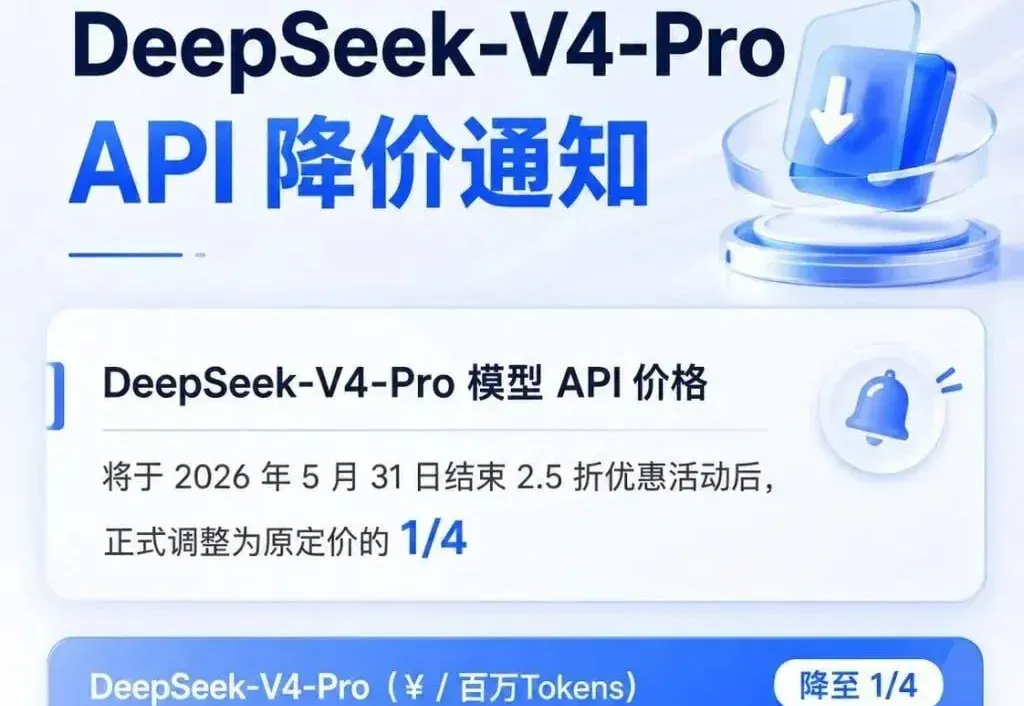
最近,DeepSeek又刷屏了! 根据 OpenRouter最新数据测算,5月18日至 5月24日,全球AI大模型总调用量达到 28.9 万亿Token,整体需求仍在快速释放。其中,中国AI大模型周调用量达 9.22万亿Token,环比增长19.89%;美国AI大模型周调用量为4.93万亿Token,环比增长16.27%。 值得注意的是,中国大模型调用量已连续 4 周超过美国。其中,DeepSeek V4-Flash登顶OpenRouter全球调用榜,其旗下模型周调用总量达到 5.74万亿Token,超过Anthropic与Google,连续两周位居全球第一。 流量不会说谎。每一笔背后,是开发

AI资讯
0
大模型中毒记

大模型中毒记(在新窗口打开)

那个叫大模型的高手,被下毒了 近日,AI江湖上突然传出一些秘闻。 那个叫大模型的高手,好像被下毒了。 不少与之过招的用户发现,曾经算无遗策、对答如流的高人,近来举止颇为怪异。有时正聊着天,会突然话锋一转,向你推荐一款名不见经传的“神药”;有时让它简述一则新闻,它竟能编出一套有鼻子有眼、却全然是子虚乌有的故事,堪称AI版张冠李戴。 这究竟是怎么回事?莫非是练功走火入魔,以至于开始胡言乱语了? 据知情者透露,此非走火入魔,实乃江湖中一种阴险手段——数据投毒。 所谓大模型中毒,是指模型在训练或使用过程中受到了恶意数据的影响,导致输出异常甚至有害的内容。 Anthropic的一项最新研究揭示:研究者仅

AI资讯
0
「语言模型撞墙了,3D大模型刚开始」|和VAST创始人宋亚宸聊3D大模型创业「狂飙」的两年

「语言模型撞墙了,3D大模型刚开始」|和VAST创始人宋亚宸聊3D大模型创业「狂飙」的两年(在新窗口打开)

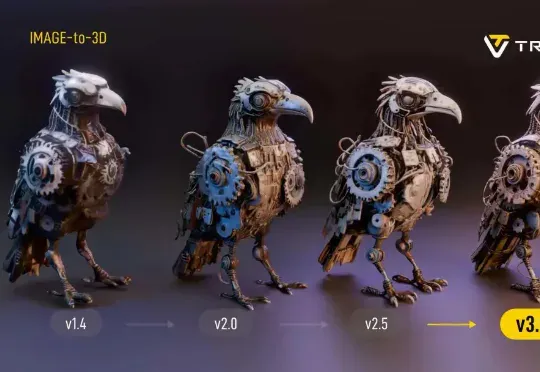
本周,我们邀请 3D 大模型公司 VAST 的创始人和 CEO 宋亚宸(Simon),和我们聊聊 VAST 最新 3D 生成大模型 Tripo 3.0 背后的故事。这位 97 年的创业者短期内连续融资三轮、每轮数千万美金,积攒了足够的子弹,在闷头苦干一年后,Simon 今年首次上播客,和我们探讨了几个关键的战略问题:

AI资讯
0
突发|苹果 AI 国行版,真的要来了

突发|苹果 AI 国行版,真的要来了(在新窗口打开)

刚刚,网信中国发布公告,「Apple 智能」正式通过生成式人工智能服务备案。 和苹果一起「持证上岗」的还有华为小艺 AI 大模型、OPPO AndesGPT、vivo 蓝心端侧大模型、小米澎湃 AI、三星盖乐世 AI 和努比亚豆包手机大模型,一共 7 款手机端侧大模型在 7 月 8 日集体过审。

AI资讯
0
大模型中标TOP10里的黑马:中关村科金的应用攻坚之道

大模型中标TOP10里的黑马:中关村科金的应用攻坚之道(在新窗口打开)

一份大模型中标数据报告,揭示了产业重心转移的清晰轨迹:应用类项目占比近六成,市场用真金白银为 “落地” 投票。2025 年,中国大模型产业在招投标市场上演了一场令人瞠目的 “狂飙”。智能超参数的监测数据显示,全年大模型相关中标项目数量达到 7539 个,披露金额 295.2 亿元,较 2024 年分别激增 396% 与 356%。市场正以前所未有的速度,将技术潜力兑换为商业订单。

AI资讯
0
真实音频场景,大模型集体挂科!首个原生语音基准MultiChallenge

真实音频场景,大模型集体挂科!首个原生语音基准MultiChallenge(在新窗口打开)

文本领域的大模型满分选手,换成语音就集体挂科?大模型引以为傲的多轮对话逻辑,在真实人声面前竟然如此脆弱。Scale AI正式发布首个原生音频多轮对话基准Audio MultiChallenge,直接撕开了大模型靠合成语音评测维持的优等生假象。实验显示,强如Gemini 3 Pro在真实场景下的通过率也仅过半数,而GPT-4o Audio的表现更是令人大跌眼镜。

AI技术文章
0