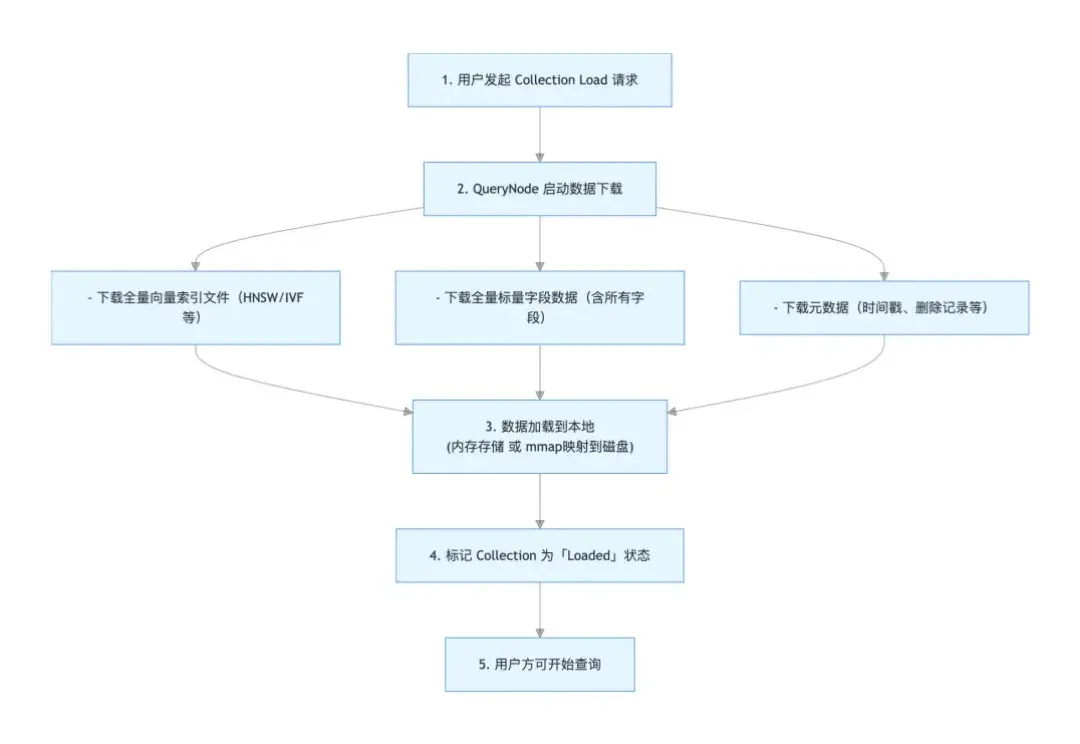
向量数据库新范式:分层存储,让数据从全量加载到按需加载 | Milvus Week(在新窗口打开)
本文为Milvus Week系列第7篇,该系列旨在把Zilliz团队过去半年多积累的先进的技术实践和创新整理成多篇干货深度文章发布。
共 15 篇
本文为Milvus Week系列第7篇,该系列旨在把Zilliz团队过去半年多积累的先进的技术实践和创新整理成多篇干货深度文章发布。
静态编排 VS 动态编排,谁是多agent系统最优解?通常来说,面对简单问题,采用react模式的单一agent就能搞定。可遇到复杂问题,单一agent就会立刻出现包括但不限于以下问题:串行执行效率低:无法同时完成并行的子步骤(如 “同时爬取 A、B 两个网站的数据”)。
近日,Milvus 3.0 正式上线。作为 Milvus 架构演进中的里程碑式版本,3.0 不仅带来多项突破性新功能,更从底层重塑了向量数据的存储、索引与检索边界。在 Milvus 3.0 中,你可以获得:
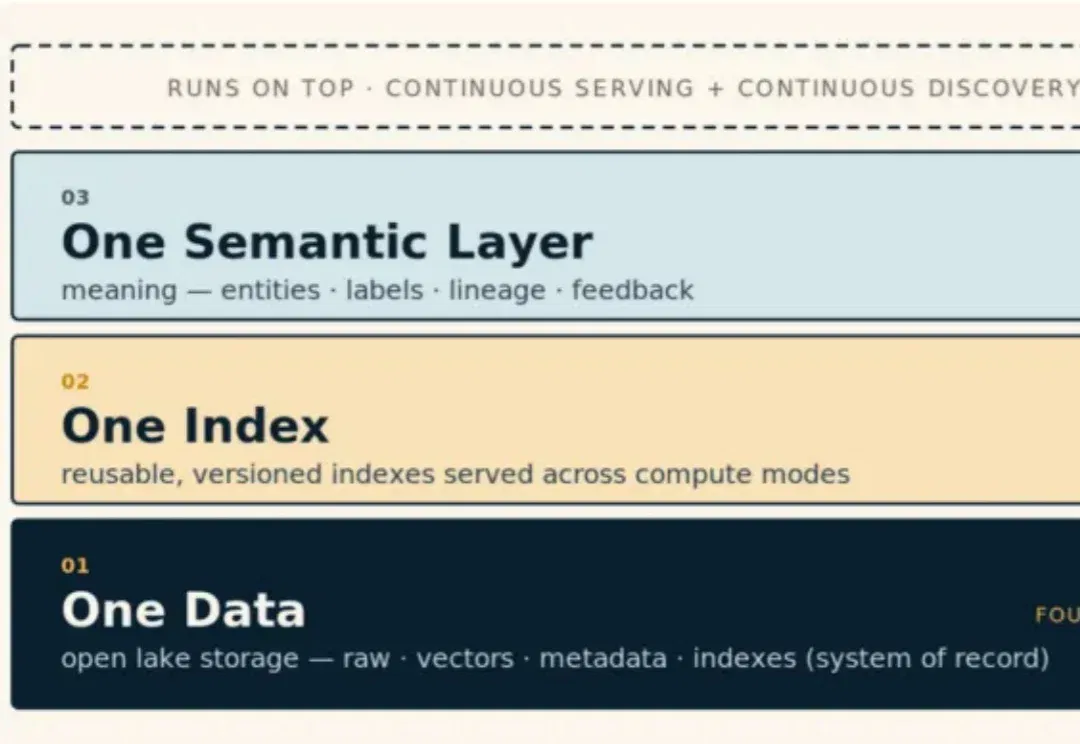
这篇文章想回答几个大家更关心的基础问题:Vector Lakebase 能解决你的什么问题,什么场景下用它最合适,如何用好Vector Lakebase 。
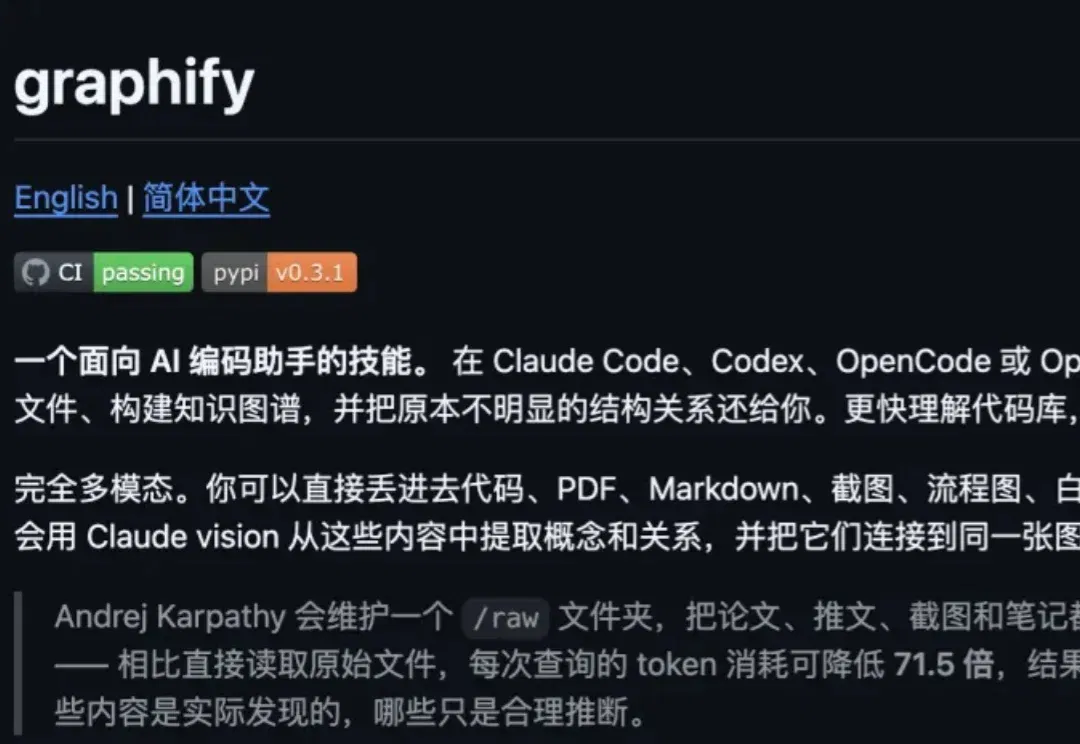
AI圈的节奏已经快到让人产生幻觉了。 Karpathy分享的个人知识库爆火出圈,48小时就有人拿着完全体送货上门。 Graphify,一款零配置、全模态、本地跑、还特能省token的知识图谱工具,GitHub开源狂揽2k+ Star。 不仅能自动构建可导航知识图谱、自带反向链接和关系溯源,更实现71.5倍token消耗节省,直接把卡神的/raw笔记法进化到了完全体。 万物皆可图谱化 卡神那套爆火的知识库,核心是一套不用复杂向量数据库的轻量化工作流。 靠raw/目录存论文、代码、截图等原始资料,再通过LLM自动生成带交叉引用的Wiki文档,配合定期体检维护,慢慢搭建起一个能持续生长、越用越好用的