世界模型榜首易主!跨维智能登顶WorldArena(在新窗口打开)
近日,全球具身世界模型权威评测基准 WorldArena 公布最新榜单。在 5 月 25 日截止的最终榜单中,跨维智能登顶 Track 2 赛道全球第一。可以说是,在英伟达、谷歌等全球科技巨头深度布局、重兵把守的世界模型核心腹地,跨维智能实现了强势突围。
共 20 篇
近日,全球具身世界模型权威评测基准 WorldArena 公布最新榜单。在 5 月 25 日截止的最终榜单中,跨维智能登顶 Track 2 赛道全球第一。可以说是,在英伟达、谷歌等全球科技巨头深度布局、重兵把守的世界模型核心腹地,跨维智能实现了强势突围。
国产开源具身世界模型,直接秒了Pi-0.5,而且还是几位清华硕、博士研究生领衔推出的。这就是由生数科技联合清华大学,正式开源的大一统世界模型——Motus。
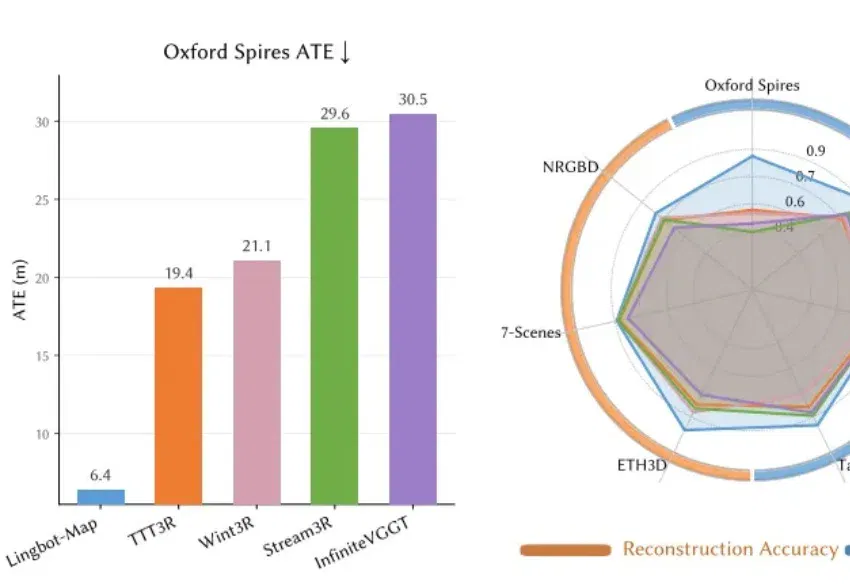
蚂蚁灵波,下了盘大棋。 今年 1 月,蚂蚁灵波一口气开源了 4 款大模型,包括高精度空间感知模型 LingBot-Depth、具身大模型 LingBot-VLA 与具身世界模型 LingBot-VA,以及世界模型 LingBot-World。 其中,LingBot-Depth 负责从图像中估算深度、感知空间距离,LingBot-World 负责对环境进行模拟和理解,LingBot-VLA/VA 负责机器人的决策和动作控制。 这四款模型「各司其职」,分别覆盖感知底层、环境理解和行动输出,但中间一直缺少一个关键环节,就是如何把连续的感知数据实时构建成稳定的三维空间模型,让后续模块有据可依。 现在,
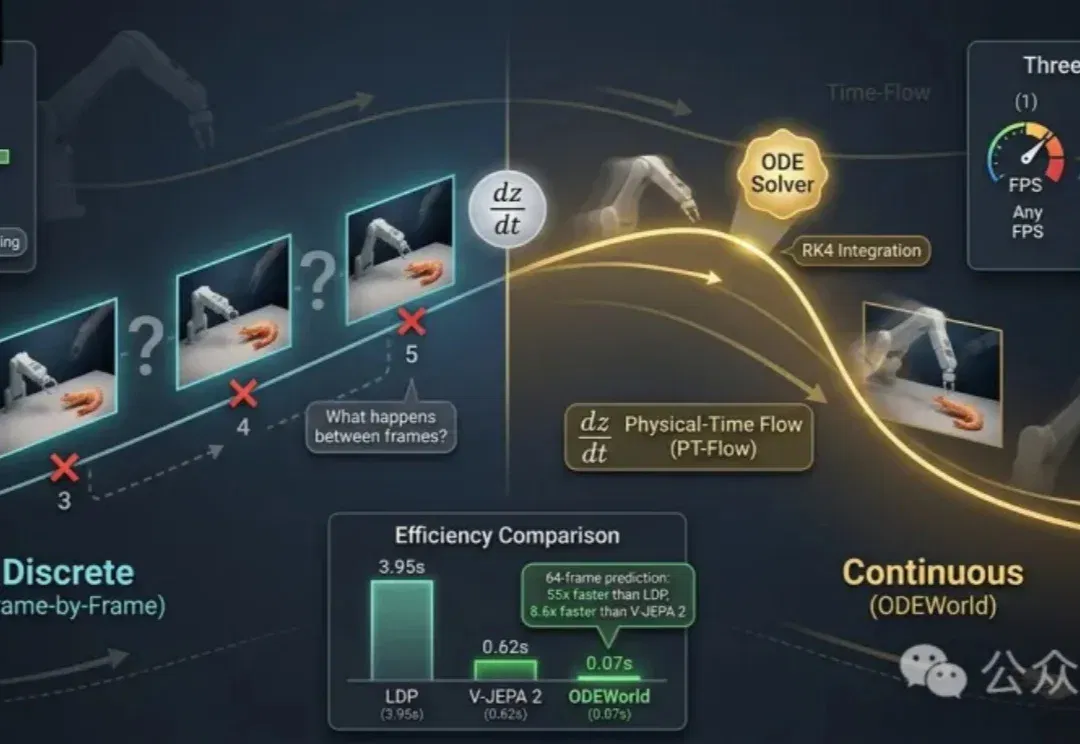
让机器人把一只虾夹起来,再放进锅里。 真正困难的,可能不是认出虾,也不是找到锅,而是把握夹爪闭合的那个瞬间:早一点,夹爪会落空;晚一点,虾可能已经被推走。夹住之后,机械臂还要连续调整力度、方向和速度。整个过程没有暂停键,也不会等摄像头拍完「下一帧」再继续。 但许多视觉世界模型认识时间的方式,恰恰来自这些被摄像头截取的画面。它们看到第1帧、第2帧、第3帧,并学习如何从一张图跳到下一张图。至于两帧之间发生了什么、换一种帧率后该如何预测,甚至某个关键瞬间缺失后如何还原,模型通常没有一条可以直接查询的连续轨迹。 问题也由此变得具体: 如果机器人对世界的理解只存在于一格格画面里,它要怎样抓住发生在两帧之
当机器人拥有多个摄像头,它看到的世界是否仍然保持一致?
人类可以轻松想象一个还没做出的动作会带来什么:手一松,杯子会掉;往前一推,抽屉会合上。动作尚未发生,大脑已经预演了可能的结果。对机器人来说,具身世界模型(Embodied World Model)会根据当前观察和未来的动作,预测动作执行后的未来画面。
医疗AI终于走出了「只会聊天」的舒适区。今天,斯坦福与普林斯顿联手NVIDIA发布MedOS。这不是一个单纯的手术机器人,而是全球首个通用医疗具身世界模型。从临床诊断到治疗,从外科手术到药物研发,MedOS正在让AI真正读懂「生老病死」的物理现实。
近两年,视频生成模型在具身智能领域受到持续关注。从 UniPi、SuSIE 到各类 action-conditioned video generation 变体,其核心思路一致:先由模型生成一段未来视频,再从中提取动作信号供机器人执行。
2026年,具身智能赛道的融资热度仍在持续,但投资人的提问方式已经变了。
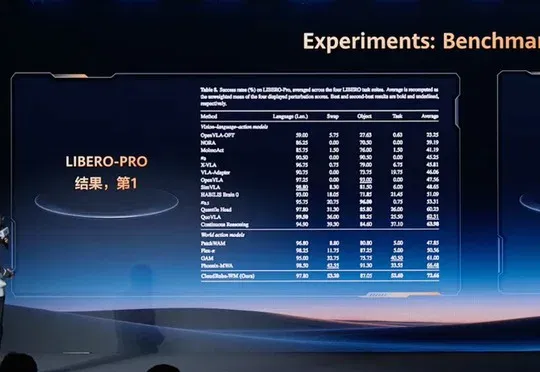
华为云介绍昇腾原生具身世界模型CloudRobo-WM1.2及配套开发平台,公布两项基准和工业场景演示。模型权重、推理后训练代码与预训练实践计划于11月30日开放。