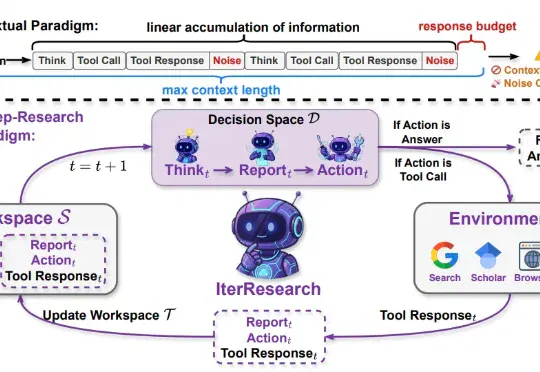
ICLR 2026|人大&通义:别再只会堆上下文了!IterResearch用40K上下文轻松实现2048轮交互不退化(在新窗口打开)
来自中国人民大学与阿里巴巴通义实验室的研究团队提出了 IterResearch,一种全新的迭代式深度研究范式。通过马尔可夫式的工作空间重构,IterResearch 让 Agent 在仅 40K 上下文长度下完成了 2048 次工具交互且性能不衰减,在 BrowseComp 上从 3.5% 一路攀升至 42.5%。
共 348 篇
来自中国人民大学与阿里巴巴通义实验室的研究团队提出了 IterResearch,一种全新的迭代式深度研究范式。通过马尔可夫式的工作空间重构,IterResearch 让 Agent 在仅 40K 上下文长度下完成了 2048 次工具交互且性能不衰减,在 BrowseComp 上从 3.5% 一路攀升至 42.5%。
谷歌在第三天发布了《上下文工程:会话与记忆》(Context Engineering: Sessions & Memory) 白皮书。文中开篇指出,LLM模型本身是无状态的 (stateless)。如果要构建有状态的(stateful)和个性化的 AI,关键在于上下文工程。
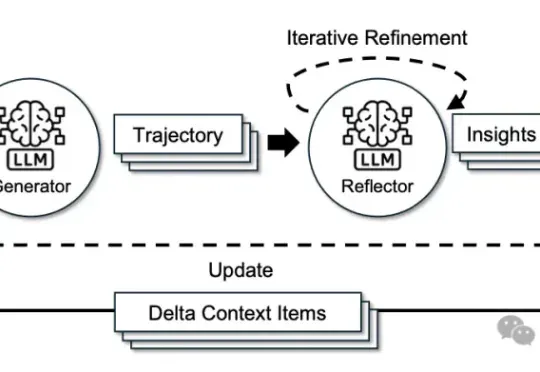
来自斯坦福大学、SambaNova Systems公司和加州大学伯克利分校的研究人员,在新论文中证明:依靠上下文工程,无需调整任何权重,模型也能不断变聪明。他们提出的方法名为智能体上下文工程ACE。
9 月 26 日,Flowith 再次迎来了大更新,这一次,它的核心所指,正是「上下文腐烂」以及更加「自由的创作」。接下来,我们分享全面实测体验。从我的实际体验来看,这次的 Flowith 更新,终于让上下文「活」起来了。
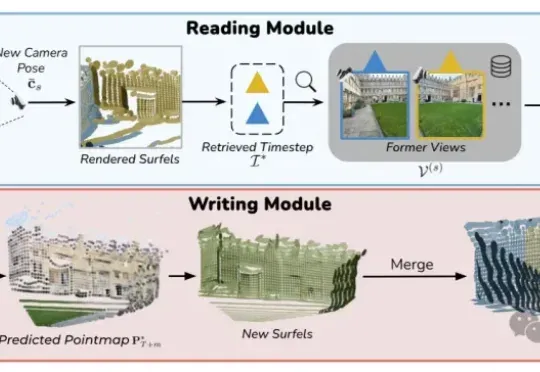
VMem用基于3D几何的记忆索引替代「只看最近几帧」的短窗上下文:检索到的参考视角刚好看过你现在要渲染的表面区域;让模型在小上下文里也能保持长时一致性;实测4.2s/帧,比常规21帧上下文的管线快~12倍。
百度开源文心 5.5 Flash Base(ERNIE 5.5 Flash Base)权重,该模型总参数280B、每token激活14B,采用稀疏MoE与混合稀疏注意力,微调和推理上下文外扩至1M tokens。
十字路口团队以像素视频特效素材库为例,体验 TRAE 宝如何连接调研、开发和成果整理,并通过微信或飞书跟进任务。文章重点是跨项目上下文与统一管理入口;准确检索历史、协调多个任务和保持本地电脑开机,仍是实际使用中的前提与限制。
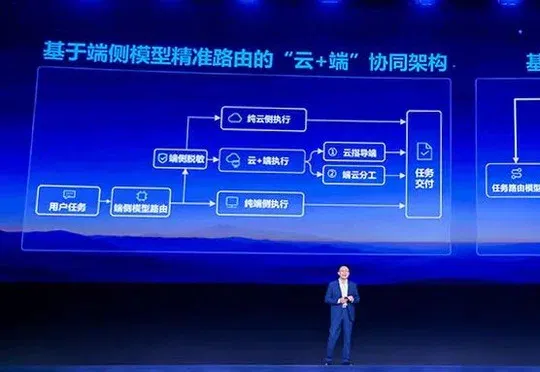
科大讯飞发布端云一体基座模型讯飞星火X2.6和语音基座模型SparkAudio 1.0,星火X2.6基于全国产算力训练,云端293-A30B支持百万token上下文,输入缓存未命中及输出价格低于DeepSeek-V4.1-Flash-1017,端侧X2.6-4B已开源。
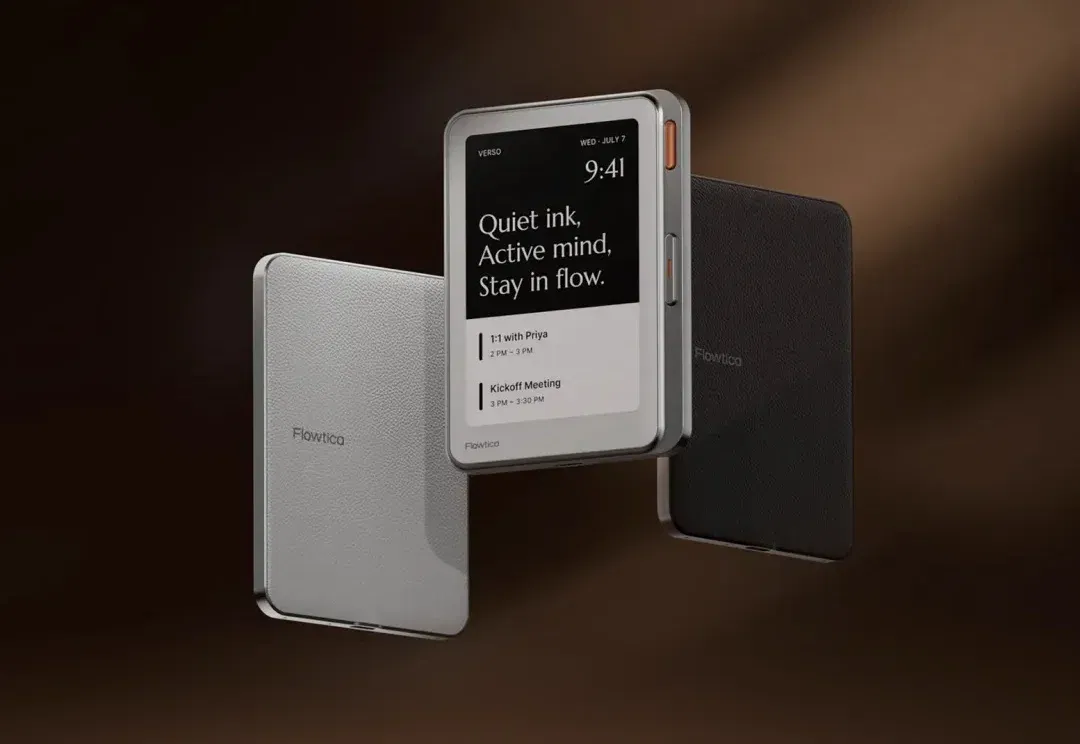
可能是最擅长「开会」的 AI 硬件。 AI 墨水屏赛道正在起势。 极客公园获悉,AI 硬件品牌 Flowtica 完成数千万人民币新一轮融资,由祥峰资本领投,源码资本、五源资本及清水湾基金等老股东跟投。与此同时,9 月在 IFA 宣发的 AI 墨水屏产品—— Verso,已正式在海外开启定金预售,并将于 12 月交付首批产品。 Verso 是一块 78 克、6.5 毫米厚的磁吸墨水屏,贴在手机背面。开会时按一下开始录音,实时转写、实时总结,结束录音时自动生成待办;过程中,单击标记重点,双击生成待办,在墨水屏上可以实时查看;按一下 Ask 键,可以问它任何关于你上下文的问题,还能直接给它交代一些
AI真正的瓶颈,是个人上下文。 昨天晚上,我们开了一场得到的秋季知识产品发布会。 可能有些朋友错过了直播,今天我就跟你说说,这场发布会我们到底发布了什么,也跟你分享一下这背后我的一些思考。 东西不少,但我今天想重点聊两件事。一个是我们继得到AI录音卡之后的又一个硬件新品,叫得到AI录音台。另一个是得到大脑4.0的升级。 这两个产品,其实要解决的是同一个问题。 我是做产品经理的,每天都要跟AI、跟同事讨论问题。AI用得越多,我越有一个感受:AI要真帮得上忙,光靠聪明的大模型是不够的。 它得知道我最近在做什么项目,用户提过什么要求,上一次为什么那么决定。这些具体情况,就是AI需要的上下文。而且它们