国内大模型厂商 Token/Coding Plan 汇总对比:MiniMax、智谱、阶跃、Kimi 怎么选(在新窗口打开)
我自己用 Coding Plan 也有一段时间了,最开始只是为了省点 API 钱,后来各家陆续推出固定月费套餐,我发现选起来比想象中复杂。Codex、Claude Code、Cline、OpenClaw 这些工具让开发者越来越习惯用自然语言驱动代码生成和任务执行,但高频调用带来的 API 成本也成了一笔固定开销。
共 354 篇
我自己用 Coding Plan 也有一段时间了,最开始只是为了省点 API 钱,后来各家陆续推出固定月费套餐,我发现选起来比想象中复杂。Codex、Claude Code、Cline、OpenClaw 这些工具让开发者越来越习惯用自然语言驱动代码生成和任务执行,但高频调用带来的 API 成本也成了一笔固定开销。
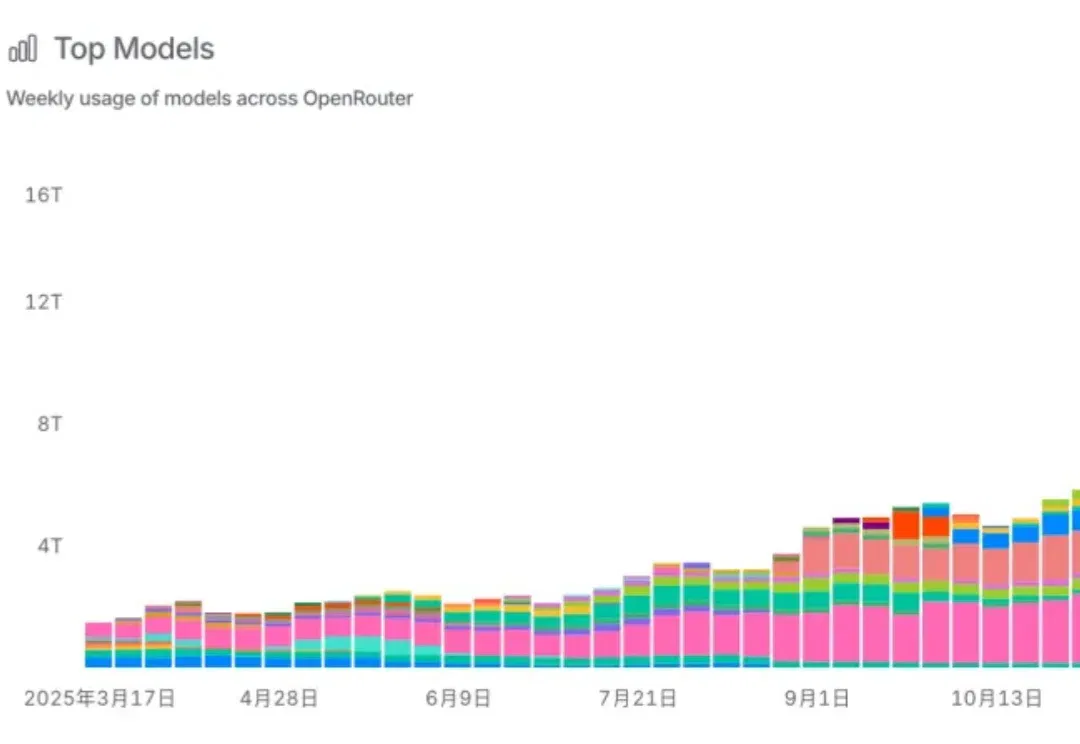
好家伙!龙虾老吃家还得看中国。 全民“养虾”热潮直接带动国产大模型喜迎黄金周。 根据OpenRouter最新数据,上周中国大模型的周调用总量飙升至4.19万亿Token。 这是继今年2月首度反超美国后,中国大模型再度强势登顶,重回全球榜首。 OpenClaw继续霸榜热门应用第一,其中本月最受养虾人青睐的算力搭子中,国产大模型依旧遥遥领先。 榜单前三分别是Kimi K2.5、Step 3.5 Flash和MiniMax M2.5,均超1T tokens。 果然在吃这回事上,国产玩家真夯!喝完奶茶吃龙虾,妙哉妙哉~(doge) 🦞爱吃中国大模型 整体来讲,上周3月2日-8日,中美大模型活跃度出现
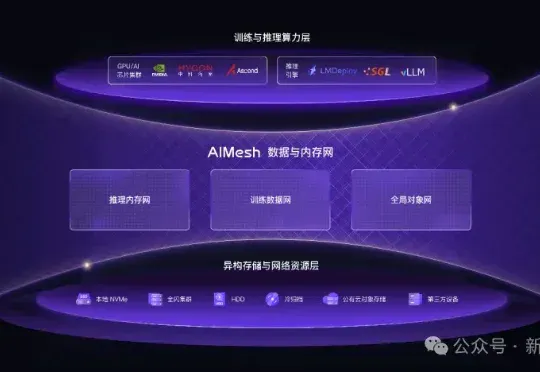
本次发布的核心——AIMesh,正是这场架构创新的集大成者。 它被定义为面向「AI工厂」的数据与内存网,核心思路是用一套「三网合一」的柔性网络,替代传统僵化的存储架构。
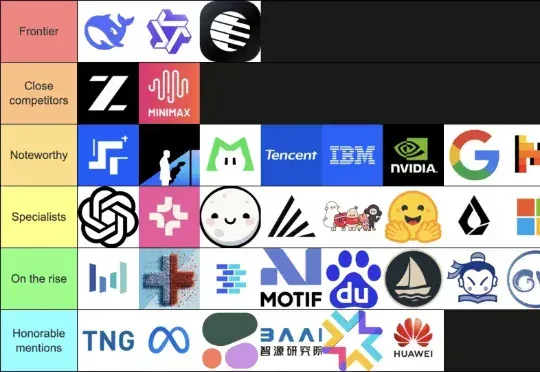
最近几天,一张开源模型的等级列表在 X 上被疯狂转载。 从夯到拉,国产开源模型排在了数一数二的位置,DeepSeek、Qwen、Kimi、智谱、还有 MiniMax 是全球开源模型的前五名。
Caltech的Anima Anandkumar团队利用物理信息神经网络(PINN)和自研优化器,在三维无强迫欧拉方程自由空间中求得奇点候选解,缩放指数收敛至约0.5,但最终证明仍待完成。

一周之内大语言、图片、视频模型都迎来新赛季:OpenAI的GPT-6 Astra让编码 Agent更好地使用游戏引擎和Blender,自己改场景、自己跑、自己测;GPT-image-2.5上线,更快更强,图片编辑和关键帧动画显著提升;fal和Yoroll分别发布 H3 MaxTurbo和H3 Superfast后训练加速模型,5秒视频3秒内推理,实时生成和互动玩法纷纷涌现。
Accelerated Understanding由英伟达前AI研究总监Anima Anandkumar联合创立,采用神经算子架构构建支持5万亿推理上下文的物理AI大模型,可一次推演完整4D时空轨迹,其创始人拒绝贝索斯35%股权及超20亿美元融资的普罗米修斯计划招揽。
加州理工学院 Anima Anandkumar 团队 8 月 24 日发了一篇论文,用一个 AI 模型把这类计算的复杂度从立方级压到了近线性级。效果相当震撼:在单块 GPU 上完成了一个含 82500 个电子的金属缺陷模拟,2019 年同类计算用了约 7800 块 GPU。
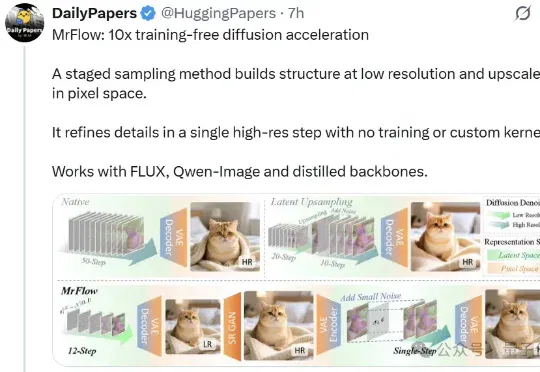
MrFlow(Multi-Resolution Flow Matching)就用这样的三阶段,在Qwen-Image等模型上把端到端生成时间从49.32s压到4.77s,实际加速10.35x。文章发布当日即登上Hugging Face Daily Papers;发布三天内,GitHub已收获200+stars;目前也已登上Hugging Face Trending Papers。
把 Agent 从单体,组成一支可以协作的 Agent Teams。