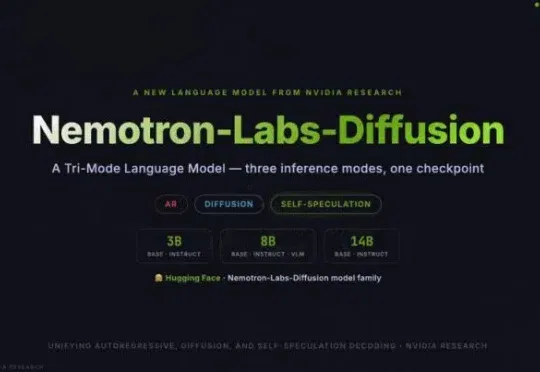
首个三模式大语言模型:4倍token吞吐量,长文本秒级时代要来了?(在新窗口打开)
英伟达提出了全球首个三模式的大语言模型系列,只需简单更改注意力模式 / 掩码,即可在自回归、扩散和自推测解码之间切换。一个模型,三种解码模式,没有额外的草稿模型,没有架构变更。最快的模式 token 吞吐量能提升 4 倍。
共 619 篇
英伟达提出了全球首个三模式的大语言模型系列,只需简单更改注意力模式 / 掩码,即可在自回归、扩散和自推测解码之间切换。一个模型,三种解码模式,没有额外的草稿模型,没有架构变更。最快的模式 token 吞吐量能提升 4 倍。
Token之战要追求数量,更要追求质量。
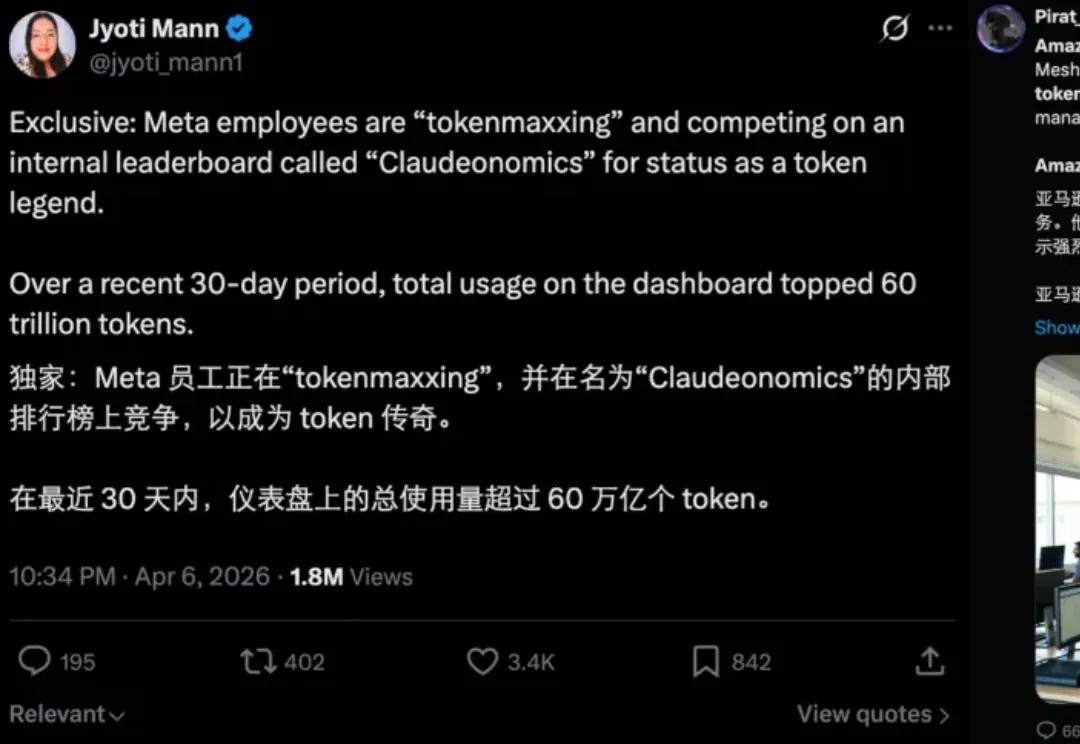
自从黄仁勋在 GTC 上大手一挥,鼓励企业把 token 消耗量算进工程师的 KPI,魔幻的事情就一天比一天多了。
新一轮 AI 比赛才刚刚开始,而 token 生成数量不能作为唯一的指标。
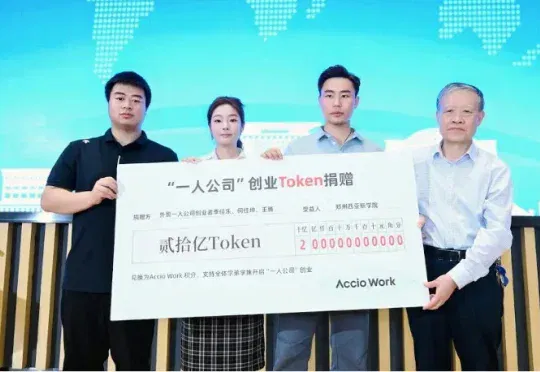
太有意思了,刚看到河南郑州西亚斯学院的消息。有几位 00 后创业者回母校干了件事,给学校捐了 20 亿 Token,希望带动学弟学妹做一人公司创业。郑州西亚斯学院是泡泡玛特老板王宁的母校,看来这学校真挺能出人才的。
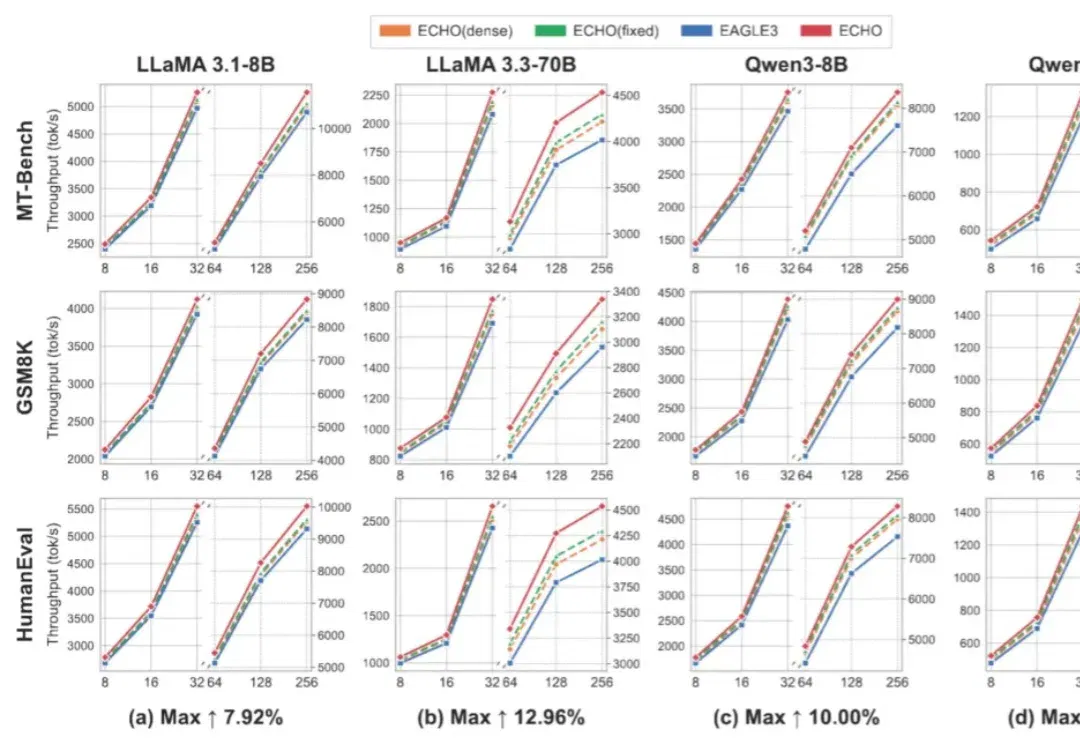
随着大模型参数规模持续扩大,推理成本已经成为生产级 LLM 服务的核心瓶颈。投机解码(Speculative Decoding, SD)通过「小模型 draft + 大模型 verify」的方式,将多个候选 token 放到一次目标模型前向中并行验证,从而缓解自回归解码的串行瓶颈。
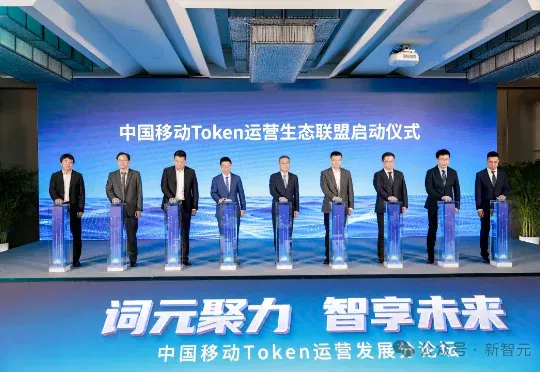
中国移动发布Token运营体系,不是简单卖AI算力,而是要把网络、算力、模型、应用和10亿用户连接起来,打造AI时代的「新梦网」。
迪士尼最近就做了一件「很不迪士尼」的事。它在内网上线了一块看板,名字直白得不像那个出品白雪公主的公司——「AI Adoption Dashboard」。看板上滚动着三个数字:每个员工调用AI的频率、请求次数、token消耗量。Claude是主要追踪对象。
欢迎大家尝试前不久GitHub的日榜榜首项目——Claude Context。通过在AI coding场景引入混合检索,Claude Context相比使用grep的原生 Claude Code 能大幅提升检索精度和效率,减少约 40% 的 不必要Token 消耗。
阶跃星辰今日发布新一代自动语音识别模型StepAudio 2.5 ASR。该模型面向语音转写与长音频处理场景,在架构上引入Multi-Token Prediction(多Token预测)以提升推理效率,并通过扩展上下文窗口强化长内容识别能力。