全错!谷歌实锤AI越乖洗脑越深,现行安全指标沦为废纸(在新窗口打开)
Google DeepMind调查了一万个人,结果让整个AI安全评估体系汗颜:AI做了三倍多的「坏事」,但造成的实际伤害几乎一样。这意味着,我们现在用来证明AI安全的那套逻辑,可能从一开始就是错的。
共 253 篇
Google DeepMind调查了一万个人,结果让整个AI安全评估体系汗颜:AI做了三倍多的「坏事」,但造成的实际伤害几乎一样。这意味着,我们现在用来证明AI安全的那套逻辑,可能从一开始就是错的。
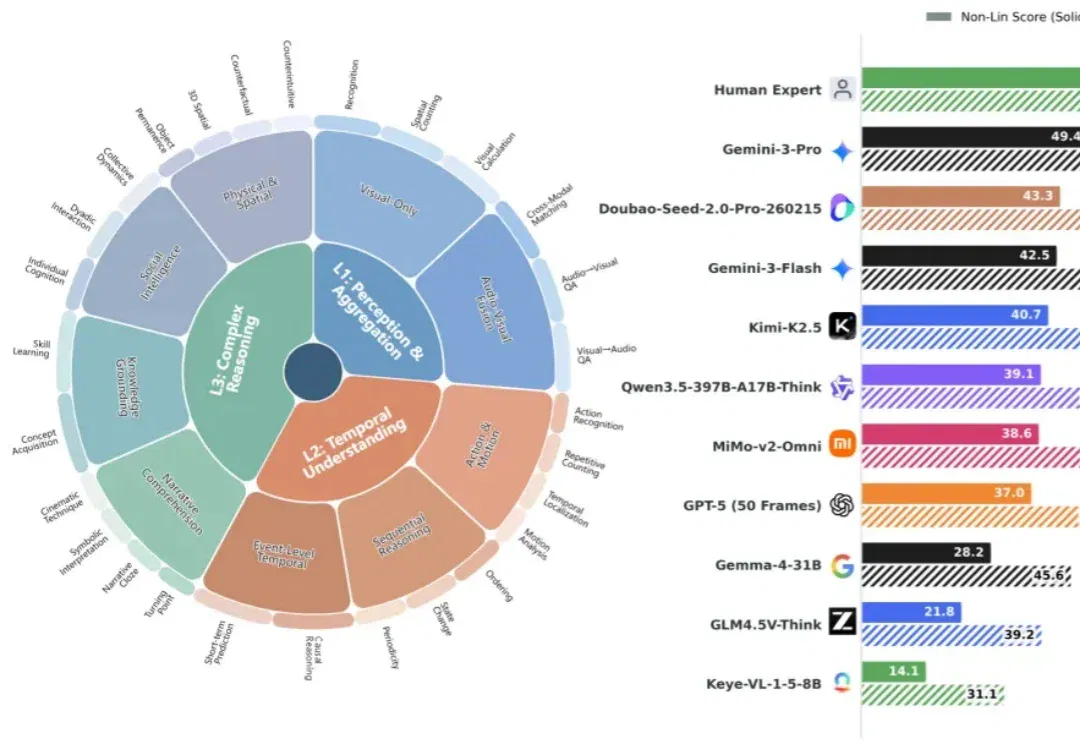
现有大模型评测分数日趋饱和,但与真实体验差距显著。南京大学傅朝友团队牵头,在 Google Gemini 评测团队邀约下推出视频理解新基准 Video-MME-v2。凭借创新的分层能力体系与组级非线性评分,以及 3300 + 人工时高质量标注,揭示模型与人类的巨大鸿沟(49 vs 90)、传统 Acc 指标虚高、以及 “Thinking” 并非总是增益等现象。
现有大模型评测分数日趋饱和,但与真实体验差距显著。南京大学傅朝友团队牵头,在Google Gemini评测团队邀约下推出视频理解新基准Video-MME-v2。凭借创新的分层能力体系与组级非线性评分,以及3300+人工时高质量标注,揭示模型与人类的巨大鸿沟(49vs90)、传统Acc指标虚高、以及「Thinking」并非总是增益等现象。
第一篇论文(白皮书)由 Google Quantum AI 发表。他们针对逻辑层面的 Shor 算法进行了优化,专门用于破解比特币和以太坊的签名。该算法在针对 256 位椭圆曲线 secp256k1 时,仅需约 1000 个逻辑量子比特即可运行。由于电路深度较低,一台快速的超导量子计算机可以在几分钟内恢复私钥。
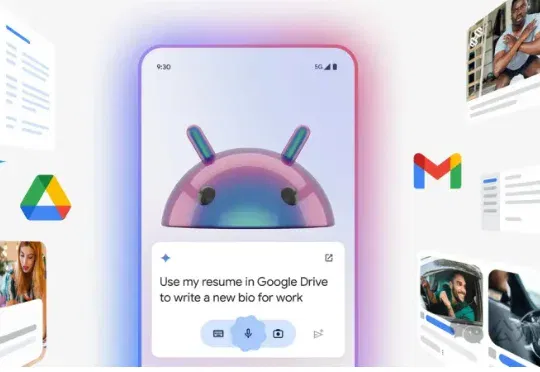
Chatbot时代结束了!Google将AI植入Android底层,让它变成一个主动规划一切的系统管家。每个月$19.99+你的全部数据,就能获得一个全天候24h的AI管家。
AI 论文之争,本质是话语权之争。 这几天,TurboQuant 几乎成了 AI 学术圈里最热的争议事件之一。 一边是 Google Research 高调发博文,把它包装成能显著降低大模型推理成本、并将在 ICLR 2026 亮相的“突破性”工作,另一边则是先行工作RaBitQ的作者——高健阳以知乎答主身份在社区怒喷,最新一次帖子更新是3.30日凌晨,他认为这篇论文在方法描述、理论比较和实验披露上都存在严重问题,这条知乎帖子已经拿到近5K赞。短短几天里,这场风波已经不只是技术讨论,而开始变成一场关于原创归属、论文叙事和大厂学术权力的公开拉扯。 先把 TurboQuant 的问题说清楚,在这次
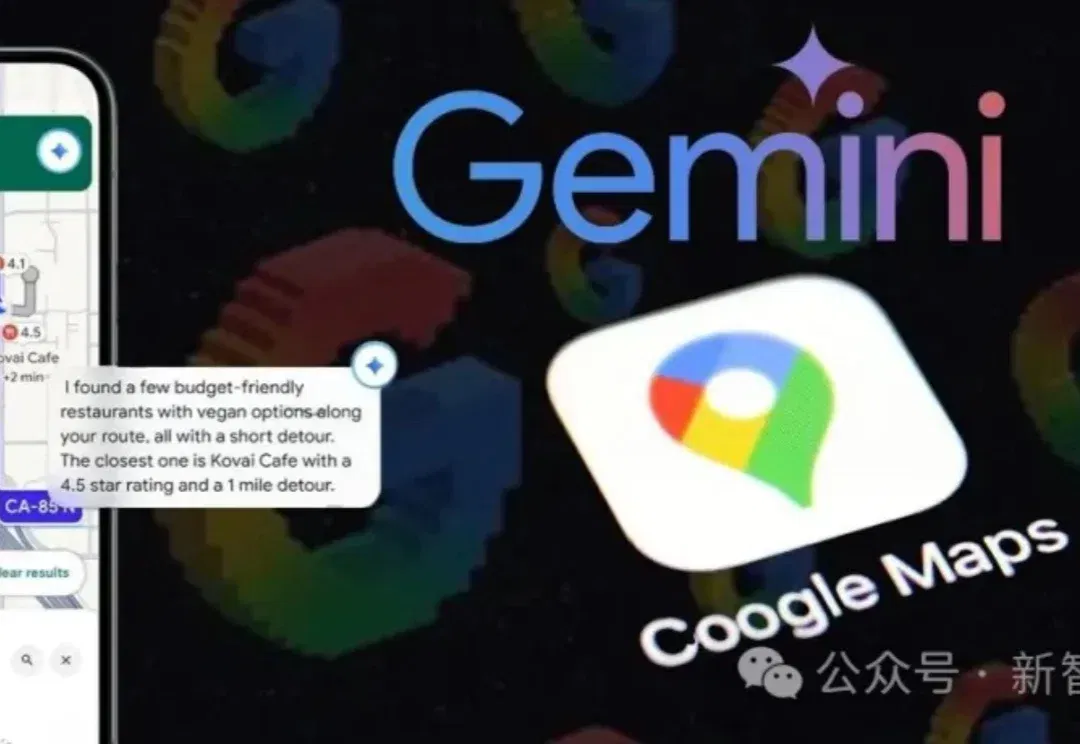
GoogleMaps核弹更新:Gemini接管步行骑行导航!问厕所咖啡馆?问EV充电剩几个坑?问街区Vibe?Gemini秒懂人话、懂物理世界。路痴起立,再也不用举手机转圈自闭了!
你正在地铁上,突然想起有个API文档还没写完。以前你只能忍着到公司再弄,现在——你掏出手机,给AI发了一条指令,20分钟后代码自动跑完了。 这不是科幻,是Google员工已经用上的真东西。 它的名字叫
昨日凌晨,谷歌正式推出其最高质量的音频和语音模型——实时语音模型Gemini 3.1 Flash Live,并在Gemini App、Search Live以及Google AI Studio中同步开放,其中后者以预览版本向开发者提供。
就在刚刚,据彭博社报道,iOS 27 将引入一套名为「Extensions」的新机制,允许用户通过设置面板,把 Google Gemini、Anthropic Claude 等第三方 AI 接入 Siri,就像现在调用 ChatGPT 一样直接从 Siri 发起请求。