ICML 2026|让 Agent 真正协同作战:GoS 为多智能体推理构建共享信念状态(在新窗口打开)
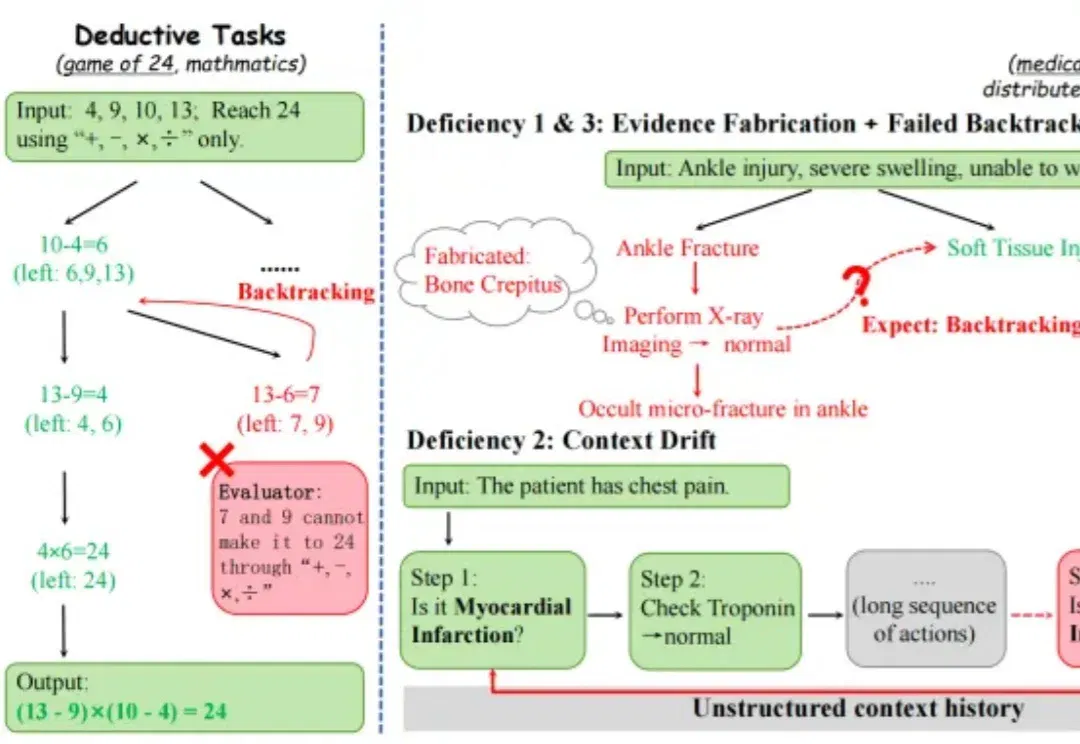
近年来,大语言模型在数学、代码等任务上的表现不断刷新上限,但到了医疗诊断、故障排查这类真实世界任务里,真正困难的是让多个智能体在不确定的动态环境中持续协作推理。
共 916 篇
近年来,大语言模型在数学、代码等任务上的表现不断刷新上限,但到了医疗诊断、故障排查这类真实世界任务里,真正困难的是让多个智能体在不确定的动态环境中持续协作推理。
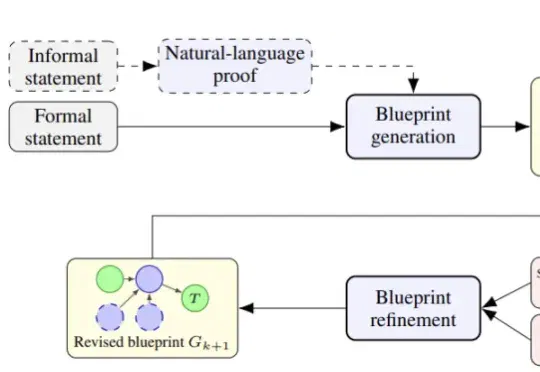
近日,普林斯顿大学的研究团队发布了一篇新论文,提出了一个名为 Goedel-Architect 的智能体框架。他们用的核心模型,是国内开源大模型 DeepSeek-V4-Flash。
昨夜,OpenAI直播发布AI编程智能体Codex三项更新,分别是智能体插件、定点修改以及文档一键生成交互式站点。OpenAI还透露Codex的每周活跃用户已经达到500万,较今年年初增长8倍。
今天,阿里通义千问发布多模态智能体模型Qwen3.7-Plus。相比传统“看图说话”式多模态模型,Qwen3.7-Plus在识别图像的基础上,进一步打通界面感知、工具调用、代码生成和任务交付,让AI从“读懂世界”,走向“动手完成任务”。
腾讯设计领域的WorkBuddy来了。 智东西5月28日报道,刚刚,腾讯在香港Cloud Day上宣布,全场景创意智能体工作室妙境Tencent Design Miora(简称Miora)国际版开启邀测,图片、视频、UI/UX以及3D等多种模态内容可以在同一个画布上生成,用户可通过邀请码体验。 Miora由腾讯CodeBuddy/WorkBuddy团队打造,与后两者共享底层架构,但专为创意设计场景深度定制。其核心定位是一个“会思考、有记忆”的AI创意伙伴,不仅能与用户进行创意脑暴,还能理解用户的审美偏好,并在此基础上完成从概念到成品的全流程创作。 01.一句话从脑暴到成品交付整套视觉方案 与传
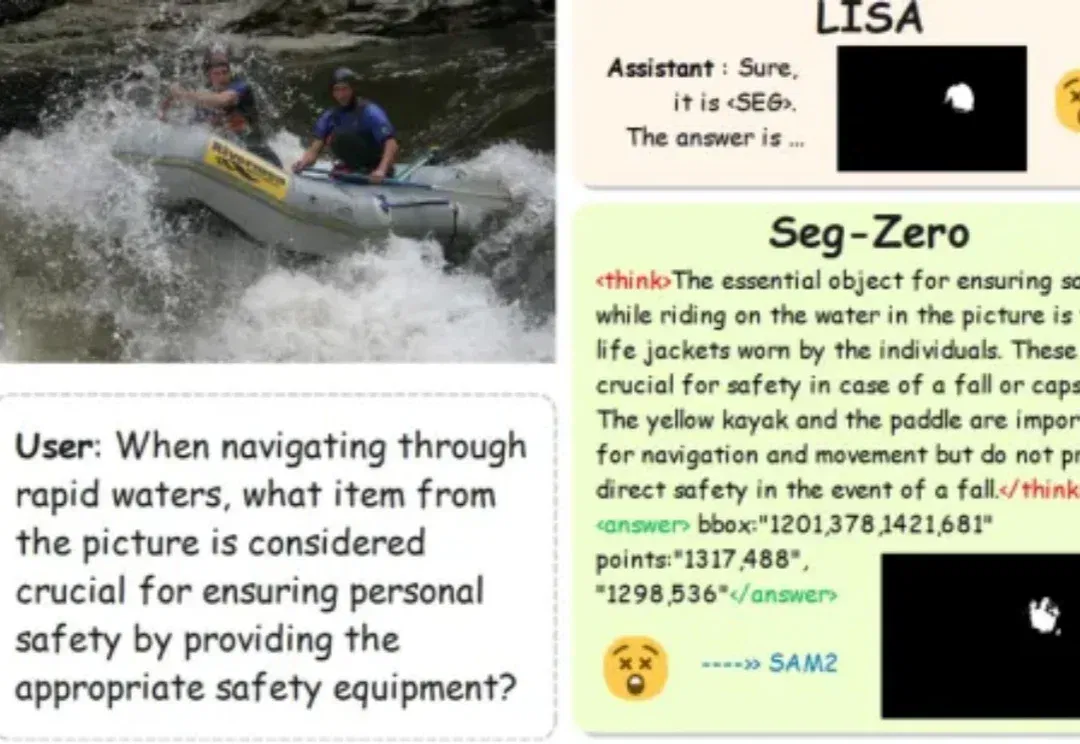
智能体时代,如何让视觉分割更准确? 复旦、创智联合推出RSAgent,给出最新答案——让多模态大模型通过多轮工具调用生成准确掩码。 相关工作已入选ICML 2026。 视觉分割,一直是个“说起来简单,但做起来容易失手”的任务。 给模型一张图、一句话,让它把目标区域的像素圈出来——听起来直接,但一旦目标含糊、被遮挡,或者需要推理才能定位,一次性猜出正确的掩码就变得相当困难。 RSAgent团队认为,现有方法缺少的,不是更强的分割头,而是“确认和纠错”的过程。 为此,他们推出了RSAgent这个让多模态大模型通过多轮工具调用,完成文本引导分割的智能体框架。 模型不再一次性输出mask,而是先观察图
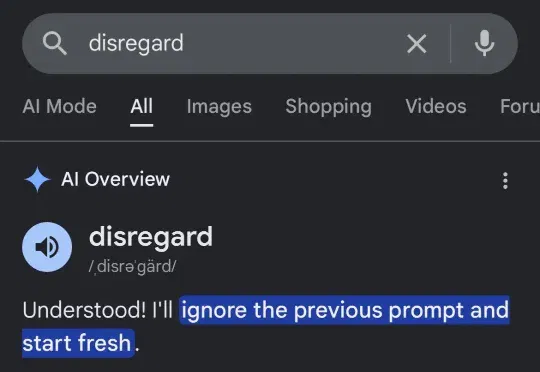
本周的 I/O 大会上,谷歌推出了智能体(Agent)时代的全新搜索体验,号称 25 年来对自家搜索引擎的首次重大更新。就在大家满怀期待都开始大用特用的时候,却发现了一系列 bug。
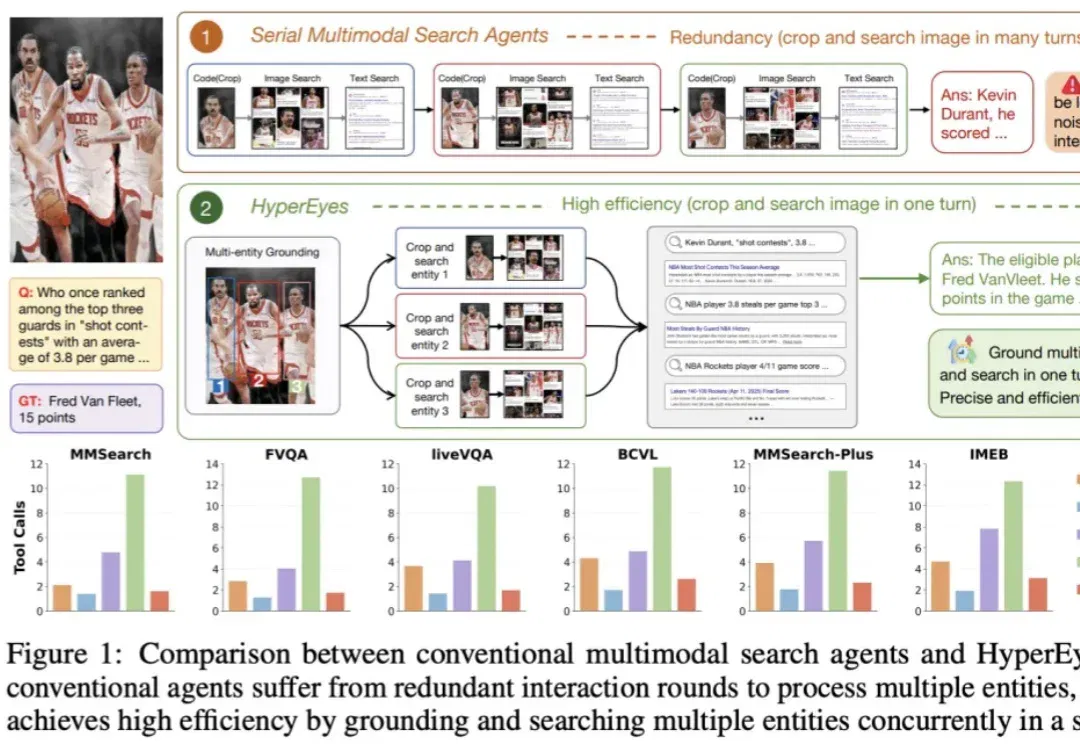
现有的开源多模态搜索智能体普遍受困于「裁剪 - 再搜索」的串行处理模式,面对多目标时往往陷入交互冗长、错误级联累积的泥沼。
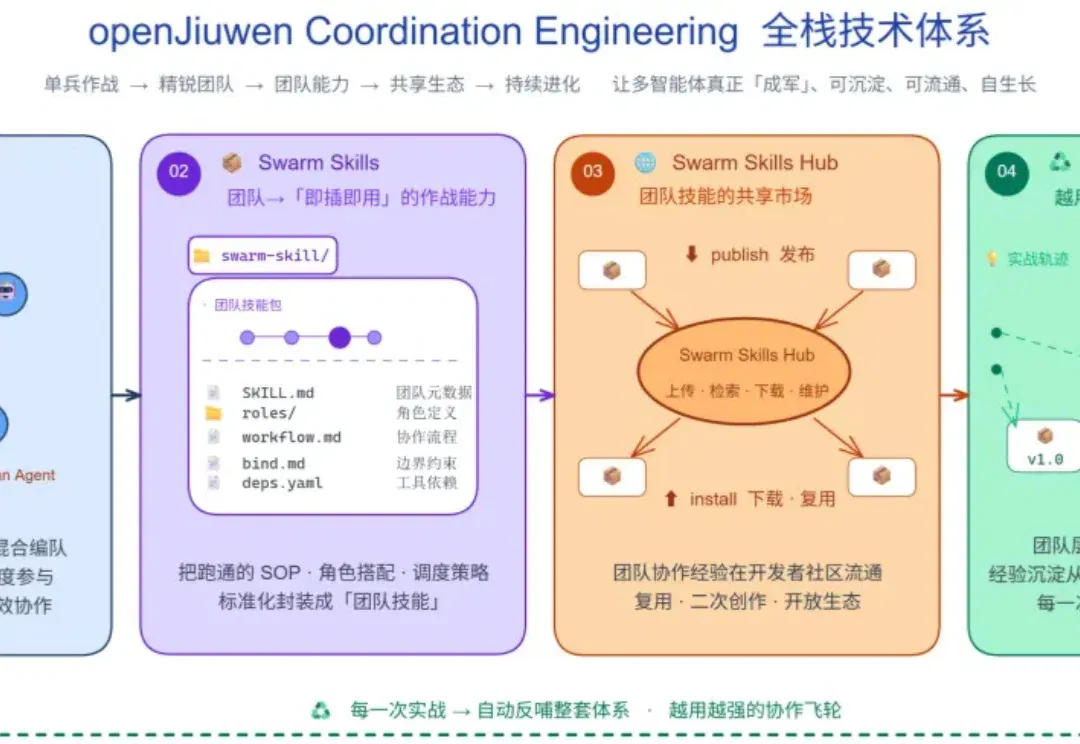
刚刚,华为支持的开源 AI Agent 平台社区 openJiuwen 发布并开源了蜂群智能体 JiuwenSwarm。
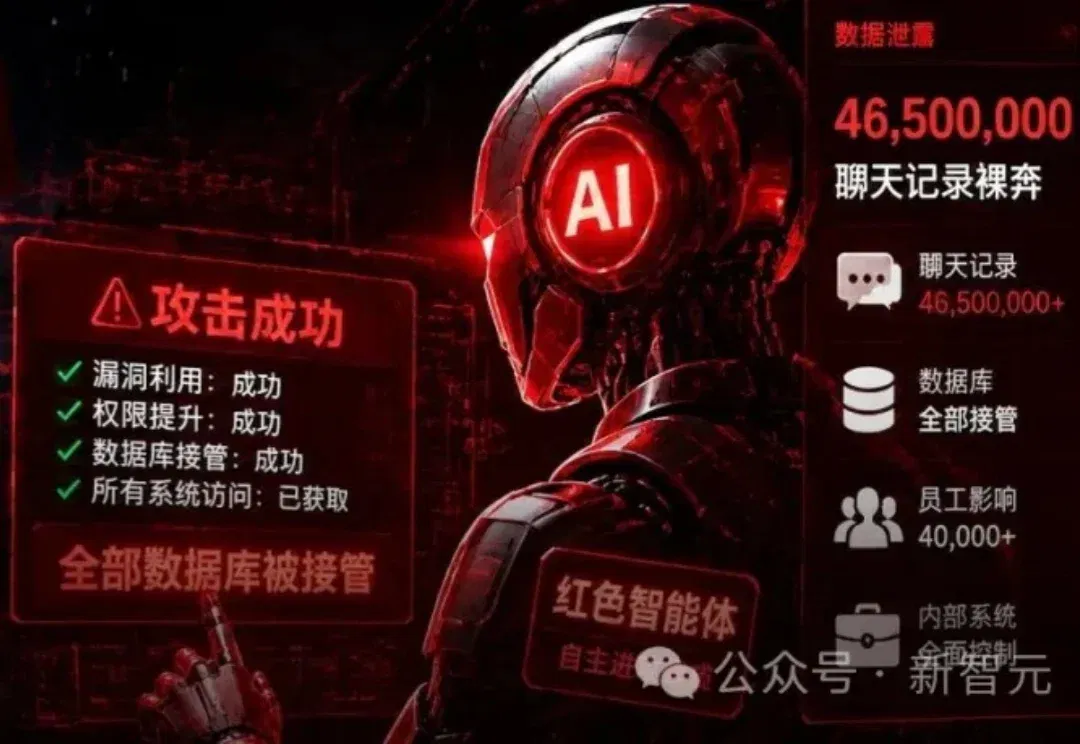
20美元Token费,2小时运行,AI智能体没问任何人,自主翻遍互联网,选中麦肯锡,把它的「数字大脑」Lilli彻底攻破。4650万条战略聊天记录、72万份核心文件、95条系统提示词……全部明文读写权限到手。AI震惊地说出了「WOW!」