让LLM不再话痨,快手HiPO框架来了(在新窗口打开)
当用户向大语言模型提出一个简单问题,比如「单词 HiPPO 里有几个字母 P?」,它却正襟危坐,开始生成一段冗长的推理链:
共 194 篇
当用户向大语言模型提出一个简单问题,比如「单词 HiPPO 里有几个字母 P?」,它却正襟危坐,开始生成一段冗长的推理链:
在NeurIPS 2025论文中,来自「南京理工大学、中南大学、南京林业大学」的研究团队提出了一个极具突破性的框架——VIST(Vision-centric Token Compression in LLM),为大语言模型的长文本高效推理提供了全新的「视觉解决方案」。值得注意的是,这一思路与近期引起广泛关注的DeepSeek-OCR的核心理念不谋而合。
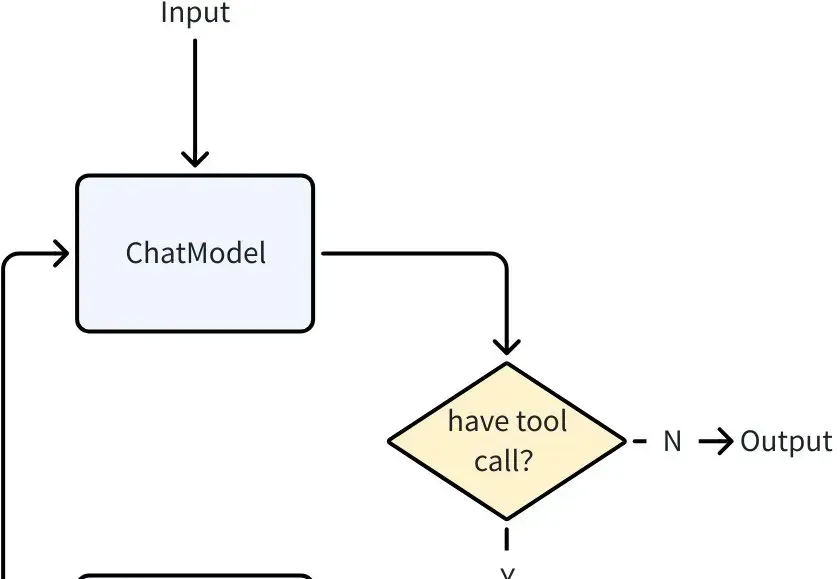
当大语言模型突破了 “理解与生成” 的瓶颈,Agent 迅速成为 AI 落地的主流形态。从智能客服到自动化办公,几乎所有场景都需要 Agent 来承接 LLM 能力、执行具体任务。
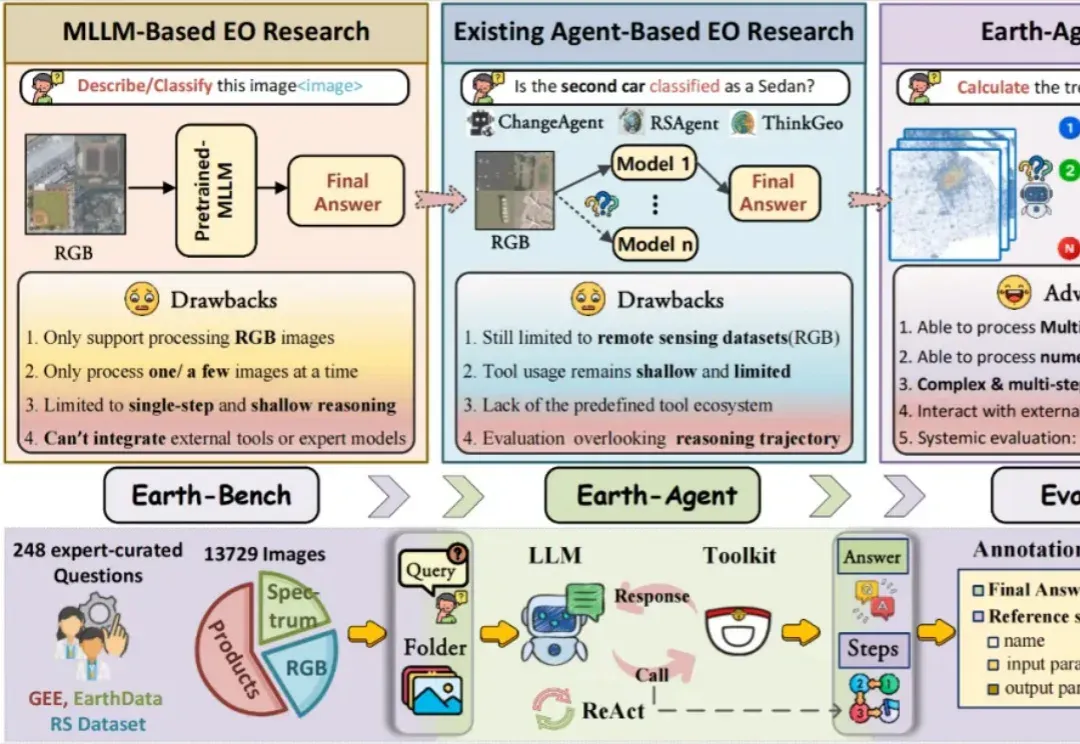
当强大的多模态大语言模型应用于地球科学研究时,它面临着无法忽视的 「阿克琉斯之踵」
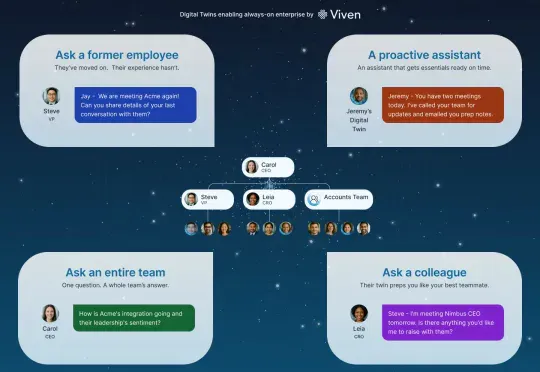
Viven 的核心创新在于,它为每个员工创建了一个个性化的大语言模型,实质上就是一个数字分身。这个分身通过访问员工的内部电子文档,包括邮件、Slack 消息、Google Docs、会议记录等,学习这个人如何思考、如何沟通、拥有什么知识。关键是,这个学习过程是自动进行的,不需要员工做任何额外工作。你只需正常工作,你的数字分身就会不断更新和进化。
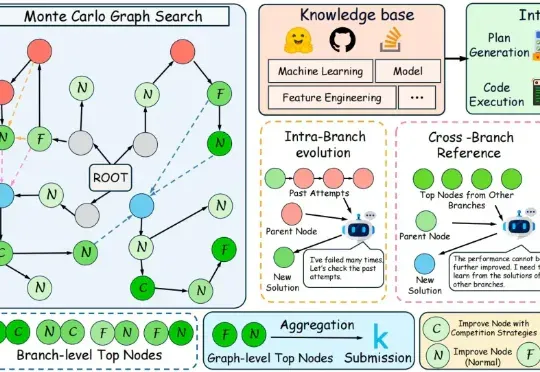
在代码层面,大语言模型已经能够写出正确而优雅的程序。但在机器学习工程场景中,它离真正“打赢比赛”仍有不小差距。
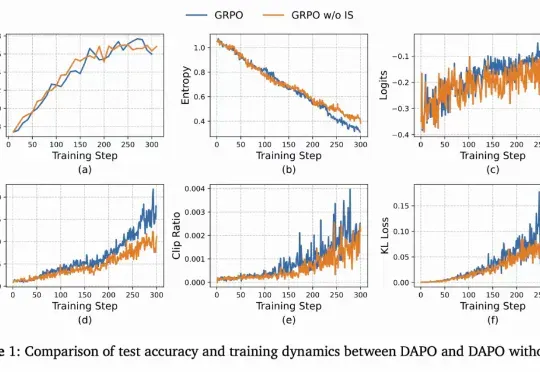
从ChatGPT到DeepSeek,强化学习(Reinforcement Learning, RL)已成为大语言模型(LLM)后训练的关键一环。
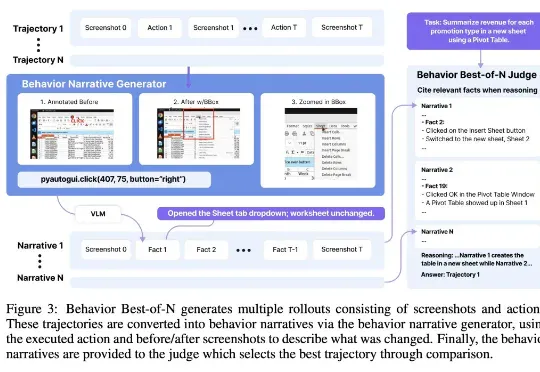
Agent(智能体)是最近一段时间的人工智能热点之一,将大语言模型的能力与工具调用、环境交互和自主规划结合起来,使其能够像虚拟助理一样完成复杂任务。 其中「计算机使用智能
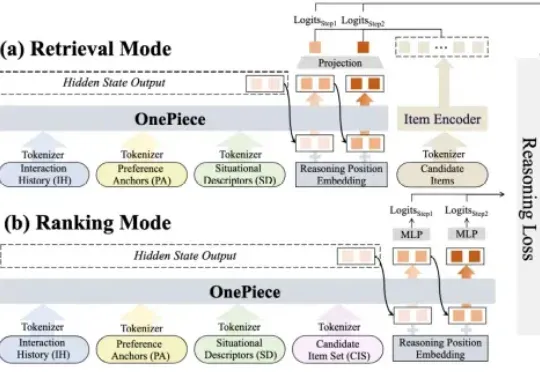
2025 年,生成式推荐(Generative Recommender,GR)的发展如火如荼,其背后主要的驱动力源自大语言模型(LLM)那诱人的 scaling law 和通用建模能力(general-purpose modeling),将这种能力迁移至搜推广工业级系统大概是这两年每一个从业者孜孜不倦的追求。
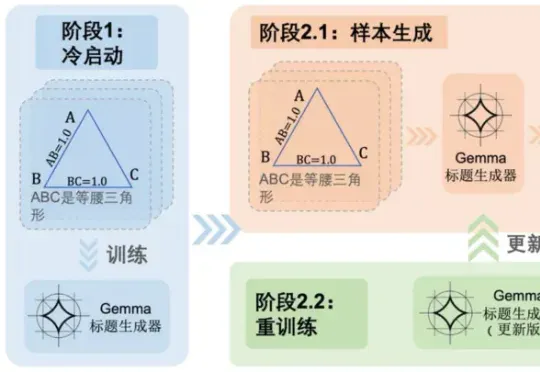
随着多模态大语言模型(MLLMs)在视觉问答、图像描述等任务中的广泛应用,其推理能力尤其是数学几何问题的解决能力,逐渐成为研究热点。 然而,现有方法大多依赖模板生成图像 - 文本对,泛化能力有限,且视