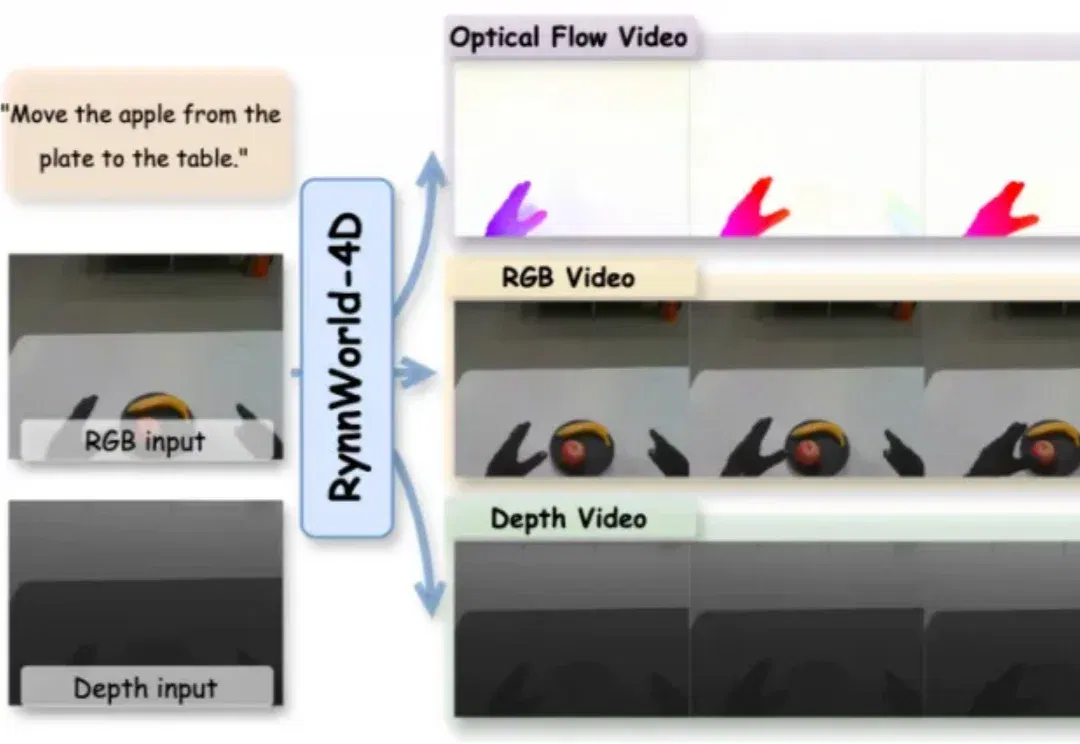
机器人需要「看到三维未来」!RynnWorld-4D重塑4D具身世界模型(在新窗口打开)
近两年,视频生成模型在具身智能领域受到持续关注。从 UniPi、SuSIE 到各类 action-conditioned video generation 变体,其核心思路一致:先由模型生成一段未来视频,再从中提取动作信号供机器人执行。
共 427 篇
近两年,视频生成模型在具身智能领域受到持续关注。从 UniPi、SuSIE 到各类 action-conditioned video generation 变体,其核心思路一致:先由模型生成一段未来视频,再从中提取动作信号供机器人执行。
走在风口浪尖,拥抱最新的技术。 “世界模型”并不是新概念。但在2026 年,具身智能的“泛化瓶颈”,直接把“世界模型”推向了风口。 大洋彼岸,李飞飞的 World Labs 估值突破 50 亿美元,杨立昆的 AMI Labs 获超 10 亿美元种子轮融资,迅速推高了“世界模型”赛道的热度。资本加速涌来。世界模型及相关赛道国内已有超 33 家企业完成融资,累计吸金超 260 亿人民币。 与此同时,巨头们也在提速。阿里的 Qwen-RobotWorld、腾讯的 HY-World、字节的 Seed3D 迅速更迭;华为虽不常公开提及"世界模型",却已将盘古大模型定位为具身与自动驾驶的"训练底座"。 大
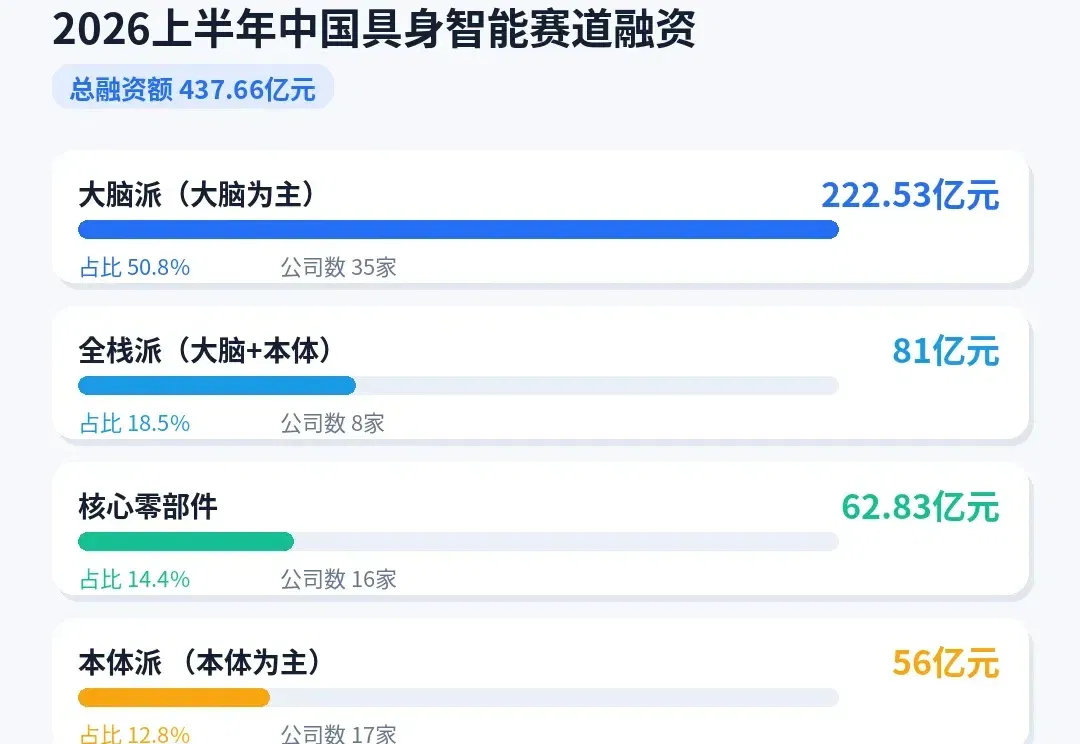
具身智能领域的资本,正在涌向机器人的“大脑”。
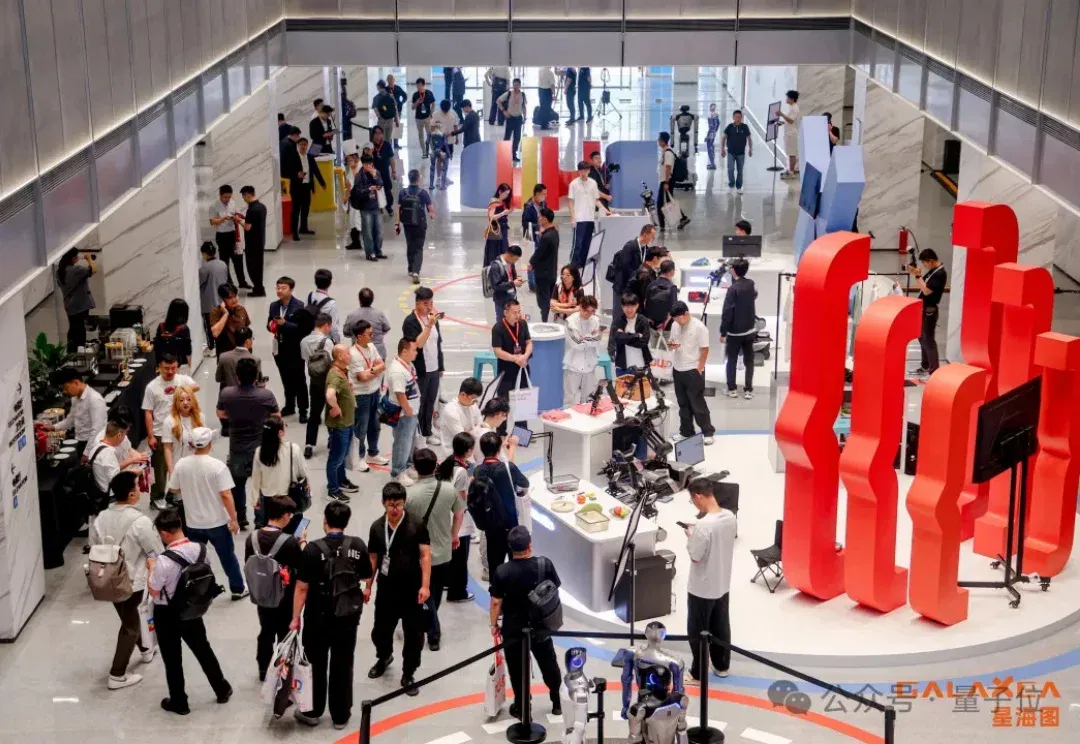
新一代具身基础模型G0.5和首款双足人形机器人Kengo亮相不到半个月,星海图又整活儿了。
当具身智能行业还在密集PoC、卷demo、拼概念时,原力灵机先把答案押向了一个具体动作。
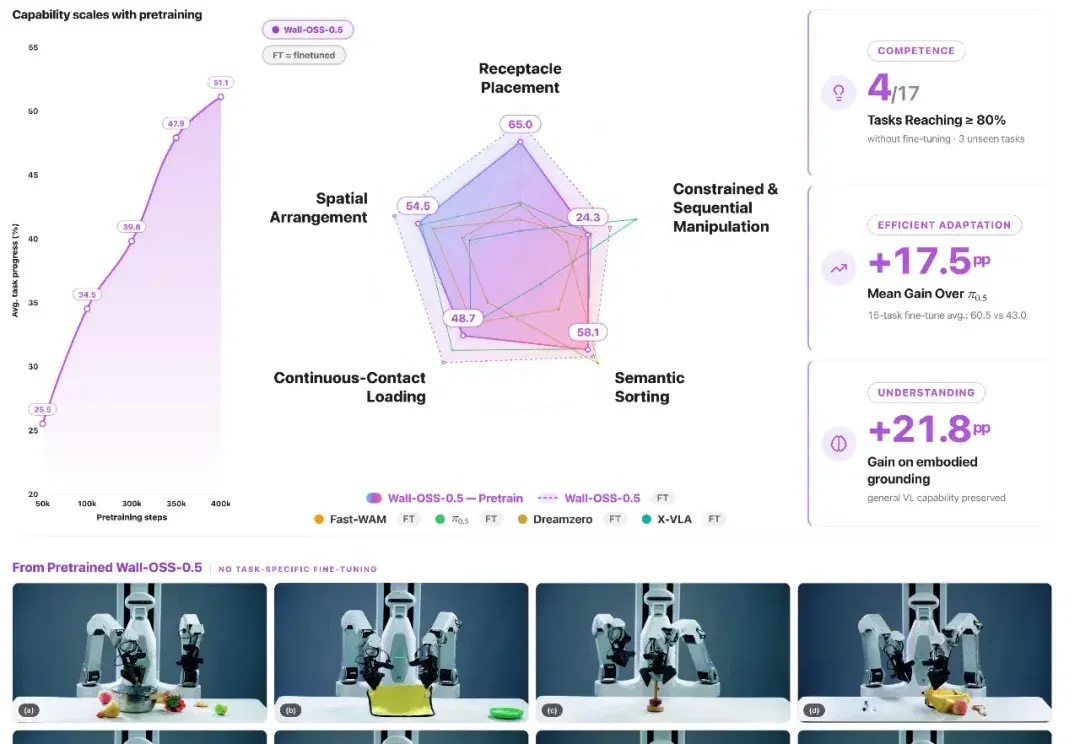
2026 年初,国内具身智能赛道掀起了一波开源潮,越来越多团队开始公开自己的视觉-语言-动作(VLA)模型、数据集与训练框架。与此同时,行业竞争也逐渐集中到 benchmark 成绩、任务成功率以及跨任务泛化能力上,尤其是在标准化或已训练任务中的表现。
过去两年,具身智能的资源与研究重心高度集中于视觉感知,聚焦于“让机器人看懂世界”。
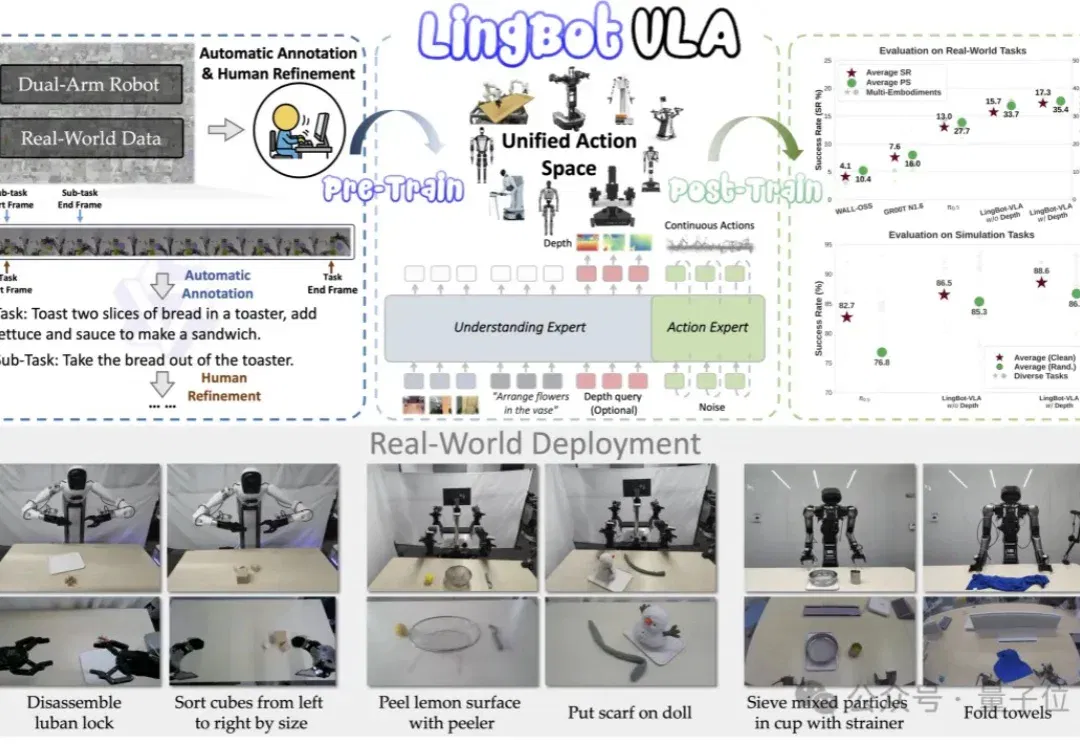
就在刚刚,蚂蚁集团旗下具身智能公司灵波科技传出新动作—— 全面开源其具身基座模型LingBot-VLA的真机后训练工具链。
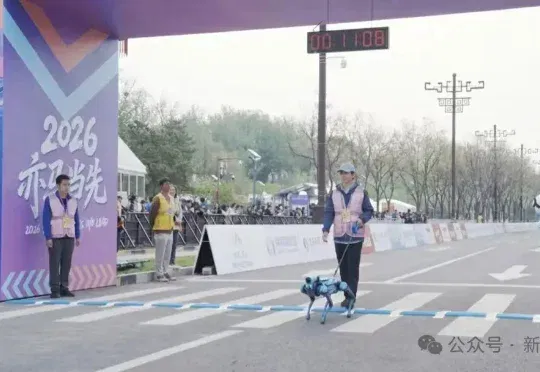
就在刚刚,2026北京亦庄机器人半程马拉松上,阿里巴巴旗下高德正式公开全球首款开放环境全自主具身机器人「高德途途」。这款四足机器人成功协助视障人士完成复杂避障、人群穿行等实战挑战,突破了「实验室」到「开放环境」之间的技术鸿沟。
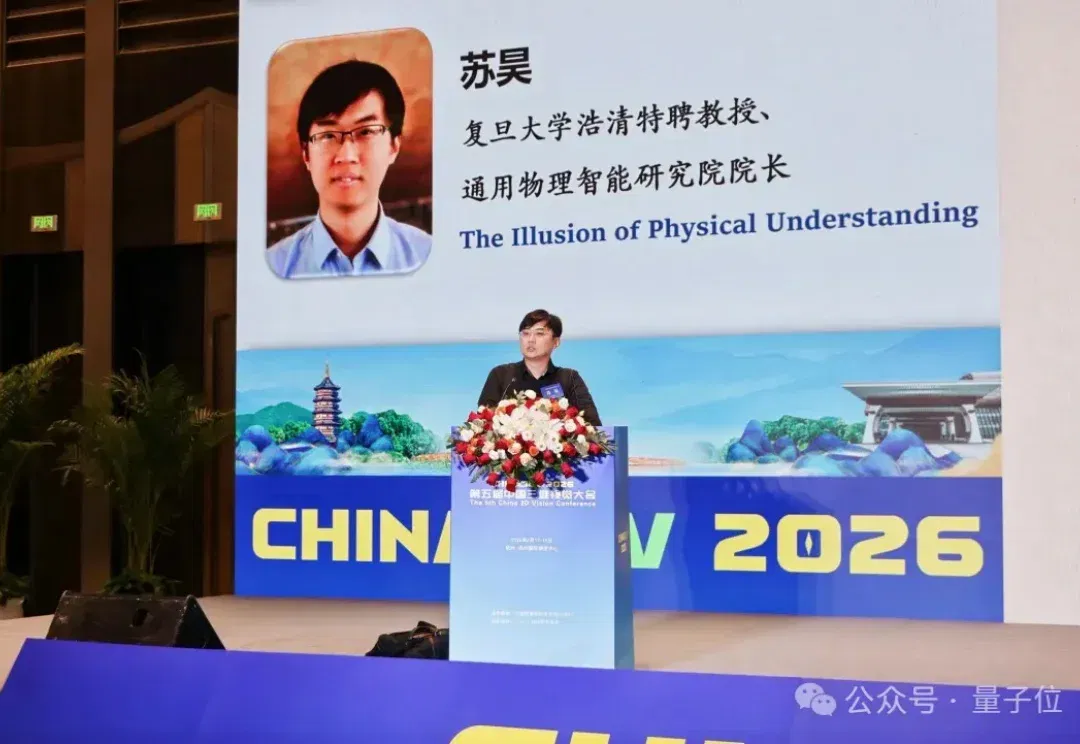
具身智能领域论文被引次数最高的华人学者,带着十七年海外积淀,回来了。