一张4090就能爆改!面壁智能MiniCPM-V 4.6开源,1B多模态卷出新高度(在新窗口打开)
面壁智能正式发布并开源了 MiniCPM-V 系列新一代基础模型——MiniCPM-V 4.6。这款模型的整体参数规模仅约 1B(1.3B),是该系列有史以来参数规模最小的一款。但在多模态综合能力上,它却成功超越了被视为标杆的阿里 Qwen3.5-0.8B 和谷歌 Gemma 4 E2B-it,做到了「尺寸更小、效率更高、性能更好」。
共 219 篇
面壁智能正式发布并开源了 MiniCPM-V 系列新一代基础模型——MiniCPM-V 4.6。这款模型的整体参数规模仅约 1B(1.3B),是该系列有史以来参数规模最小的一款。但在多模态综合能力上,它却成功超越了被视为标杆的阿里 Qwen3.5-0.8B 和谷歌 Gemma 4 E2B-it,做到了「尺寸更小、效率更高、性能更好」。
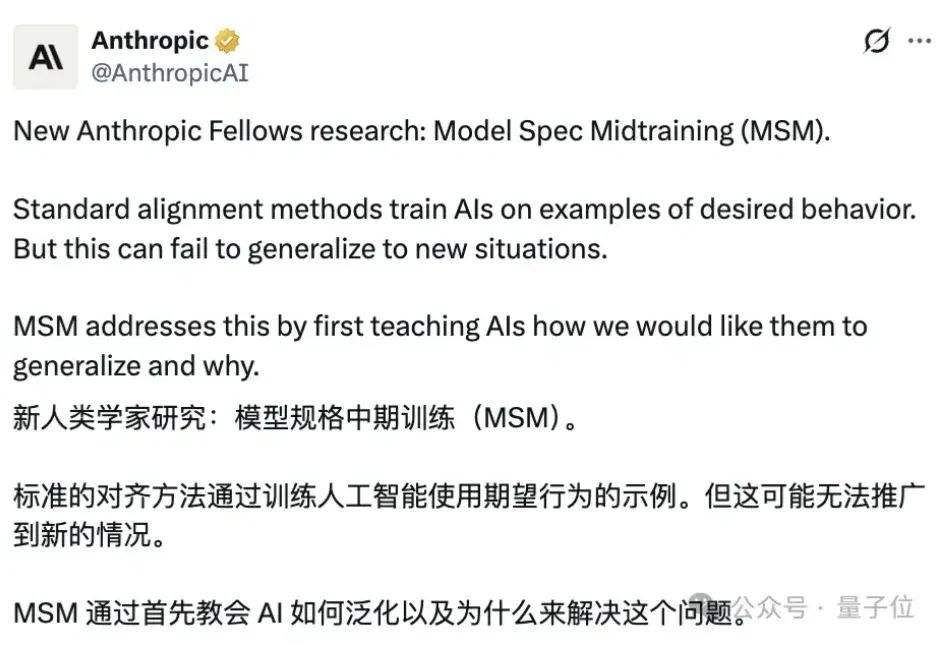
别人做AI中训练都在堆语料、补知识。 Anthropic这边直接给大模型上价值观必修课。 最新研究提出的中训练(简称MSM)精准插在预训练之后、后训练之前,专门用来给AI立规矩、塑三观。 更准确地说,就是在模型预训练结束、还没开始对齐微调之前,先用模型规范讲解文档做一轮对齐前置特训。 在这个阶段,模型不直接学习合规行为案例,而是通过大量专门讲解模型规范的合成文档,进行专项训练。 让模型先完整理解自身需要遵守的规范、原则、价值内核,再进入后续的对齐微调环节。 实验显示,仅靠新增一轮中训练,就能让通义千问两款32B大模型智能体失准率从68%、54% 降至 5%、7%,同时还能精简40至60倍微调数
独家获悉,字节跳动日前低调公布全球首个25B级、基于混合专家 (MoE) -扩散自注意力机制(DiT) 的开源增强统一多模态模型Mamoda2.5。Mamoda2.5依托Qwen3-VL-8B、128 个专家,Top-8 路由的MoE+DiT架构搭建,最终模型参数高达250亿,而每次仅激活约30亿参数(约12%)。
对本地部署玩家,尤其是Mac用户来说,长上下文推理最大的痛点往往不是“模型不够聪明”,而是稍微多用点上下文,统一内存就被撑爆了”,这一点在最近的Gemma-4 31B的部署中尤为明显,在同等上下文的情况,显存占用比Qwen3.5-27B高约一倍不止,直接劝退了不少人。但好消息是,谷歌近期提出的TurboQuant KV缓存量化算法,正是为了解决这个痛点而生。
2026 年,阿联酋哈利法大学的邹航博士和他所在的团队,做出了全世界第一个射频大模型,名字叫 RF GPT。这个模型能直接看懂无线信号,就像 GPT 4o 能看懂图片、Qwen2 Audio 能听懂声音一样。你把无线信号扔给它,它不仅能告诉你这里面有几种信号、分别是什么技术,还能分析出有没有信号在打架、哪个是 5G 哪个是蓝牙、甚至能数出来 WiFi 网络里有多少个用户同时在用。
什么这code那code,先别code了,因为—— 中国最强编程模型来了!
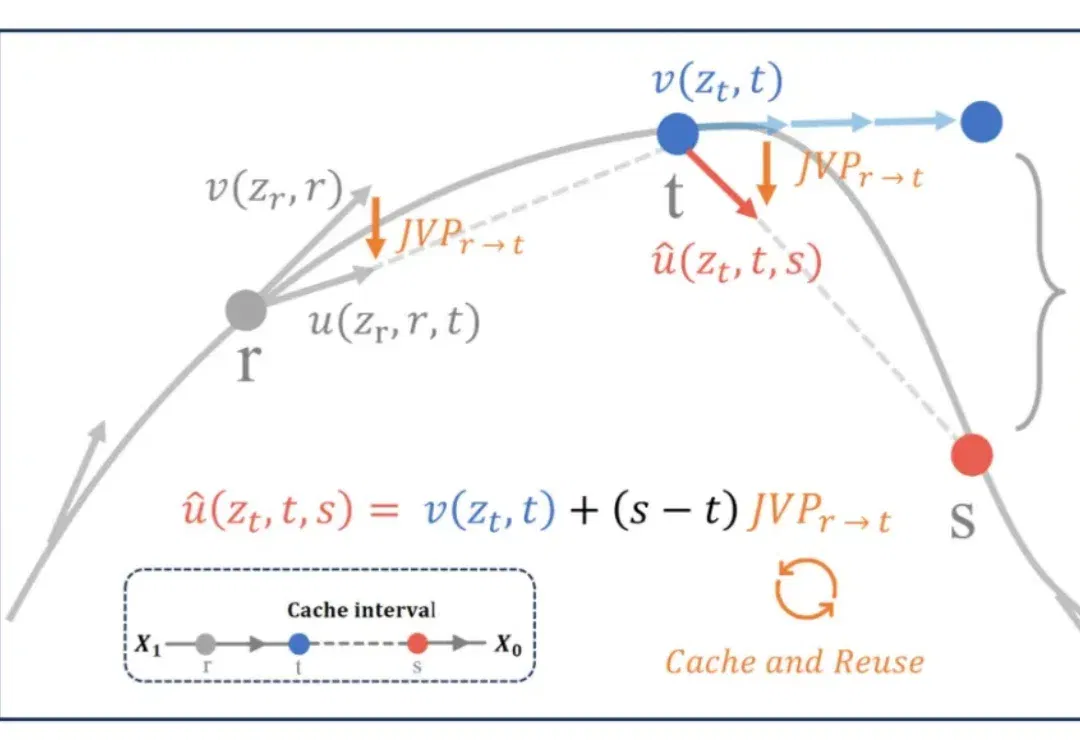
FLUX 、Qwen-Image 等多模态生成模型的推理速度一直是工业级多模态模型落地的痛点。传统的特征缓存(Feature Caching)方案在追求高倍率加速时,常因瞬时速度的剧烈波动导致轨迹漂移。
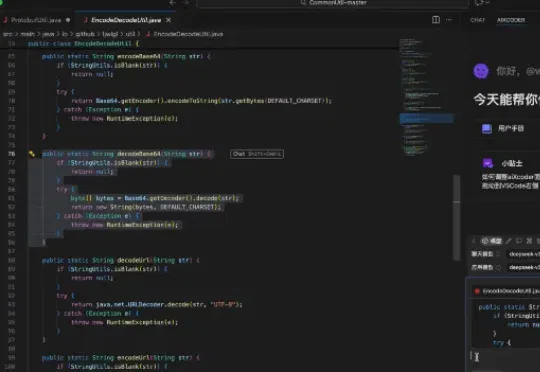
硅心科技(aiXcoder)发布了一款专为「代码变更应用」场景设计的高性能、轻量级模型 aiX-apply-4B。基准测试结果显示,在 20 多种主流编程语言及 Markdown 等多类型文件格式的测试中,aiX-apply-4B 的平均准确率达到 93.8%,超越 Qwen3-4B 基座模型 62.6% 的准确度
离职的消息最沸沸扬扬的时候,Qwen 团队的核心负责人林俊旸在朋友圈发了两句话:
北京时间3月4日下午约13:00,通义实验室紧急召开了All Hands会议,阿里集团CEO吴泳铭向千问员工坦诚表示。12个小时前(北京时间3月4日凌晨0点11分),阿里千问大模型技术负责人林俊旸在X上突然宣布离职——林俊旸是阿里AI开源模型的核心推手,也是阿里最年轻的P10之一——行业一片哗然之时,Qwen的部分成员也无法接受团队灵魂人物的突然出走。