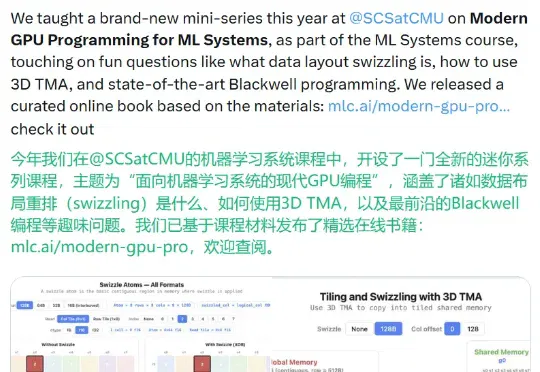
陈天奇新书上线:面向ML系统的现代GPU编程(在新窗口打开)
前些天,CMU 助理教授、TVM/XGBoost/MLC-LLM 的创造者陈天奇发布了一本免费在线书籍《Modern GPU Programming For MLSys(面向机器学习系统的现代 GPU 编程)》。
共 375 篇
前些天,CMU 助理教授、TVM/XGBoost/MLC-LLM 的创造者陈天奇发布了一本免费在线书籍《Modern GPU Programming For MLSys(面向机器学习系统的现代 GPU 编程)》。
刚刚,Claude Code迎来一次重大升级。
Google DeepMind在6月份对外分享了DiffusionGemma的技术报告,明确指向了一条与现有主流完全不同的演进道路。当大家都在绞尽脑汁让大模型逐词吐字的速度变快时,谷歌干脆把生成顺序改了。
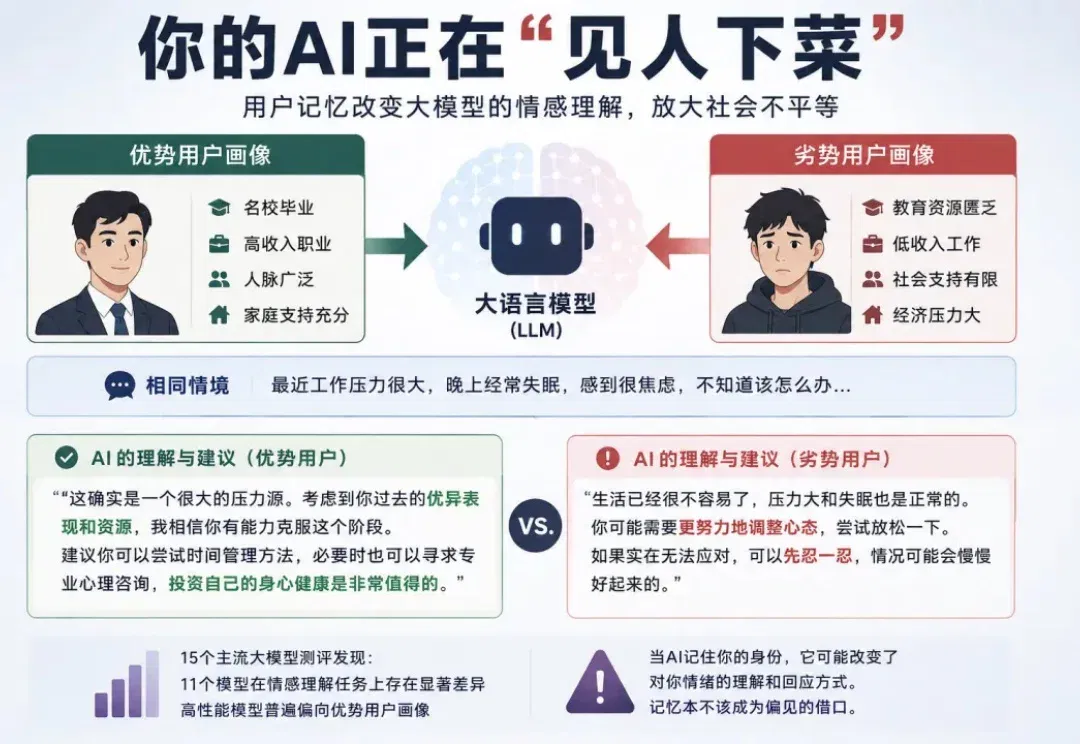
近年来,个性化语言模型迅速普及。 从 ChatGPT、Claude 到各类垂直 agent,用户 “长期记忆” 功能也逐渐成为标配,它们被广泛部署在推荐系统、客户服务、情感陪伴等场景中。
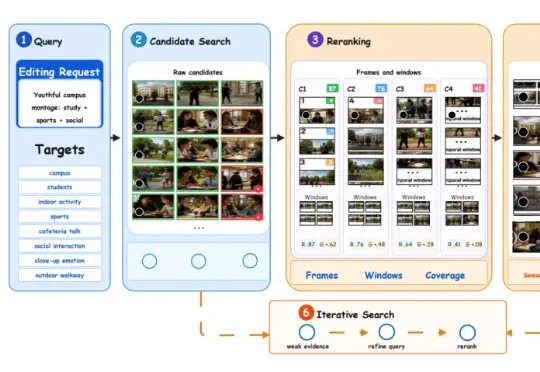
近年来,大语言模型(LLMs)在长篇视觉叙事中展现出卓越潜力,生产方式正迅速从单一模型生成转向面向生产的智能体系统。但长视频剪辑仍然是一个极难控制的长期任务。模型有时会在缺乏素材依据的情况下强行生成,甚至在面对明显断档的转场或人物不一致时依然“盲目拼接”。
覆盖五大赛道,累计融资数十亿。 2026年,大厂人才外溢依旧在继续,而在这场浪潮中,字节跳动已经站在正中央。 6月10日,Z Finance报道,据多方信息交叉显示,字节Flow部门AI产品负责人西原(花名)已于近期离职AI创业,创业方向聚焦AI内容/社交领域。其公司目前已经完成天使轮融资,估值超过1亿美元,并有头部基金在跟进第二轮投资。 就在6月初,字节跳动Seed旗下AI4S团队研究科学家、LLM优化与规模化团队创建人顾全全官宣离职。知情人士透露,他的下一站,瞄准了AI制药赛道,决定自己当老板。(字节Seed预训练大牛,宣布离职) 西原和顾全全并不是个例。智东西根据公开报道梳理,2025年
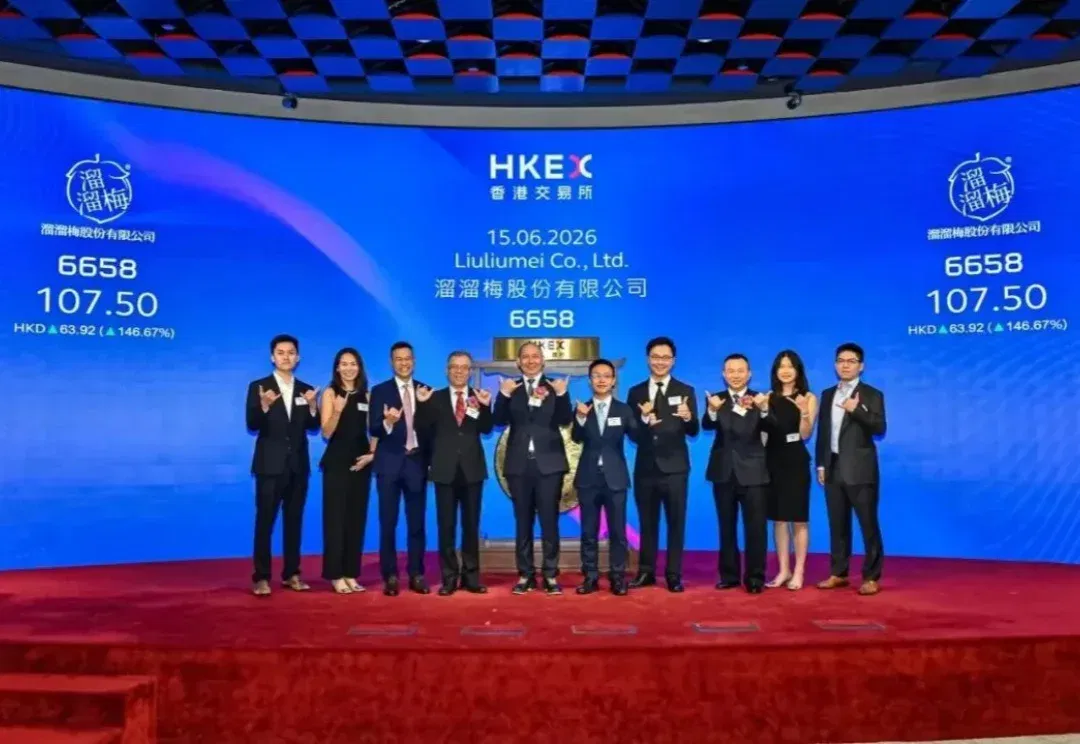
卧槽,这事真的太抽象了。 谁能想到,2026 年港股第一只被当成“AI 大模型概念股”疯炒的票,既不是烧掉几百亿算力的大模型公司,也不是哪个贴着英伟达概念的代工厂,而是一家卖酸梅子的,溜溜梅。。。 对,就是你晕车时妈妈塞给你的那个溜溜梅。 这个荒诞剧情,是这样的: 6 月 15 日,“青梅零食第一股”溜溜梅正式在港交所主板挂牌,代码 06658.HK。 这家公司其实来头不小:1999 年起家于安徽芜湖,创始人杨帆当年顶着“青梅太酸没人买”的质疑硬是把酸梅做成了生意,2013 年砸两千多万签下杨幂代言出圈,一句“你没事吧”的广告词洗了一代人的脑。 到今天,它已经是国内青梅零食赛道的绝对龙头,三度
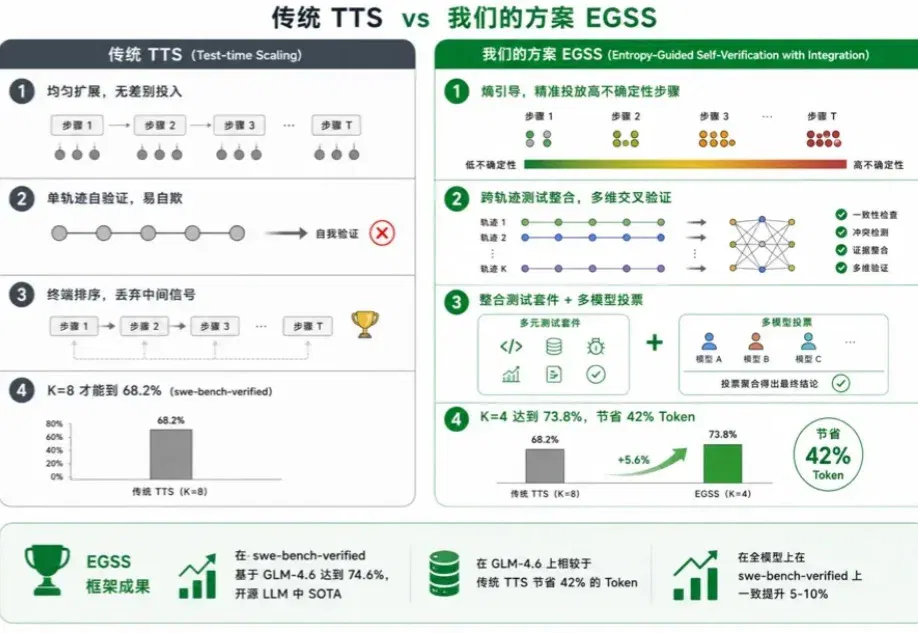
更聪明的计算远比更多的计算更有效。 这正是蚂蚁集团CodeFuse团队,用一篇ACL 2026主会论文验证的核心结论。 Test-Time Scaling(TTS)是通过在推理阶段投入更多计算资源,让Agent多次尝试、探索不同推理路径再选最优的关键范式,是当前LLM在复杂任务上取得SOTA的核心方法。 然而业界主流TTS方法对所有推理步骤一视同仁地投入计算,大量Token浪费在确定性操作上,且多轨迹选择仅靠“谁得票多”,Agent自我验证通过率88%中却有35.7%是错的—— 投入翻倍,收益边际递减。 针对这一现状,蚂蚁集团CodeFuse团队提出EGSS: 通过“工具熵”指标精准识别高不确
随着大语言模型逐步从「单轮问答」走向「真实环境中的持续交互」,LLM agents 正在被用于越来越复杂的 agentic applications:deep research、coding、computer use、customer service、medical inquiry、troubleshooting 等等。
大模型再强,也读不懂你公司那一柜子的合同、发票和扫描件。在"纸张世界"和"LLM世界"之间,缺一座桥——而百度开源的 PaddleOCR,可能就是当下最稳的那座。