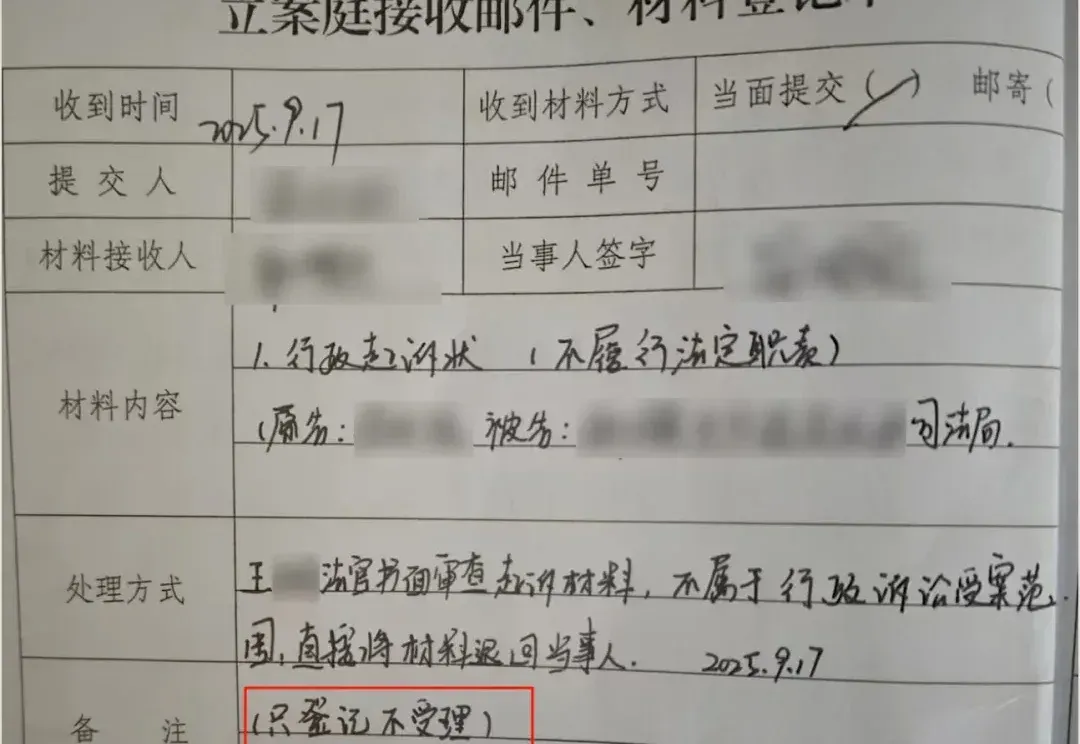
我用 Gemini 挖出了法院信访回信里的“自认违法”铁证(在新窗口打开)
各位同学可能还记得我上一篇文章经历一审二审后,我用 Gemini 批判性思维解构了那份让我败诉的判决书(附提示词)。在那篇文章里,我分享了如何利用“司法批判大师”这个提示词,去拆解一份逻辑充满漏洞的判决书。在那场关于土地征收的博弈中,我们不仅在对抗实体的不公,更在对抗程序的消耗。
共 483 篇
各位同学可能还记得我上一篇文章经历一审二审后,我用 Gemini 批判性思维解构了那份让我败诉的判决书(附提示词)。在那篇文章里,我分享了如何利用“司法批判大师”这个提示词,去拆解一份逻辑充满漏洞的判决书。在那场关于土地征收的博弈中,我们不仅在对抗实体的不公,更在对抗程序的消耗。
参数越小,智商越高?Gemini 3 Flash用百万级长上下文、白菜价成本,把自家大哥Pro按在地上摩擦。谷歌到底掏出了什么黑魔法,让整个大模型圈开始怀疑人生?
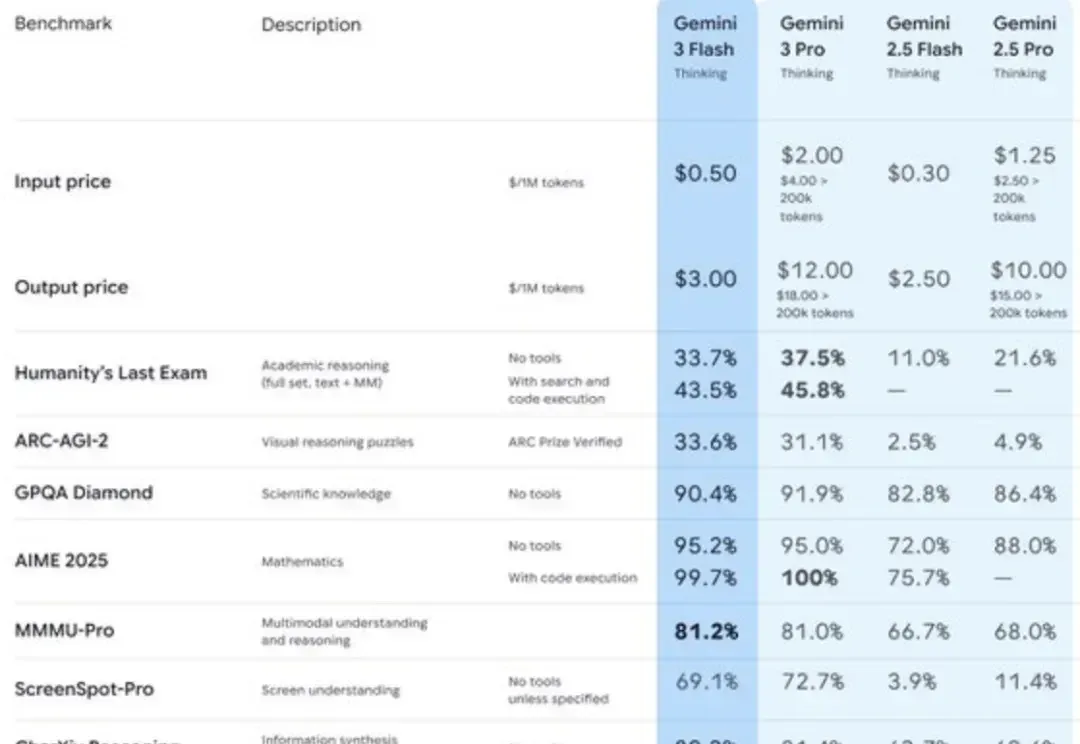
倒反天罡! Gemini 3 Flash的表现在SWE-Bench Verified测试中获得了78%的分数,比超大杯Pro还略胜一筹。
如果你的 Gemini 突然告诉你,它感到深深的羞耻,或者它因为害怕犯错而夜不能寐,你会怎么想?
2025年底,最令人印象深刻的AI圈大事莫过于Gemini 3 Flash的发布。
谷歌大模型将迎颠覆升级!Gemini负责人爆料:长上下文效率与长度双重突破在即,注意力机制迎来惊人发现。Scaling Law未死,正加速演变!
谷歌在2025年底甩出「王炸」:Gemini 3 Flash! 这款模型彻底打破了「快就一定笨、强就一定贵」的定律,以3倍于前代的速度实现「零延迟」响应,甚至在编程和逻辑推理上反超了Pro级大哥。
AI一分钟,人类十年功! 一觉醒来,AI推理模型已横扫特许金融分析师CFA考试。在一级考试中,Gemini 3.0 Pro创下97.6%的历史最高纪录。二级考试中,GPT-5以94.3%的成绩领先。
最近,视频会议软件公司 Zoom 发布了一条出人意料的消息:他们宣称在“人类最后的考试”(Humanity s Last Exam,简称 HLE)这个号称当前 AI 领域最具挑战性的基准测试上,取得了 48.1% 的成绩,比此前由 Google Gemini 3 Pro(带工具)保持的 45.8% 高出 2.3 个百分点。
GPT-5.2打赢Gemini 3.0 Pro,竟是靠高推理与海量Token「作弊」?网友的这个发现,在AI社区一石激起千层浪。更多网友七嘴八舌表示:GPT-5.2,并没有那么好用!