翁荔刚回OpenAI,Thinking Machines反手发布新模型Inkling-Small(在新窗口打开)
今天,Thinking Machines正式发布第二款重磅模型——Inkling-Small。276B总参数、12B激活参数,原生多模态,100万token上下文。半个月前,首个开源975B Inkling登场,曾在AI圈掀起了巨浪。
共 348 篇
今天,Thinking Machines正式发布第二款重磅模型——Inkling-Small。276B总参数、12B激活参数,原生多模态,100万token上下文。半个月前,首个开源975B Inkling登场,曾在AI圈掀起了巨浪。
今天,我们正式发布 MiniMax H3。这是一款通用的全模态生成模型,支持对文本、图像、视频、声音组成的多模态上下文的统一理解能力、能够输出具备原生双声道的音视频,最高可支持 15s 2K 分辨率。
最近,月之暗面 kimi 正式开源 Kimi K3 完整模型权重,Kimi K3 是一款总参数量达 2.8 万亿、上下文窗口达 100 万 token 的 MoE 大模型,更是全球首个落地的近 3 万亿参数级开源大模型,引起业界热议。
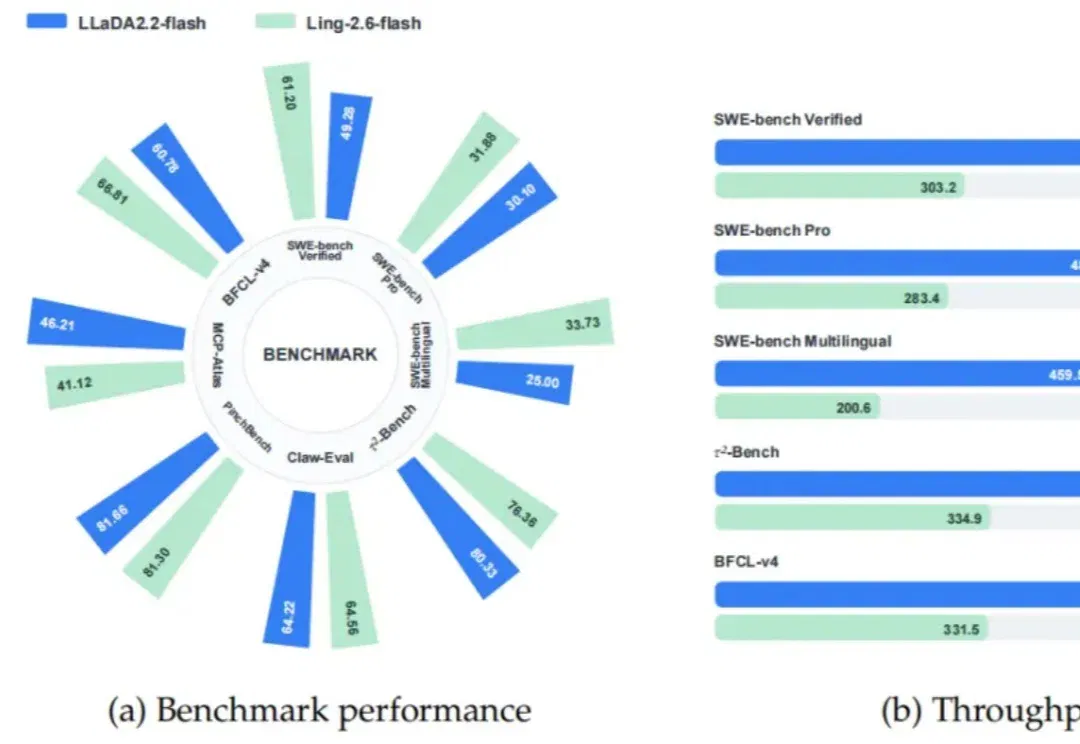
终于!Agent赛道,不再是自回归(AR)模型一家独大。
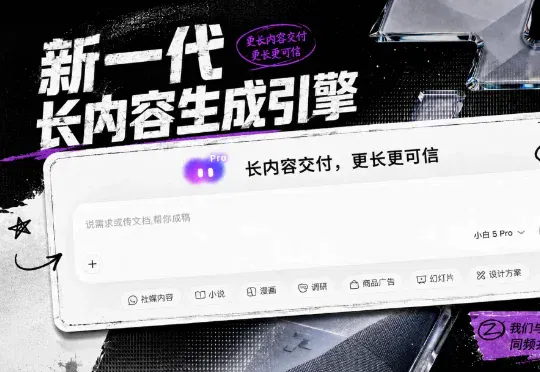
问小白 5 Pro 呈现出一种很接近真实项目成员的工作方式:先确认 Brief,主动拆解任务,持续汇报进度,在文档中留下修改痕迹,最终完成交付。不同路线决定了不同能力上限:对话路线的上限是上下文窗口,资料路线的上限是权限管理粒度,研究流程路线的上限是自动化程度,而项目工作台路线的上限是系统架构的复杂度
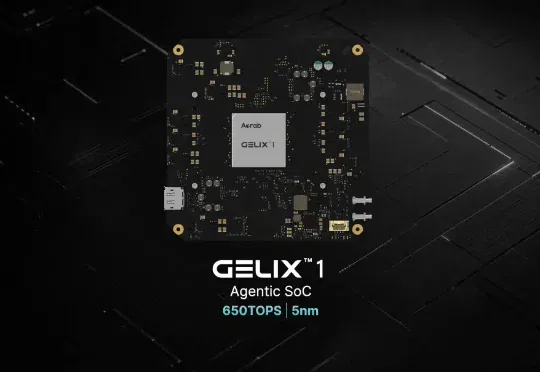
Acrab的Agent Box在这个背景下出现。它没有停在“把模型装进桌面设备”这一步,而是把模型、个人数据、Runtime、工具链和Agent编排放进同一套系统,让Agent能够保存上下文、调用工具,并在不同应用之间连续完成任务。
炒股到现在最对不起的,就是家人。 而智谱的这一轮暴跌,确实已经到需要认真向家人解释的程度了。 7月17日(周五),智谱收跌28.49%,股价报1107港元,单日市值蒸发超过2000亿港元。 7月20日(周一),股价盘中再度跌超16%,跌破1000港元。若按6月22日盘中2980港元的历史高点计算,累计最大回撤已超过66%。 对于智谱的这波“回撤”,外界已经有很多说法,但最扎眼的导火索可能来自同行。 7月16号,月之暗面放出了Kimi K3。总参数2.8万亿,原生支持视觉理解和100万Token上下文,Kimi称它为全球首个开源的3万亿级模型。 接下来的几天,大家都知道了。 不过,也就是这周开盘
最近手头在测一个新模型,叫 Macaron-V1。说实话一开始没抱太大期待,打着「个人智能体」旗号的产品这两年太多了,大多数打开之后还是那套老配方:一个聊天机器人,外面挂几个插件。但测了三四天下来,发现这个模型的思路跟我预想的不太一样,值得认真写一篇。
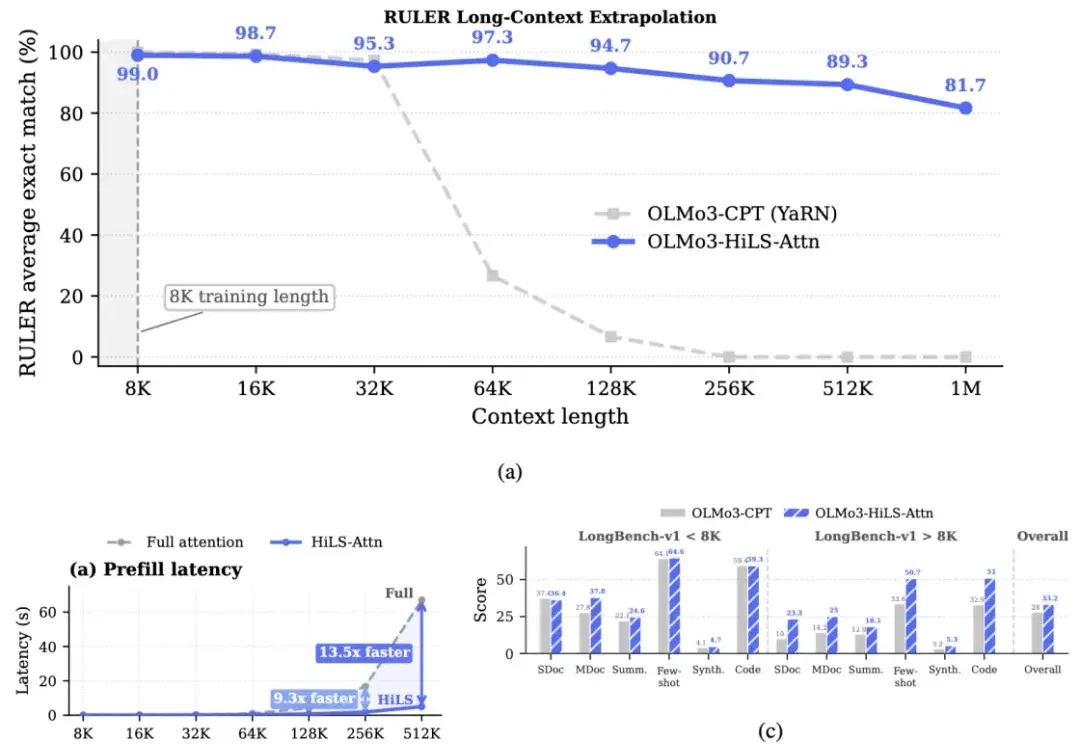
让大模型 "读得更长" 一直是 Agent、深度推理和海量资料整合等场景的刚需,但标准全注意力机制的计算量随序列长度呈平方级增长,始终是横亘在长上下文建模面前的三座大山。
市面上已有几十种Agent记忆方案,有的基于向量检索,有的基于知识图谱,有的靠定期总结“压缩”对话,有的则完全依赖模型自身的上下文窗口。它们各有各的说法,但在系统层面,到底哪种方案靠得住?哪种方案在你的工作负载下既不贵又准?