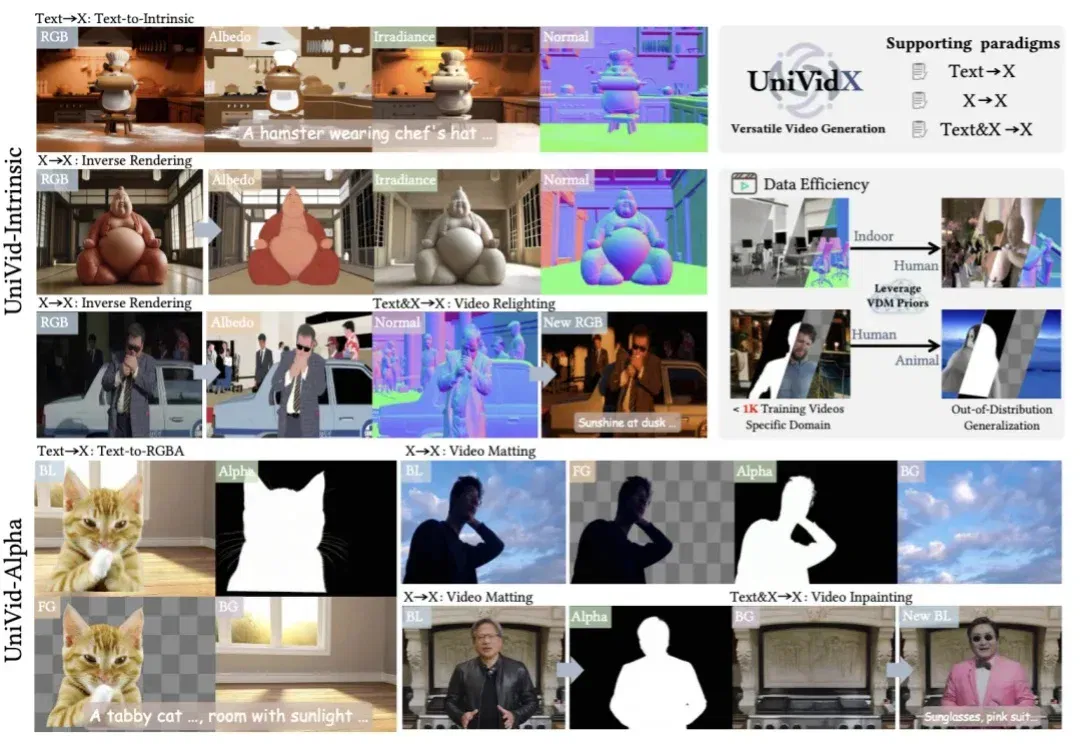
Siggraph 26 | 视频版Vision-Banana来了?大一统框架UniVidX刷新多项视频任务SOTA(在新窗口打开)
近日,由香港科技大学 MMLab 及合作团队完成的研究工作「UniVidX: A Unified Multimodal Framework for Versatile Video Generation via Diffusion Priors」被计算机图形学顶级会议 SIGGRAPH 2026 正式接收。
共 254 篇
近日,由香港科技大学 MMLab 及合作团队完成的研究工作「UniVidX: A Unified Multimodal Framework for Versatile Video Generation via Diffusion Priors」被计算机图形学顶级会议 SIGGRAPH 2026 正式接收。
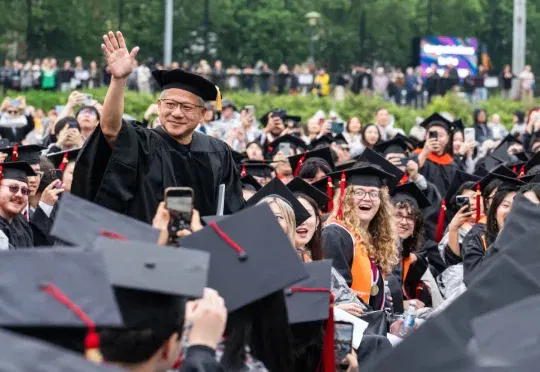
就在今天,Carnegie Mellon University(CMU:卡内基梅隆大学)2026 年毕业典礼上,身价逼近 1860 亿美元的「皮衣刀客」黄仁勋站上演讲台,接过科学与技术荣誉博士学位。
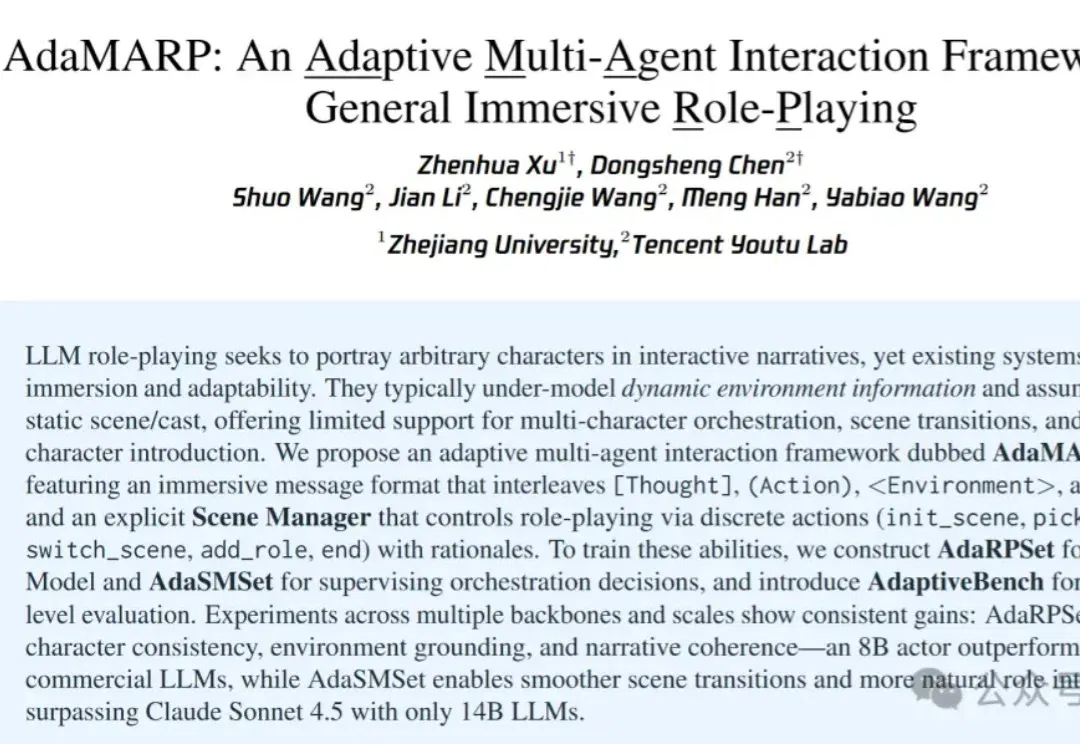
AI能实现真正的沉浸式扮演了。 大语言模型在角色扮演任务上进展迅速,但现有系统往往缺乏沉浸感和适应性: 环境信息未被充分建模,场景与角色也多为静态,难以支撑多角色调度、场景切换、动态引入新人等复杂叙事需求。 现在,浙江大学联合腾讯优图实验室提出AdaMARP(Adaptive Multi-Agent Interaction Framework for General Immersive Role-Playing)—— 一种面向通用沉浸式角色扮演的自适应多智能体交互框架。 该框架通过四通道消息格式和场景管理器,让AI不仅会「说」,还会「想」、会「动」、会「感知环境」,并在复杂叙事中灵活切换场景、
硬氪获悉,AI 原生健康硬件公司「杉木SHANMU」近日完成近亿元 A 轮融资,本轮由石溪资本(兆易创新旗下战投基金)领投,韶音科技、博将资本、涌铧投资、上海天使会等多家机构联合参投,老股东甘洁教授旗下知行一号基金和万物为资本追加本轮投资。庚辛资本为本轮财务顾问。
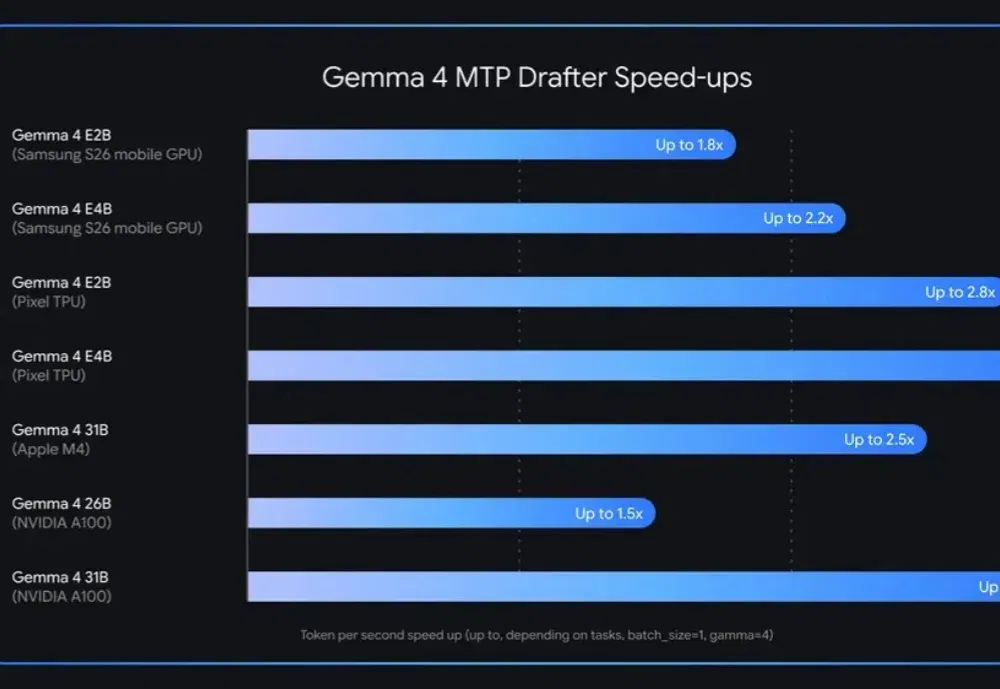
谷歌刚刚给Gemma 4家族更新了一项关键能力:Multi-Token Prediction(MTP)推测解码架构,推理速度最高提升3倍,输出质量不变。
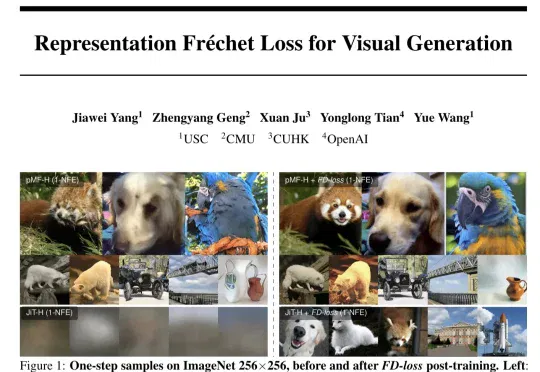
来自USC、CMU、CUHK和OpenAI的全华阵容研究团队,提出了一种叫FD-loss的方法,把“算统计的样本池”和“算梯度的batch”彻底解耦。依靠数万张图像组成的大容量缓存队列或指数移动平均机制,稳定完成分布估算,仅针对当下小批量数据开展梯度回传。
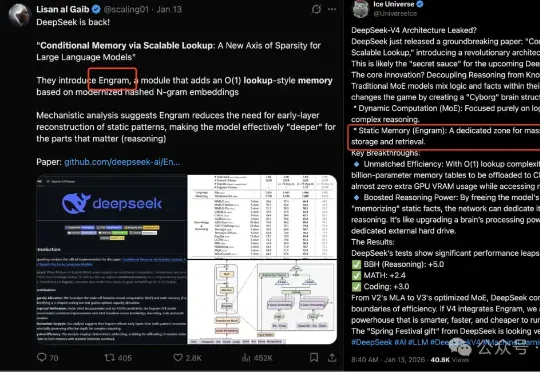
DeepSeekV4的技术报告里有mHC,有CSA,有HCA,有Muon,有FP4……唯独没有Engram。Engram在今年1月由DeepSeek和北大联合开源,主要研究大模型的记忆与效率问题。
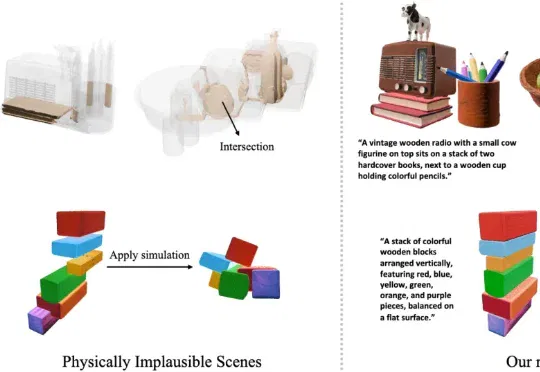
现在的 3D AIGC 已经可以很快生成场景,但离真正落地还有一段距离。很多场景看起来还行,一进物理模拟就会暴露问题,比如物体悬空、互相穿插,甚至还没碰就散。这些问题让它们很难直接用于游戏、XR 或机器人等实际场景。
据The Verge等多家外媒报道,今天凌晨,埃隆·马斯克(Elon Musk)与OpenAI CEO萨姆·奥尔特曼(Sam Altman)的世纪庭审在加州奥克兰联邦法院进入开庭陈词阶段。当天,马斯克身穿黑色西装、系黑色领带,出现在联邦法院。马斯克方、OpenAI方与微软方依次发表开庭陈词,随后马斯克作为本案第一证人进行举证。
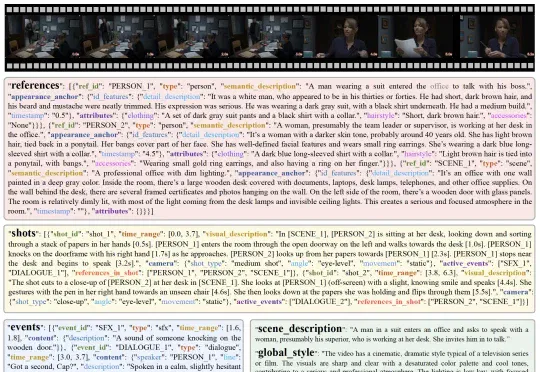
腾讯混元团队提出了 Multi-Stream Scene Script(MTSS),一种全新的视频描述范式 —— 将传统的 "一段话描述整个视频" 升级为 "多流结构化剧本",通过 Stream Factorization 和 Relational Grounding 两大核心原则,让视频描述既忠实又可扩展,在视频理解和生成任务中均取得显著提升。