Mac用户可以在oMLX中使用TurboQuant了,搭配Gemma-4-31B,谷歌全家桶实测很能打!(在新窗口打开)
对本地部署玩家,尤其是Mac用户来说,长上下文推理最大的痛点往往不是“模型不够聪明”,而是稍微多用点上下文,统一内存就被撑爆了”,这一点在最近的Gemma-4 31B的部署中尤为明显,在同等上下文的情况,显存占用比Qwen3.5-27B高约一倍不止,直接劝退了不少人。但好消息是,谷歌近期提出的TurboQuant KV缓存量化算法,正是为了解决这个痛点而生。
共 607 篇
对本地部署玩家,尤其是Mac用户来说,长上下文推理最大的痛点往往不是“模型不够聪明”,而是稍微多用点上下文,统一内存就被撑爆了”,这一点在最近的Gemma-4 31B的部署中尤为明显,在同等上下文的情况,显存占用比Qwen3.5-27B高约一倍不止,直接劝退了不少人。但好消息是,谷歌近期提出的TurboQuant KV缓存量化算法,正是为了解决这个痛点而生。
谷歌Deep Think横扫亚欧多语种竞赛,AI科研工具的语言壁垒正在被拆掉,数学与科学发现进入AI驱动新时代。
Gemma4 31B的发布,在开源模型社区引发了巨大的关注。面对这款由谷歌DeepMind于2026年4月2日 推出的重磅模型,很多技术团队和本地部署玩家都在问同一个问题:Gemma4的出现,到底是在开辟一条新的本地部署路线,还是只是给高端玩家多了一个可选项?我们到底需不需要把现有的Qwen3.5 27B工作流整体迁移过去?
刚刚,Anthropic年收入首超OpenAI!同时就在今天,一份与谷歌、博通最新合作,将在2027年上线3.5 GW全新TPU集群。这批史诗级的算力,预计从2027年开始陆续上线。
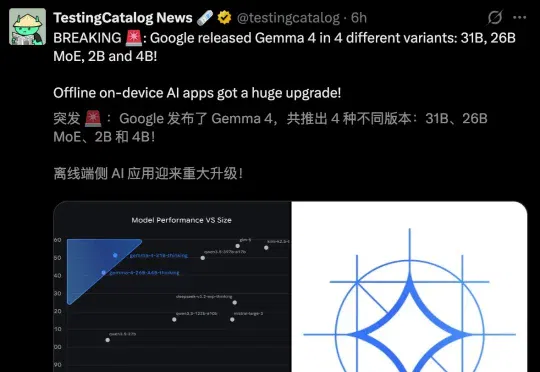
谷歌深夜掏家底!Gemma 4全系开源,仅用31B越级斩杀20倍体量巨头。数学能力暴涨68%,硬生生把前代打成计量单位,开源界迎来终极大洗牌!
刚刚,谷歌正式发布 Gemma 4,称“这是其迄今为止最智能的开放模型系列”。该系列面向复杂推理与智能体工作流设计,采用商业许可的 Apache 2.0 许可证开源。Gemma 4 提供四种规格:Effective 2B(E2B)、Effective 4B(E4B)、26B 混合专家模型(MoE)和 31B 稠密模型(Dense)。
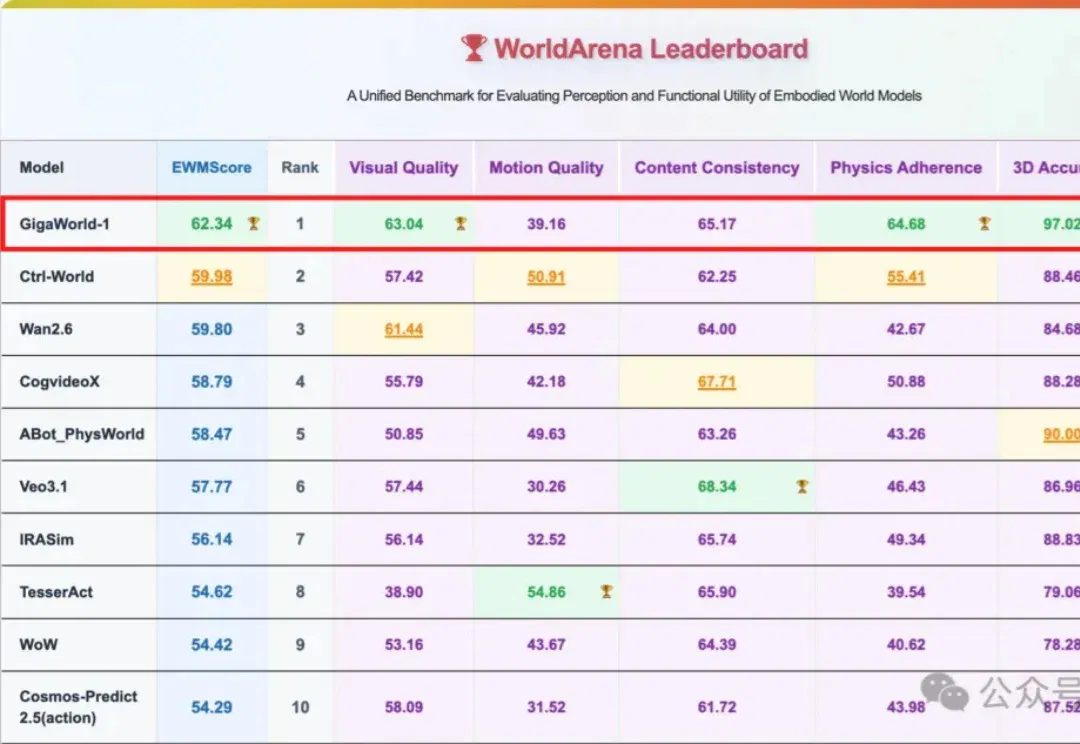
还得是咱国产世界模型牛! 极佳视界最新力作GigaWorld-1,直接击穿谷歌英伟达,WorldArena登顶全球第一。 而且还是唯一一个综合得分突破60分大关的具身世界模型。 什么概念呢?就以三大核心维度为例,几乎是断层式领先: Physics Adherence(物理遵循):相比第二名提升了整整16%。3D Accuracy(3D准确度):近乎逼近满分。Visual Quality(视觉质量):同样遥遥领先。 也就是说,GigaWorld-1是真正的全能型具身世界模型,不仅视觉真实,而且几何精准、物理准确。 这意味着,极佳视界这家由清华系领衔,汇聚了阿里、百度、地平线等一众顶尖大厂核心骨干
昨日凌晨,谷歌正式推出其最高质量的音频和语音模型——实时语音模型Gemini 3.1 Flash Live,并在Gemini App、Search Live以及Google AI Studio中同步开放,其中后者以预览版本向开发者提供。
谷歌一篇论文,直接让存储巨头们「集体失眠」,一夜市值蒸发几百亿!最新博客官宣TurboQuant算法,直接将缓存压到3-bit,内存占用只有1/6。
谷歌DeepMind刚刚为Gemini API放了一个大招:内置工具和自定义函数终于可以在同一次调用里混着用了。再加上跨工具的「上下文环流」和Google Maps原生接入,Agent开发的编排噩梦正在终结。