周畅离职消息有分歧,报道梳理字节 Seed 多模态路线变化(在新窗口打开)
报道援引不同信源对周畅是否离开 Seed 给出不同说法,并讨论视觉理解并入大语言模型、视觉生成独立研发的组织与技术取舍。相关人事与创业消息仍待公开确认。
共 438 篇
报道援引不同信源对周畅是否离开 Seed 给出不同说法,并讨论视觉理解并入大语言模型、视觉生成独立研发的组织与技术取舍。相关人事与创业消息仍待公开确认。
LongCat-2.5 总参数量1.6万亿、每token激活约480亿,结合离散视觉token与长程智能体训练。团队报告多项基准和国产加速器训练优化;原作者体验也指出3D细节和PPT排版不足。不同基准有领先与落后,不能概括为全面超过海外模型。
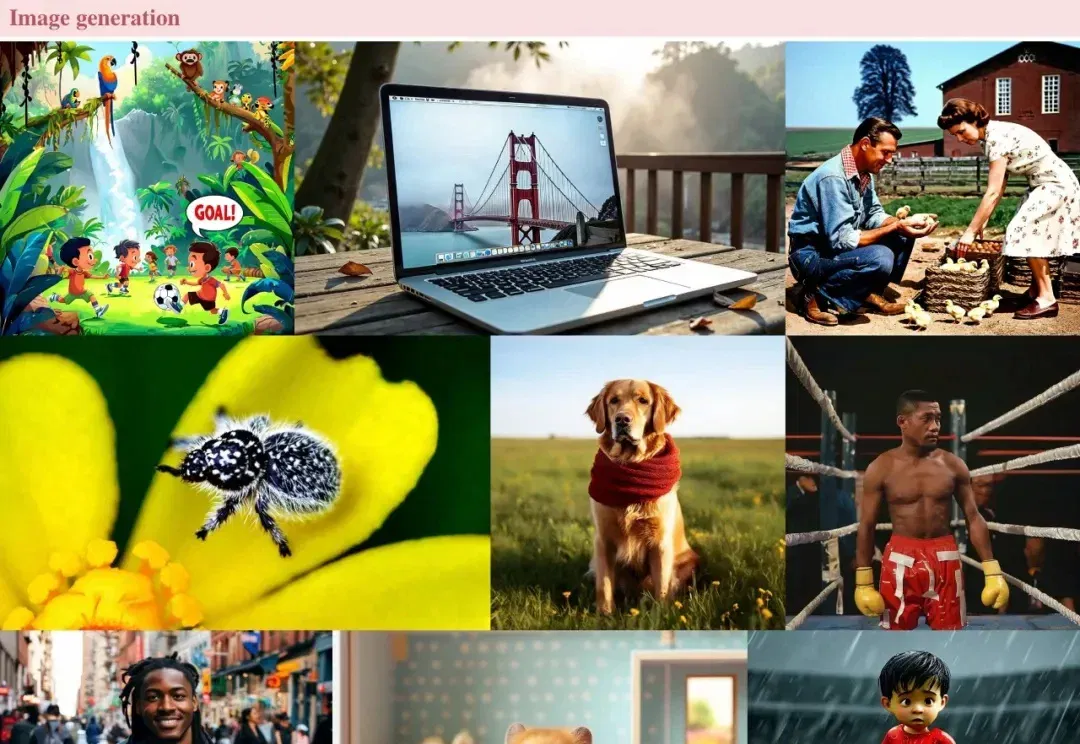
英伟达与滑铁卢大学提出 PixelUMM,以线性投影将图像块和视频时空块接入多模态主干,统一理解与生成而不使用 ViT、VAE。论文比较 patch 大小、输出头和训练规模等设计,报告了与基线相当的综合表现,也指出像素网格伪影等局限。
Z Finance 报道,字节 Seed 技术负责人周畅已离职,正围绕 Physical AI 创业并获得美元基金支持,融资金额、投资方与产品路线尚未披露。文章回顾其多模态、世界模型与机器人研发经历,也提到此前曾有接近字节人士否认离职消息。
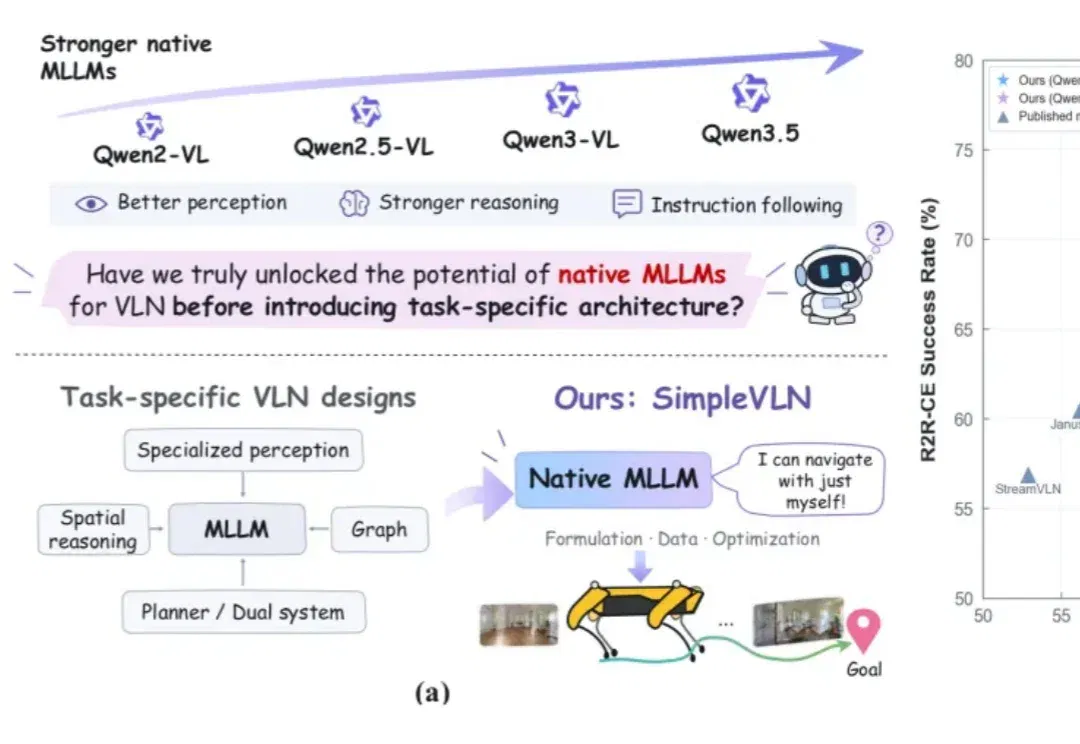
SimpleVLN 通过历史画面筛选、动作块输出,以及专家示范、DAgger 和强化学习组成的训练流程,挖掘原生多模态模型的导航能力。团队在连续导航基准上报告提升,并展示四足机器人演示;仿真成功率与真实环境的稳定泛化仍应分别验证。
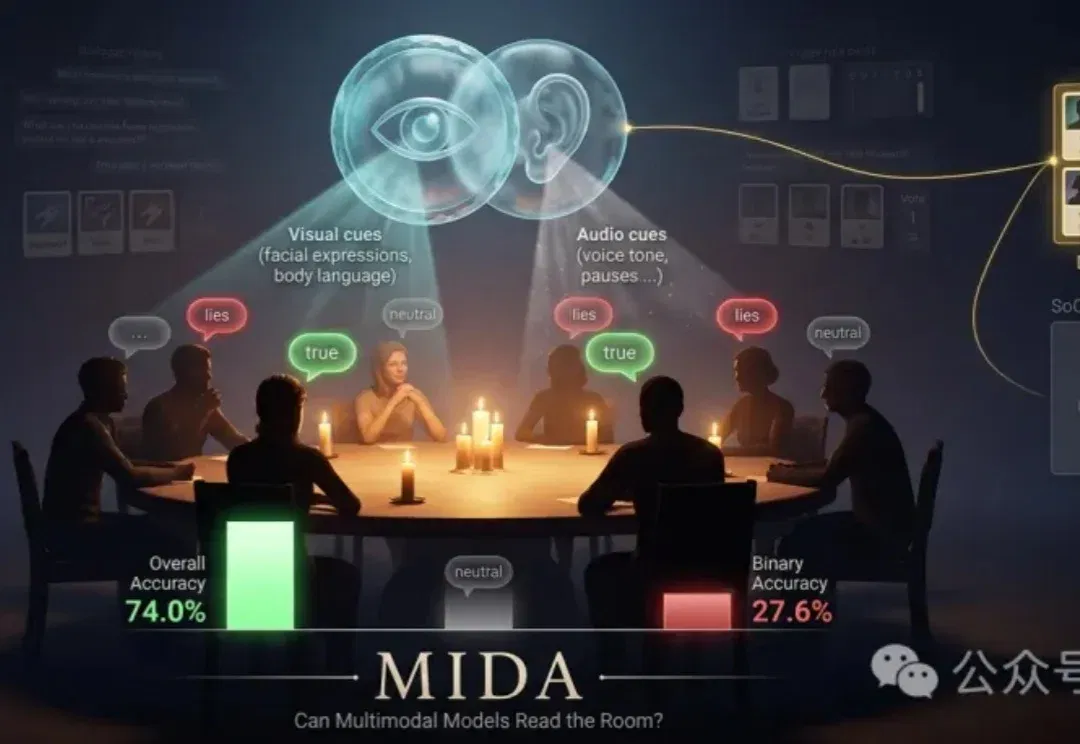
MIDA 以狼人杀对话测试模型能否结合玩家掌握的信息,区分真话、假话与无法判断的发言。研究发现,总体准确率可能掩盖大量“中立”预测;持续跟踪对话历史和角色信念,比简单增加视频帧更关键。这类受控游戏测试仍不能等同于现实测谎。
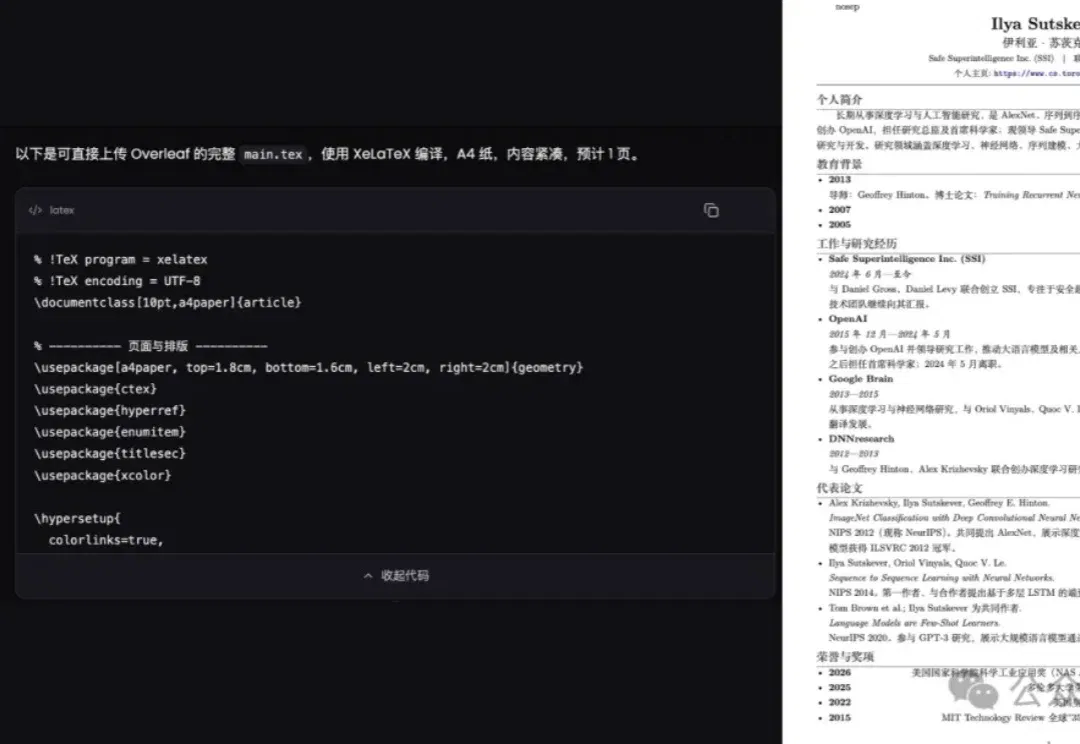
量子位结合交互网页、代码生成和工具调用的上手记录,解释 Clover 的块扩散、历史记忆与连续任务执行方式。文章区分作者体验、团队评测和后续多模态及端侧计划,不将特定任务耗时推广为普遍速度。
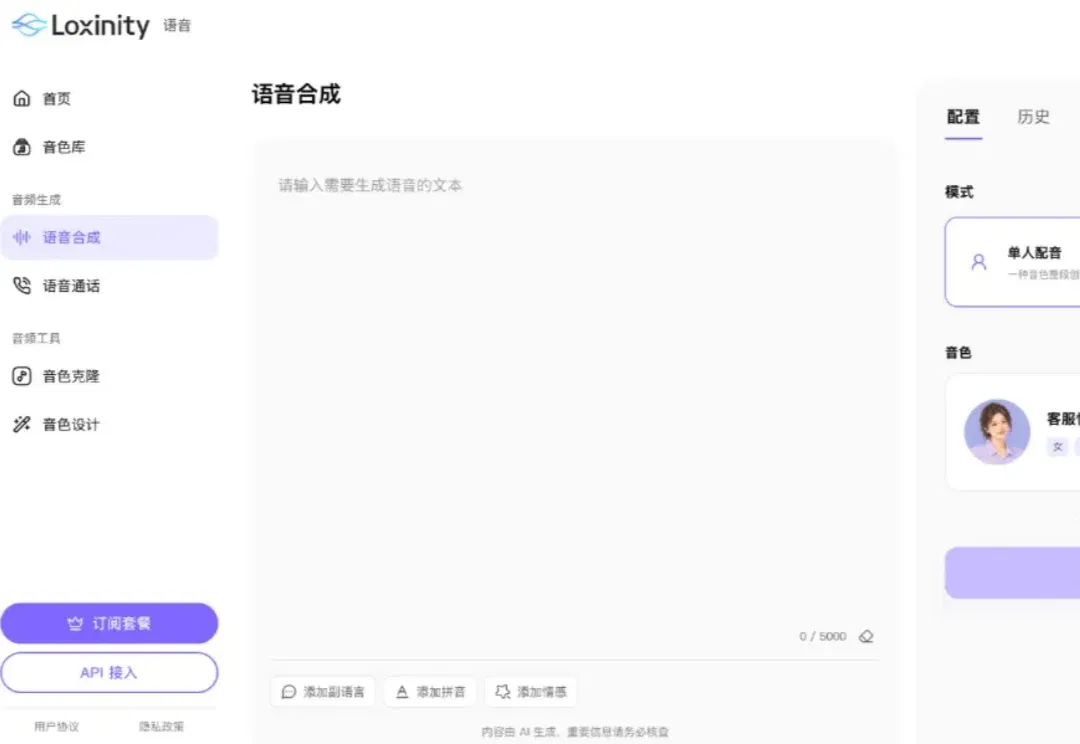
《读佳》独家获知,Soul将推出专为交互场景打造、超具活人感的语音合成产品“Loxinity(洛希无限)”,和市面上面向配音、短视频的TTS不同,这套模型从底层瞄准实时交互场景,主打强活人感。它支持单人配音、多人对话两种模式,配套音色克隆、音色设计等工具,还开放API接入。Loxinity下辖语音合成模型Loxi Speech和视频生成模型Loxi Avatar。
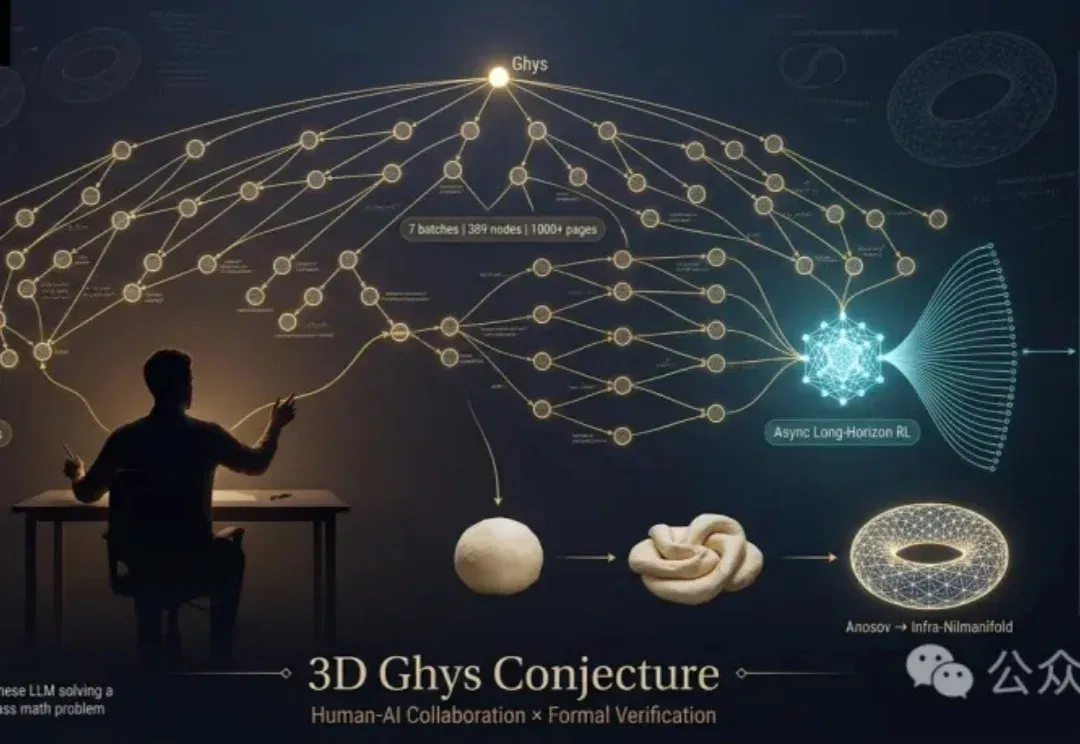
困扰数学界30余年的世界级难题——三维Ghys猜想迎来了破解!
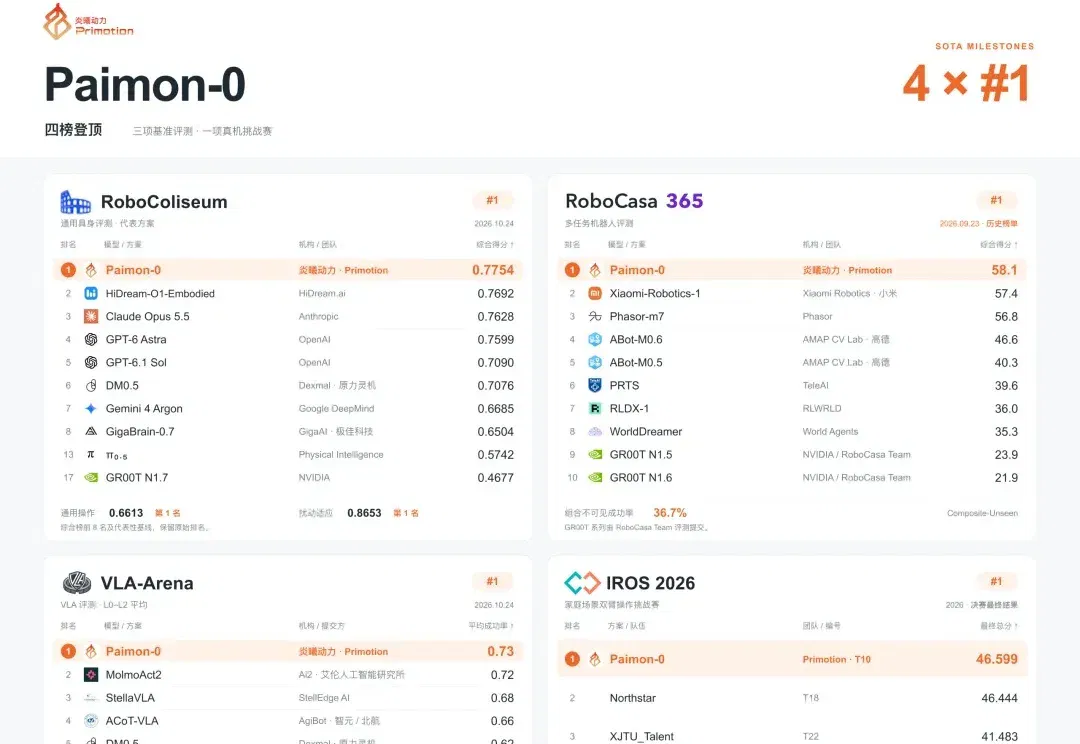
太反差了。 一家在深圳成立刚满三个月的公司,明明给自己的定位是做具身芯片,可它对外拿出的第一份成果,却是一个名叫Paimon的具身基座模型(系列)。 然后这个系列里的首款模型Paimon-0初次亮相,就直接拿下了四项第一: 先看含金量最高的RoboColiseum,这个由 Hugging Face、NVIDIA、清华大学等全球近 20 家高校、企业、科研机构共建的榜单,最近在具身圈热度居高不下;Paimon-0 以 0.7754 分排在第一。 要知道,这个榜最近可是刚把GPT-6 Astra、Claude Opus 5.5、Gemini 4 Argon这些通用多模态大模型请进场同台比试的: 虽