2025 智能体元年,Agent 开发平台深度评测报告解读(在新窗口打开)
AI 产业的两大核心趋势正并行发展:基础大模型的能力持续突破,而 AI Agent 的产业化落地也在全面提速。Capgemini 于 2025 年 4 月发布的一项覆盖 14 国 1500 名企业高管的调研显示[1],已有 37% 的受访组织启动或实施 AI Agent 项目,另有高达 61 %的组织将在一年内跟进部署或进行探索,印证了该趋势的全球共识。
共 1876 篇
AI 产业的两大核心趋势正并行发展:基础大模型的能力持续突破,而 AI Agent 的产业化落地也在全面提速。Capgemini 于 2025 年 4 月发布的一项覆盖 14 国 1500 名企业高管的调研显示[1],已有 37% 的受访组织启动或实施 AI Agent 项目,另有高达 61 %的组织将在一年内跟进部署或进行探索,印证了该趋势的全球共识。
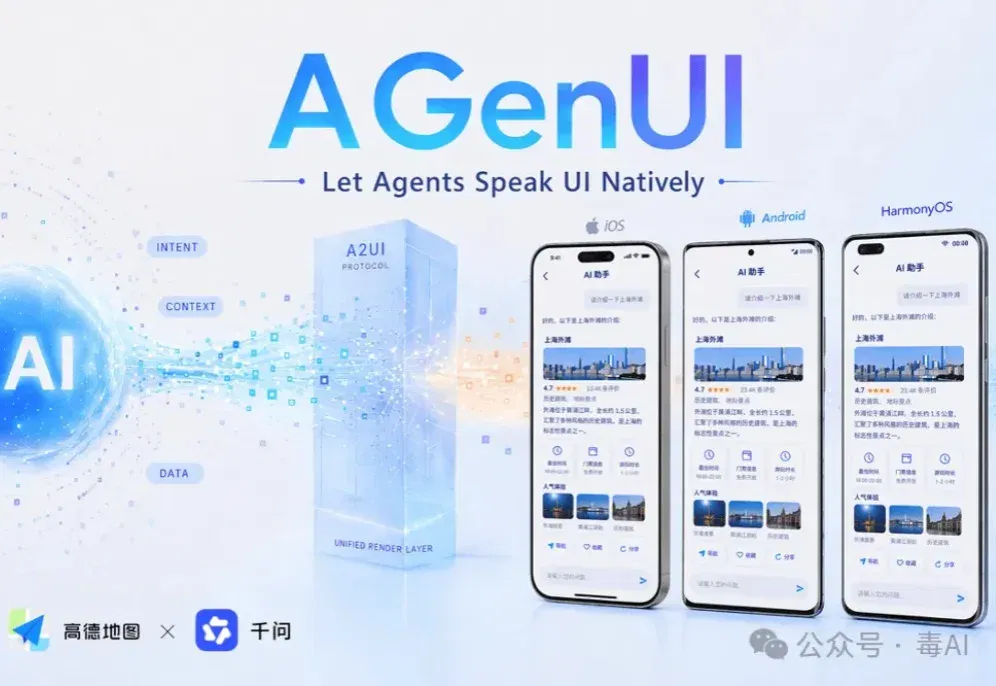
一篇让你看懂的AGenUI开源解读 很多人对AI Agent的想象还停留在“聊天”上。你丢一个问题过去,它回你一段文字,顶多加一张图。 但真正用过这类产品的朋友应该都懂——纯文本的交互天花板太低了。你想订个酒店,它给你敲了一长串候选清单,你还要手动复制店名跳到另一个App去搜。 这不叫智能,这叫换了个地方查资料。 但有没有一种可能:AI直接“画”出一个带按钮、带列表、带地图的界面,让你直接在对话里完成所有操作? 高德和阿里千问C端应用团队刚刚开源的 AGenUI,就是在回答这个问题。 一次“跨界联名”,捅破了一层窗户纸 上周,AI圈被一个名字刷了屏——AGenUI。简单说,它是业内首个同时覆盖
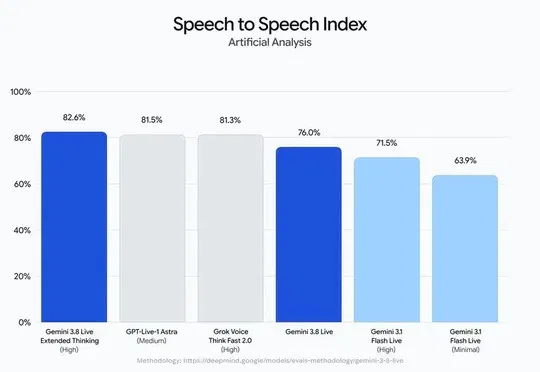
谷歌发布 Gemini 3.8 Live 与 Gemini 3.8 Live Extended Thinking 两款实时语音模型,后者支持后台异步推理与工具调用以解决语音 Agent 在任务执行中的沉默问题,两款模型已在 Gemini API 和 Google AI Studio 向开发者开放。
43页财报一句话变带图表网页。 一款模型“好不好”,究竟该如何定义? 显然,Agent正在改变人们评价大模型的方式。过去,判断模型强不强,往往看参数规模、Benchmark成绩和上下文长度。 而在Agent时代,一款能够又快又好地解决问题、完成任务,且token花得起的模型,才是很多用户眼中的好模型。 顶级模型固然能力更强,但往往思考和执行时间长、成本高昂,而快速模型生成token很快,却容易走错路、反复尝试,甚至需要人工接手,任务完成速度根本没快多少。 用更少的计算和无效尝试,更快更好地完成任务,是如今用户对Flash级别模型的期待,也让Flash级别模型逐渐从旗舰模型的轻量版本,走向一条独
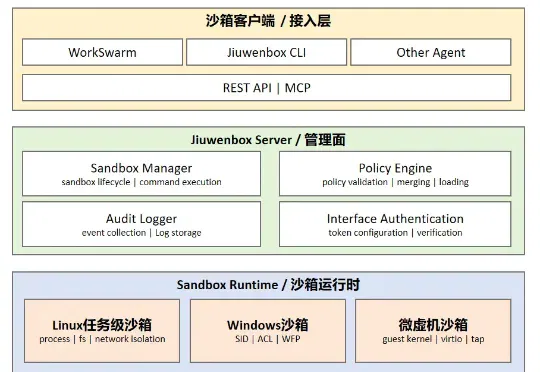
JiuwenBox 的定位,可以用一个比喻说清:给 AI 干活的临时房间。它和 WorkSwarm 是这么配合的:用户在 WorkSwarm 里发一个任务,Agent 负责把任务想清楚、拆成几步;每一步要跑的命令、要运行的代码、要碰的文件,统统送进 JiuwenBox 的沙箱去执行。Agent 负责 "出主意",沙箱负责 "安全地动手"。
由前 Manus 成员 Cecilia 与 Tianyi 创立的 Persom 推出本地优先的 Personal Agent,在用户授权下将电脑中的工作与生活上下文沉淀为可由其他 Agent 调用的 Personal Database,并持续沉淀工作流与个人判断。
过去一段时间,TiDB 团队启动了一项面向 Agent 的基础设施尝试——TiDB Cloud Filesystem。它把 Workspace 从 Session 和 Sandbox 的生命周期中独立出来:Agent 仍然通过熟悉的文件系统接口工作,背后则提供数据库级的持久化、版本、分支、回滚和权限控制。
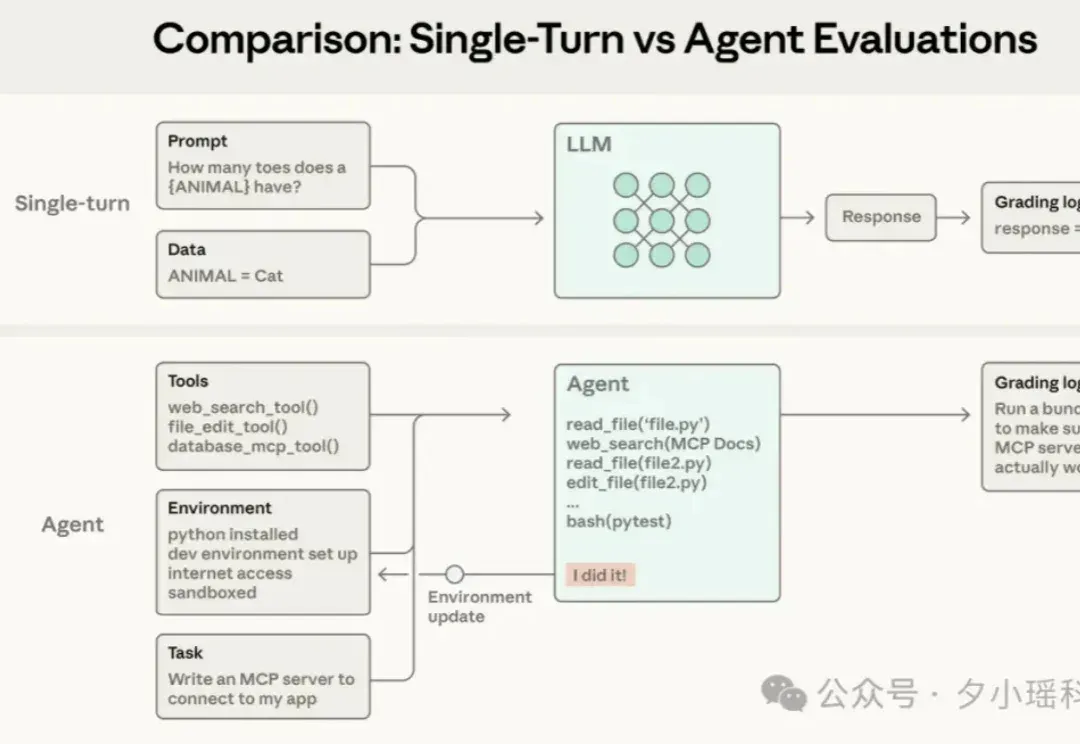
如果你在做 AI Agent 开发,大概率已经发现一件事: Agent 几乎是传统软件测试方法的反例。
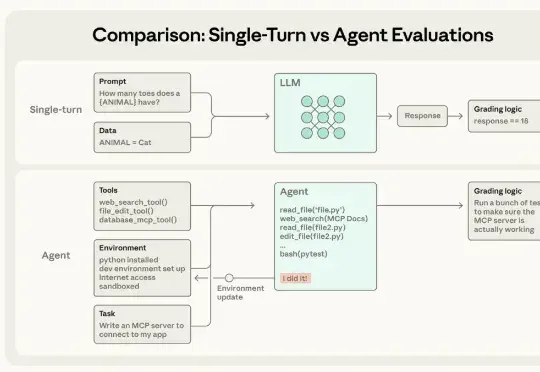
Agent 并不是一次性输出的系统。它们运行在多轮交互之中:调用工具、修改内部状态、根据中间结果不断调整策略。也正是这些让 Agent 变得有用的能力 ——自主性、智能性与灵活性 —— 同时也让它们变得更难以评估。
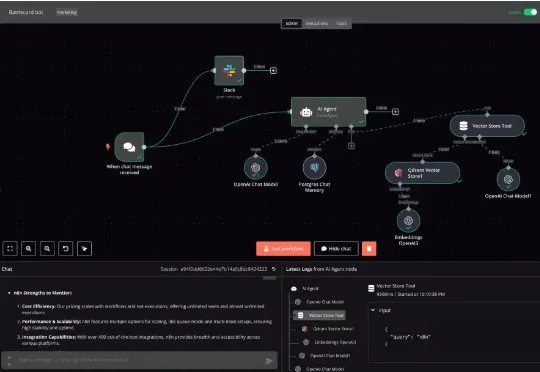
随着垂直领域 agent 的兴起,市面上的应用越来越多,用户不可避免地需要一个编排工具(orchestration tool)来将这些分散的应用串联起来,或者需要某种横向工具(horizontal tool)来统一构建 agent。而 n8n 正是这一生态位中的佼佼者,它正从一个工作流自动化工具,升级为 AI 应用的编排层。