腾讯掀桌!0.4G翻译模型,手机断网都能跑,比谷歌翻译得好(在新窗口打开)
今日,腾讯混元开源翻译模型Hy-MT1.5-1.8B-1.25bit。该模型仅0.4G,就实现了33种语言高质量互译,且下载后可直接在手机本地离线运行,翻译表现优于谷歌翻译。这一原始模型的参数规模为1.8B,为降低用户手机内存压力,腾讯混元团队通过量化压缩推出了适配中高性能手机的2-bit、适配全系列手机的1.25-bit两种方案,模型体积分别被压缩至574MB、440MB。
共 607 篇
今日,腾讯混元开源翻译模型Hy-MT1.5-1.8B-1.25bit。该模型仅0.4G,就实现了33种语言高质量互译,且下载后可直接在手机本地离线运行,翻译表现优于谷歌翻译。这一原始模型的参数规模为1.8B,为降低用户手机内存压力,腾讯混元团队通过量化压缩推出了适配中高性能手机的2-bit、适配全系列手机的1.25-bit两种方案,模型体积分别被压缩至574MB、440MB。
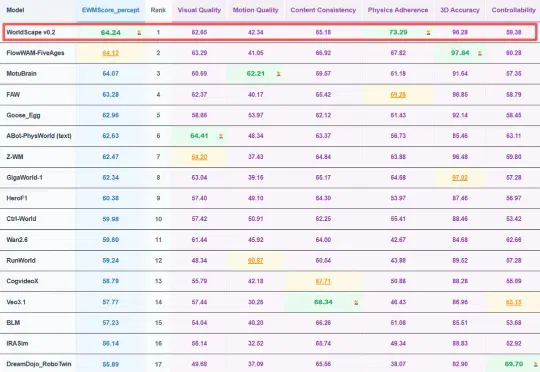
近日,全球具身世界模型权威基准评测 WorldArena 正式更新最新榜单。Manifold AI 流形空间研发的世界模型 WorldScape 0.2,凭借其在物理规律遵循与多源交互理解上的突破取得 WorldArena 榜单全球第一,充分展现了国产世界模型在复杂动态场景生成与具身控制中的高精度、强泛化与物理可信度。与其同场竞技的包括英伟达、谷歌等国外巨头和星动纪元、极佳视界等国内具身智能公司。
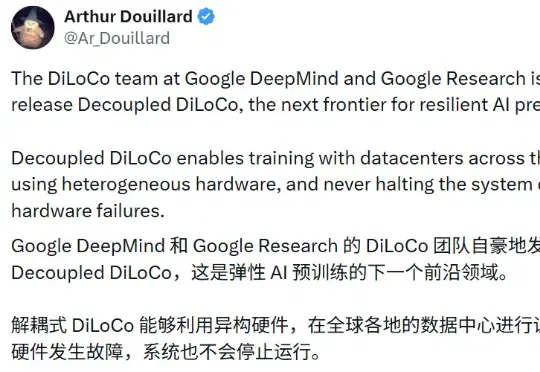
弹性 AI 预训练已经推进到了下一个前沿!没有意外:来自谷歌。据介绍,他们提出的 Decoupled DiLoCo 是一种革命性的分布式训练技术,能够利用全球各地的异构硬件进行训练,并且即使当硬件发生故障时,系统也不会停止运行!
谷歌豪掷400亿美元加注Anthropic,自家Gemini正面对垒的「敌人」。当Claude年化收入一年暴涨30倍冲到300亿,当算力成为AI下半场唯一硬通货,与其用Gemini硬刚,不如把对手变成TPU最大买家。
最近,谷歌联合ResNet作者何恺明、谢赛宁、NeRF先驱Jonathan T. Barron、 3D图形学名家Thomas Funkhouser,正式发布了Vision Banana。它向世界宣告:视觉AI终于不再需要那些臃肿的任务头了,理解,本质上只是生成过程中的一次「对齐」。
AI第一次从包工头,变成了建筑设计师。 以前我们混互联网论坛时,常说「无图无真相」,意思是你说的话我不信,有本事就把图或照片发上来。 之所以会这样,原因很简单,当时Photoshop门槛很高,会P图的人在论坛上凤毛麟角,大家默认图片的真实性远高于文字。 但过去这半年,AI生图领域的竞争异常激烈,很多人可能只是耳闻,却不清楚具体激烈程度。我来和你盘点一下。 首先是2025年8月,谷歌发布图像模型Nano Banana,一下子把AI生图的天花板抬高了一大截。 而在年底,面对谷歌Gemini 3+Nano Banana的全面攻势,山姆·奥特曼在公司内部拉响「红色警报」(Code Red),要求全员集
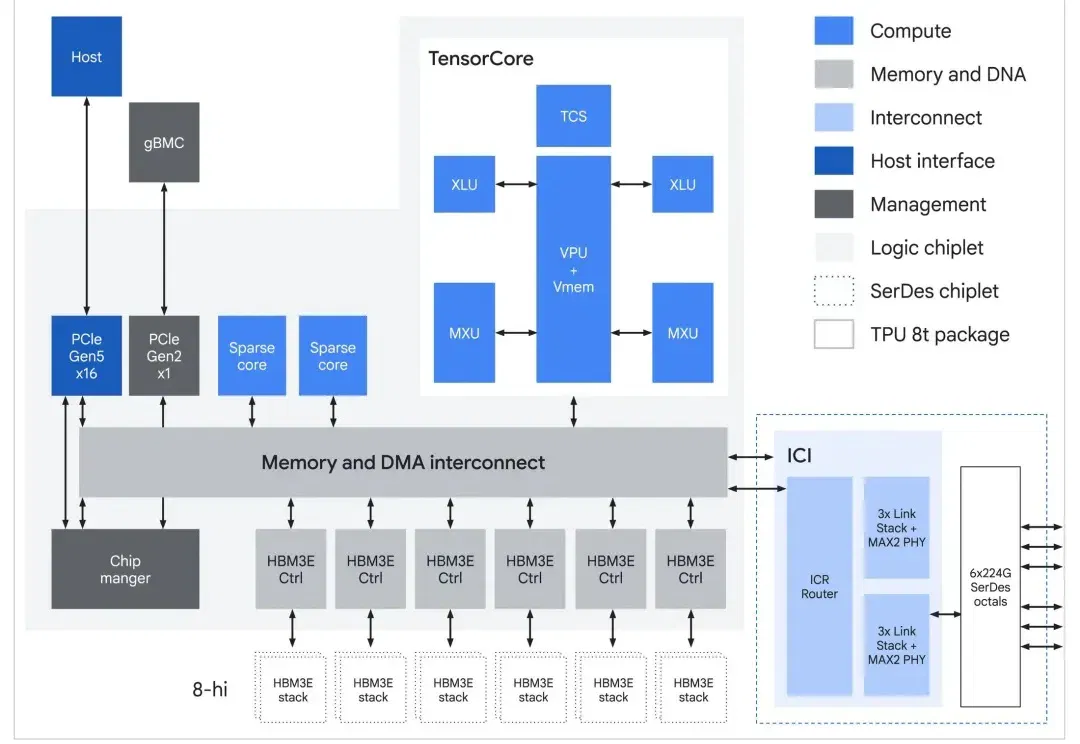
今天,谷歌在 Cloud Next '26 峰会上发布了其第八代 TPU 架构(TPU 8t 与 TPU 8i),TPU 8t 主攻训练,TPU 8i 主攻推理,将在 2026 年晚些时候上市。第八代 TPU 采用申请制,Google Cloud 用户如需使用,需要在官网提交登记需求。
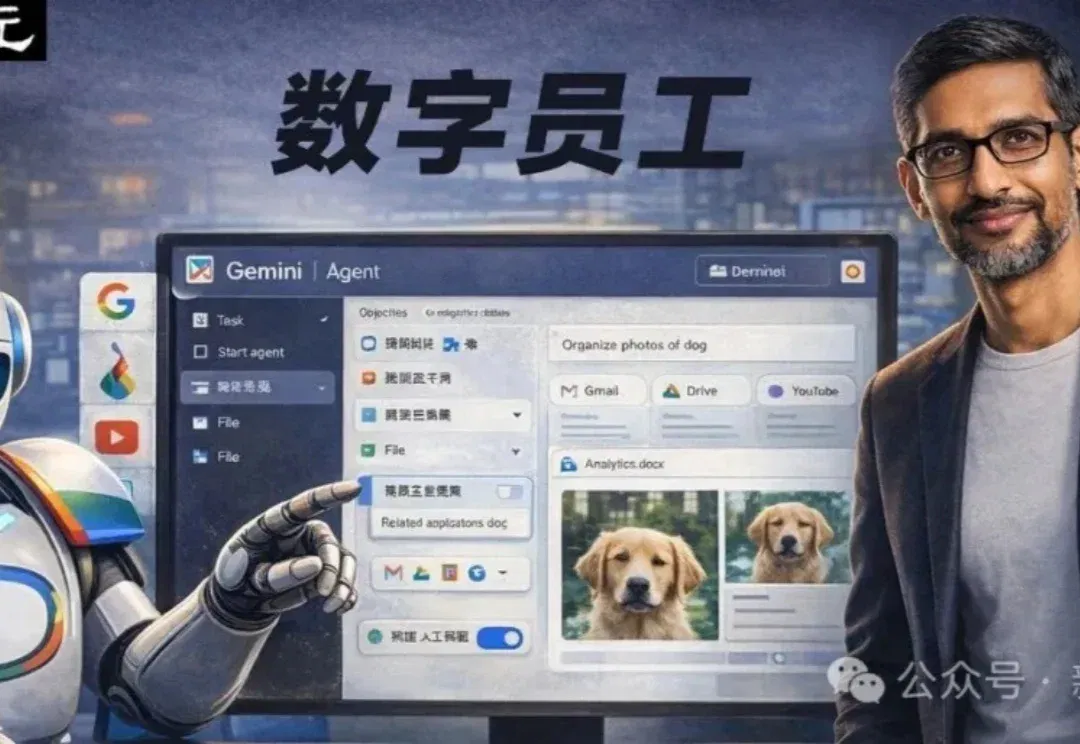
谷歌悄悄加了一个Agent新入口:Gemini开始长出「手脚」,不再只负责回答问题,还准备下场替你干活了。
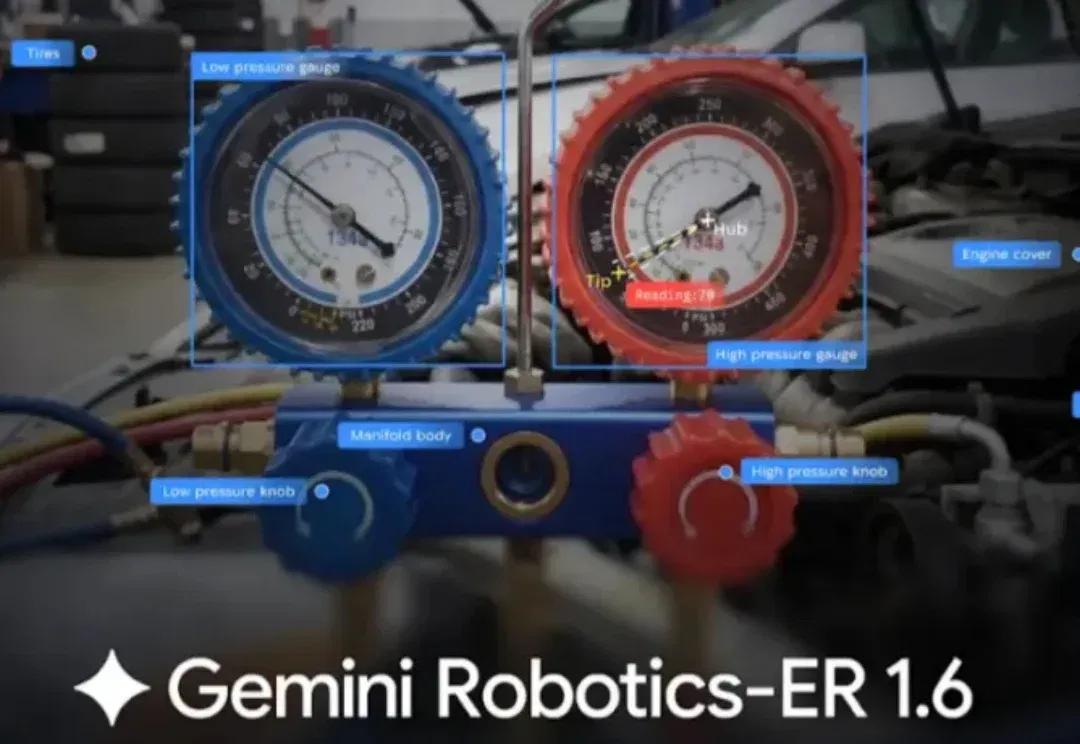
联手波士顿动力,谷歌给机器人装上会读表的脑子。
当奥特曼两次遇袭后,谷歌 DeepMind 悄悄做了一个反常规的决定:招一位哲学家。这是头部 AI 实验室第一次变相承认,AGI 已经不再只是工程问题。