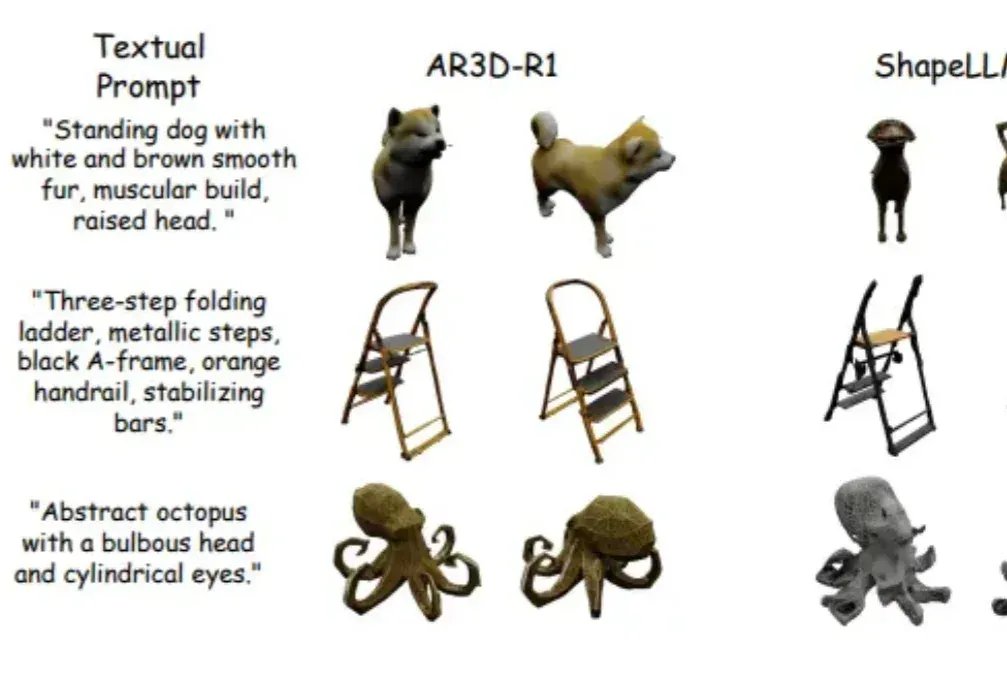
RL加持的3D生成时代来了!首个「R1 式」文本到3D推理大模型AR3D-R1登场(在新窗口打开)
强化学习(RL)在大语言模型和 2D 图像生成中大获成功后,首次被系统性拓展到文本到 3D 生成领域!面对 3D 物体更高的空间复杂性、全局几何一致性和局部纹理精细化的双重挑战,研究者们首次系统研究了 RL 在 3D 自回归生成中的应用!
共 198 篇
强化学习(RL)在大语言模型和 2D 图像生成中大获成功后,首次被系统性拓展到文本到 3D 生成领域!面对 3D 物体更高的空间复杂性、全局几何一致性和局部纹理精细化的双重挑战,研究者们首次系统研究了 RL 在 3D 自回归生成中的应用!
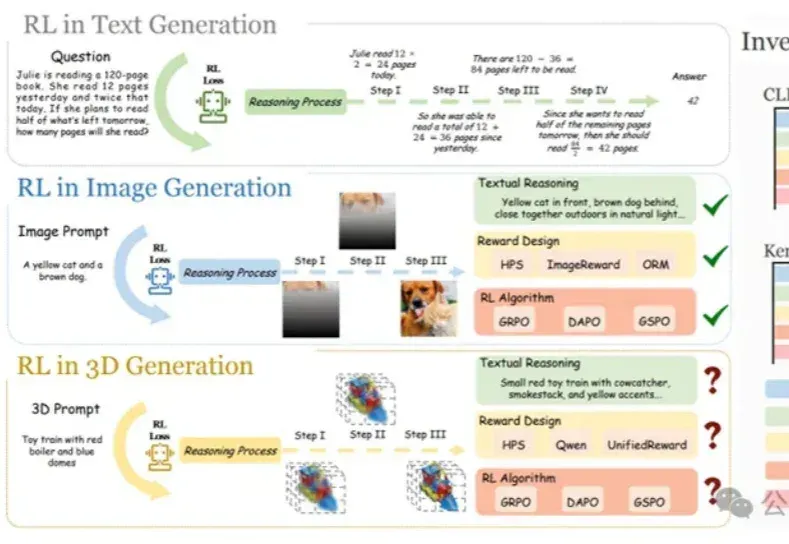
在大语言模型和文生图领域,强化学习(RL)已成为提升模型思维链与生成质量的关键方法。
本周四消息,于两年前创立亚马逊 AGI 团队的高级副总裁兼首席科学家 Rohit Prasad 已官宣离职。
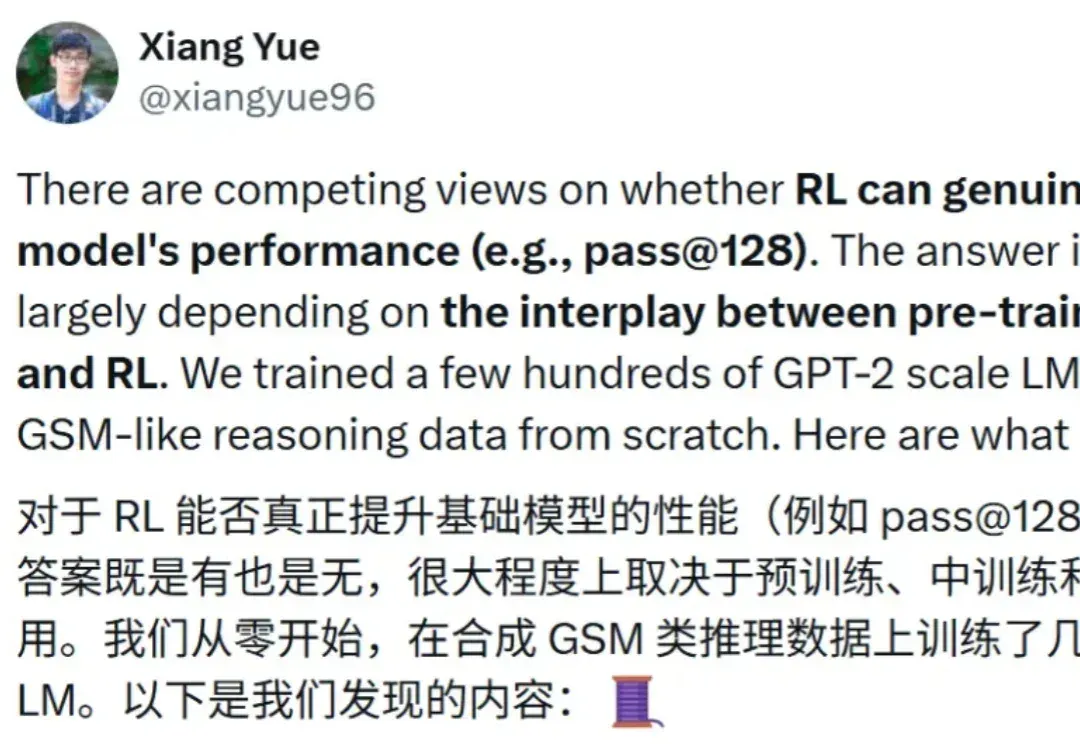
近期,强化学习(RL)技术在提升语言模型的推理能力方面取得了显著成效。
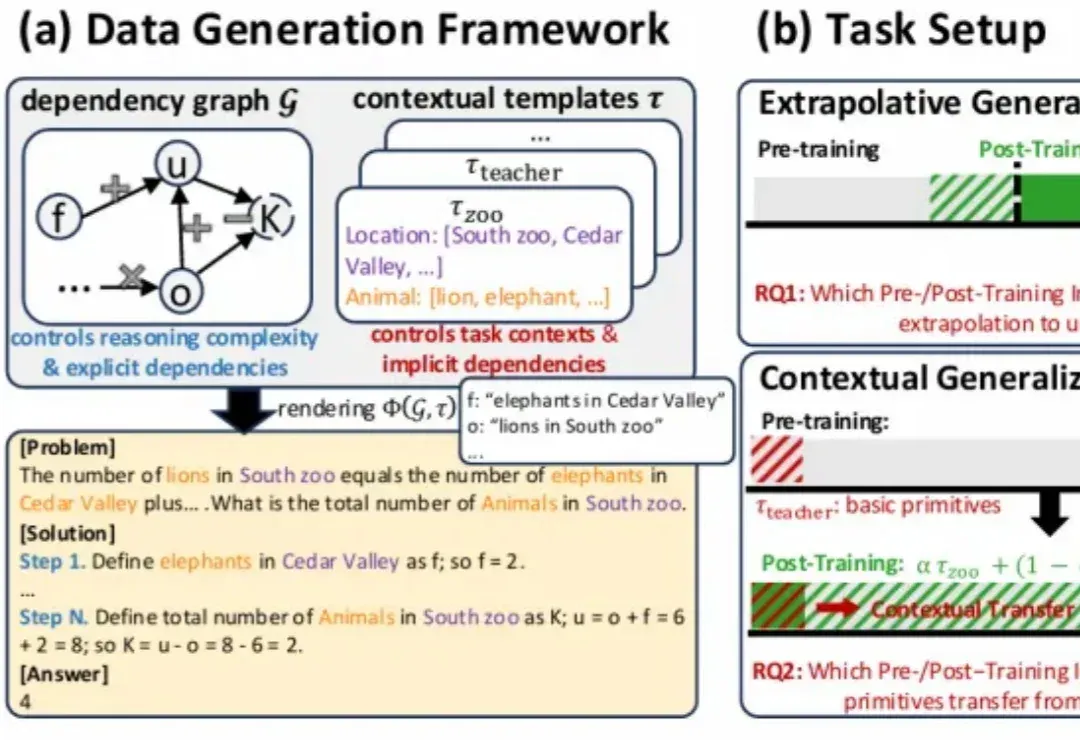
近期,强化学习(RL)技术在提升语言模型的推理能力方面取得了显著成效。
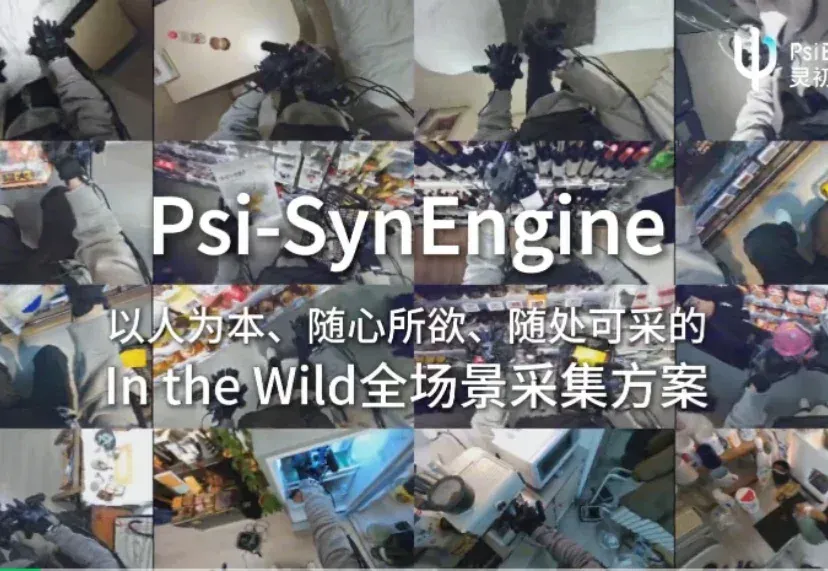
灵初智能发布全球首个具身原生人类数据采集方案 Psi-SynEngine。该方案由灵初智能全栈自研,包含便携式外骨骼触觉手套数采套装、大规模 in the wild 数采数据管线、基于世界模型和强化学习的跨本体数据迁移模型,并已率先将采集到的人类数据应用于物流等真实场景。
最近,Prime Intellect正式发布了INTELLECT-3。这是一款拥有106B参数的混合专家(Mixture-of-Experts)模型,基于Prime Intellect的强化学习(RL)技术栈训练。在数学、代码、科学与推理的各类基准测试上,它达成了同规模中最强的成绩,甚至超越了不少更大的前沿模型。
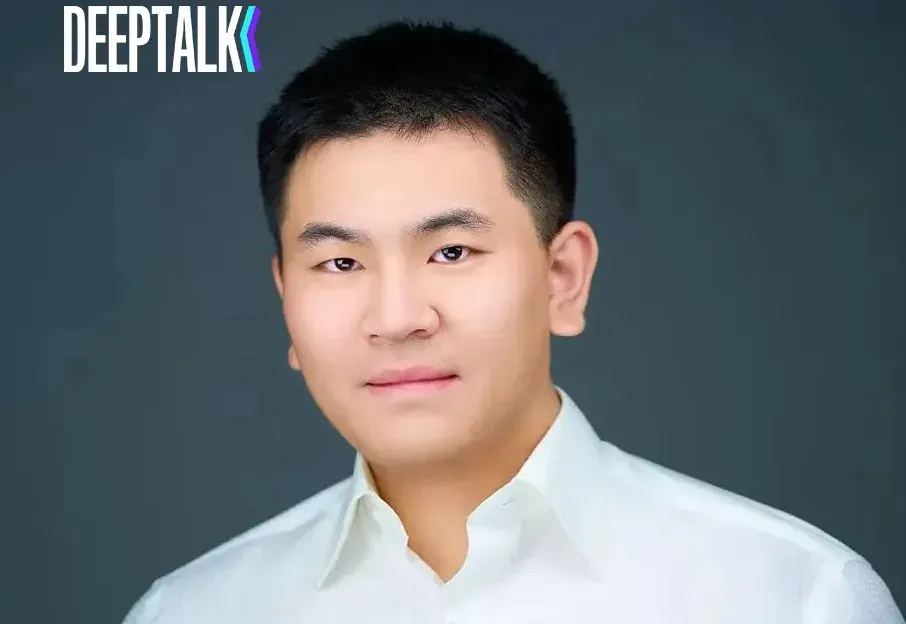
本科毕业于北大工学院,早期研究聚焦于自动驾驶;博士后期间在卡内基梅隆大学,利用强化学习解决核聚变反应堆控制问题。陈佳玉的科研生涯,始终围绕着复杂系统的智能控制展开。
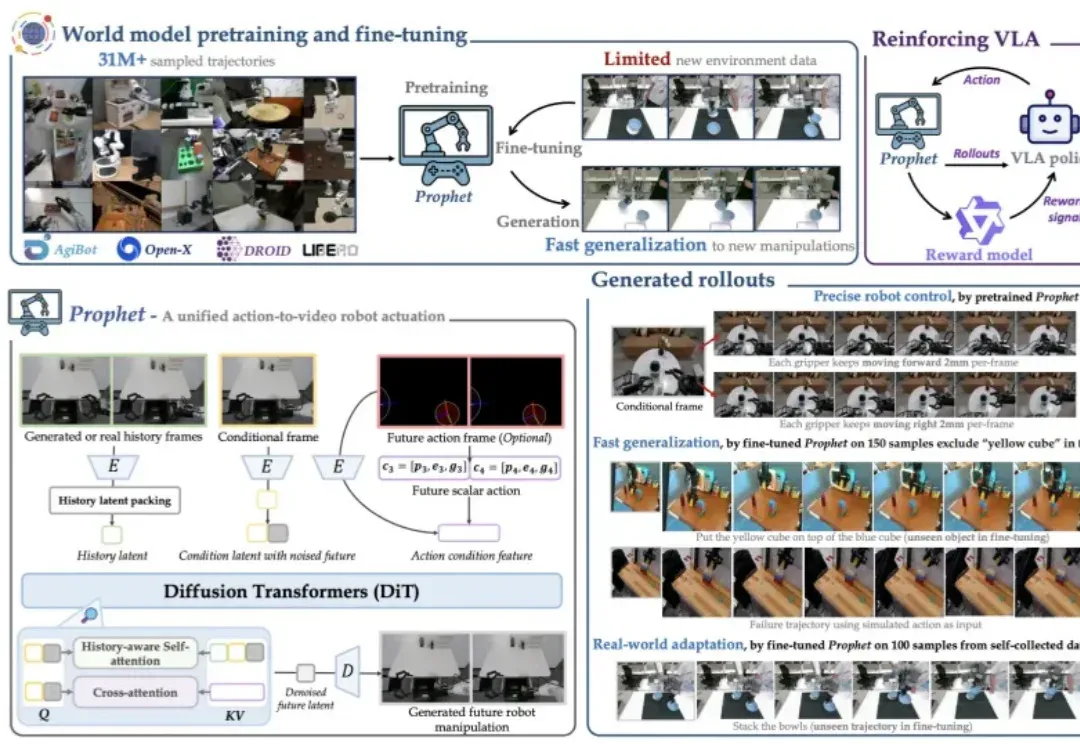
Vision–Language–Action(VLA)策略正逐渐成为机器人迈向通用操作智能的重要技术路径:这类策略能够在统一模型内同时处理视觉感知、语言指令并生成连续控制信号。
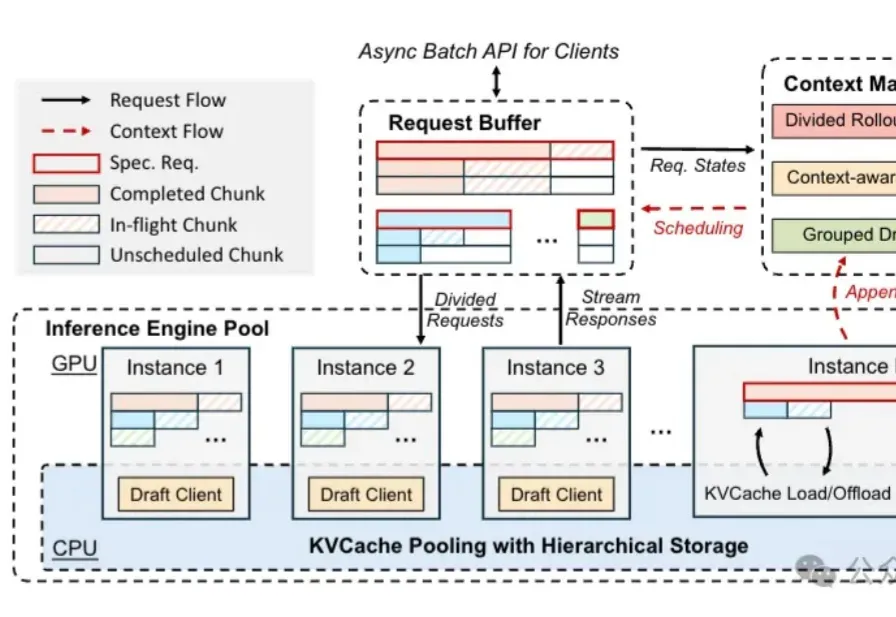
u1s1,现在模型能力是Plus了,但Rollout阶段的速度却越来越慢……