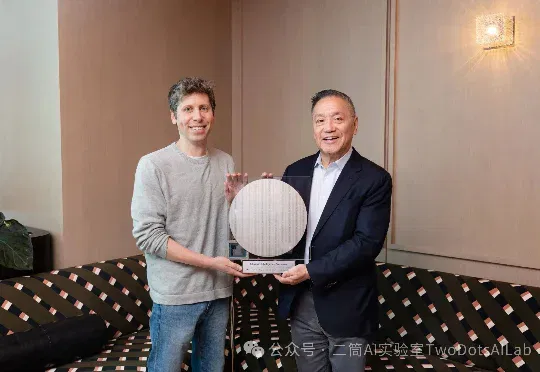
刚刚,OpenAI发布首款AI芯片,九个月完成流片(在新窗口打开)
美国当地时间6月24日,OpenAI与博通联合发布了双方合作的首款定制芯片Jalapeño。这是一款专用集成电路(ASIC),专门针对大语言模型的推理任务而设计,也标志着OpenAI正式进军AI芯片领域。
共 194 篇
美国当地时间6月24日,OpenAI与博通联合发布了双方合作的首款定制芯片Jalapeño。这是一款专用集成电路(ASIC),专门针对大语言模型的推理任务而设计,也标志着OpenAI正式进军AI芯片领域。
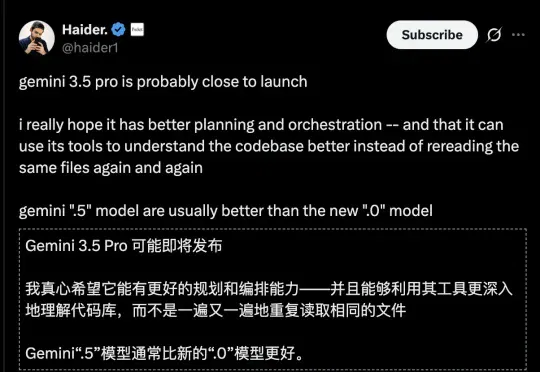
据最新独家爆料,谷歌目前正在紧锣密鼓地对即将发布的重磅大语言模型Gemini 3.5 Pro进行高强度的激进迭代,在正式揭晓之前,内部预计还会测试更多的版本。
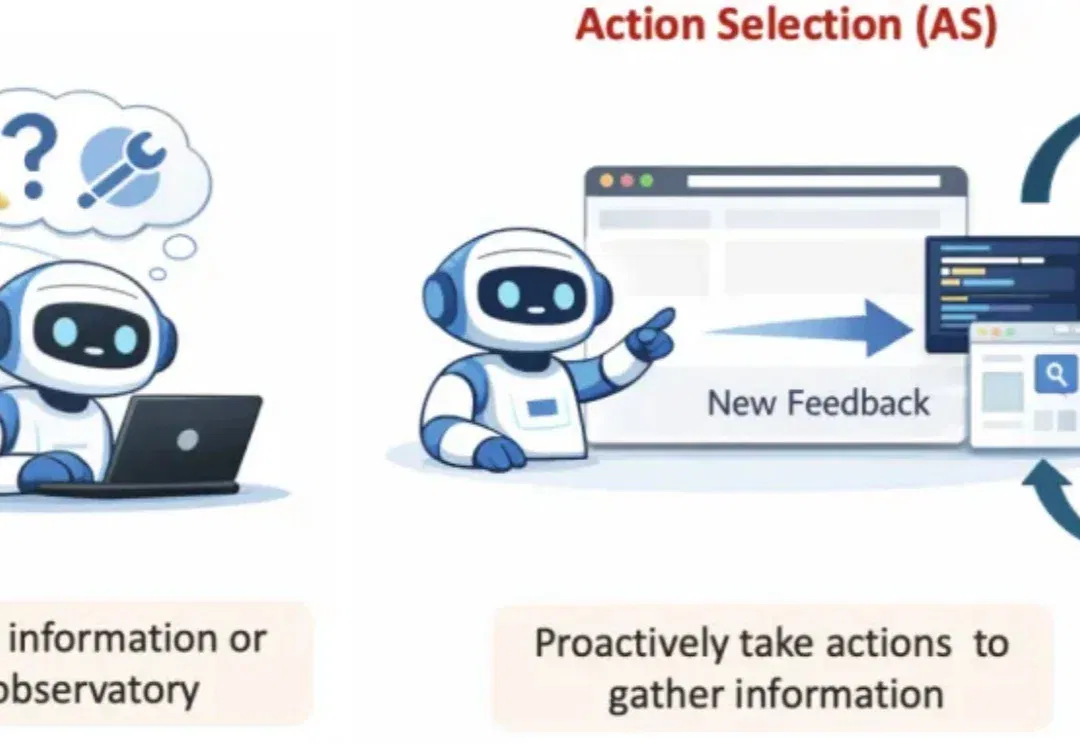
随着大语言模型逐步从「单轮问答」走向「真实环境中的持续交互」,LLM agents 正在被用于越来越复杂的 agentic applications:deep research、coding、computer use、customer service、medical inquiry、troubleshooting 等等。
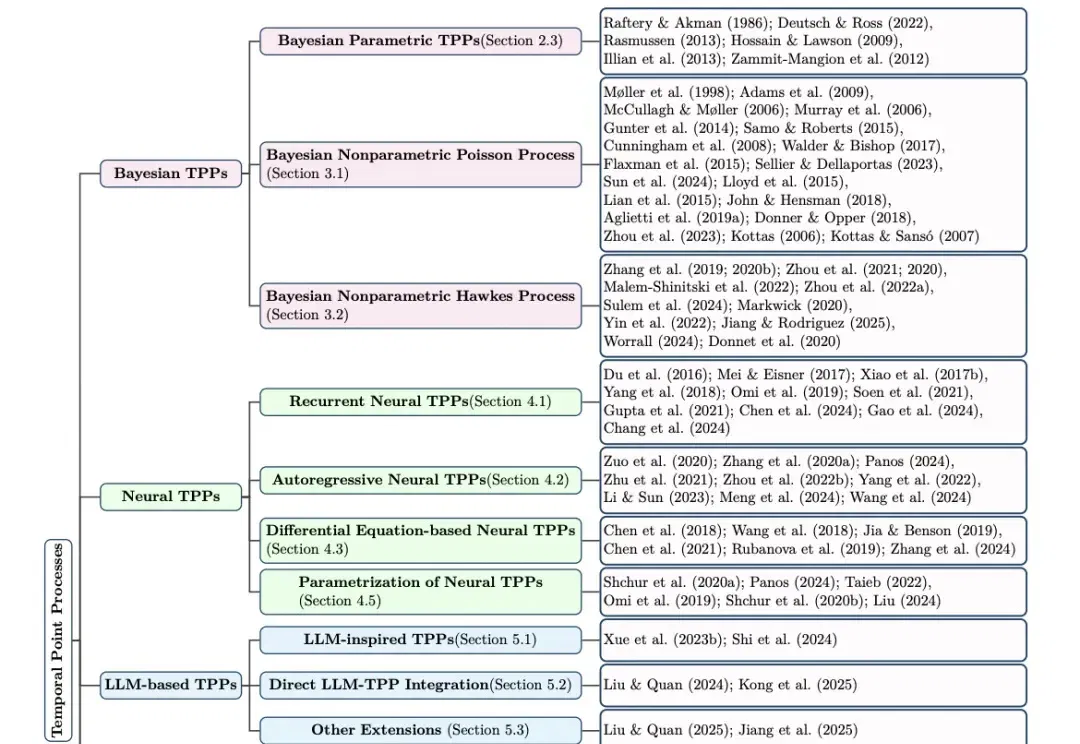
机器学习已经习惯了处理序列:一句话中的词、视频中的帧、推荐系统中的点击、金融市场中的订单。但在很多真实场景里,数据并不是按固定步长排好队出现的。
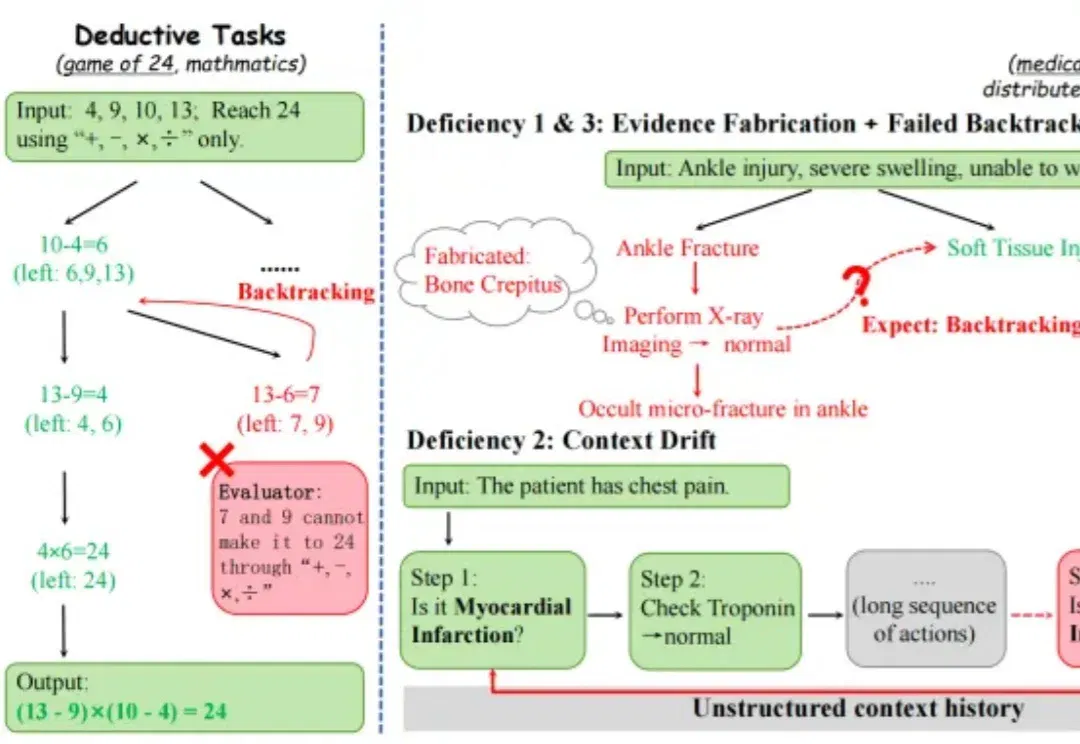
近年来,大语言模型在数学、代码等任务上的表现不断刷新上限,但到了医疗诊断、故障排查这类真实世界任务里,真正困难的是让多个智能体在不确定的动态环境中持续协作推理。
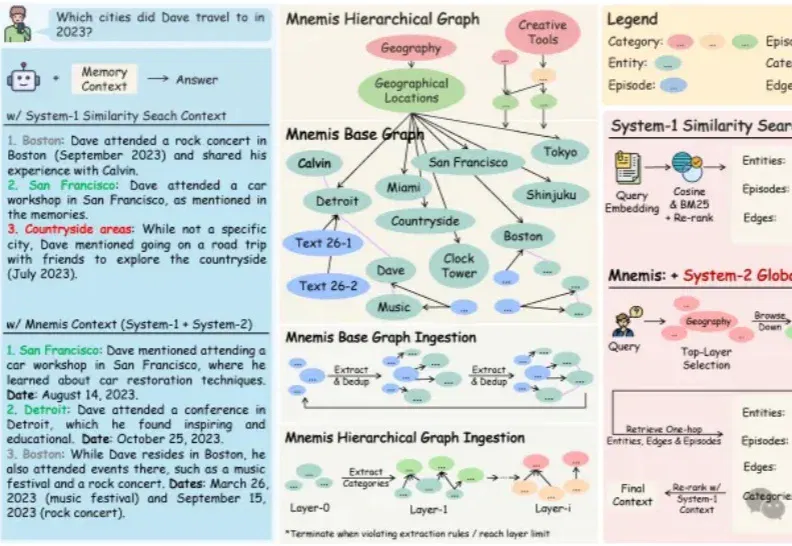
随着大语言模型在各类应用中加速落地,一个核心技术瓶颈日益凸显——AI始终缺乏真正的长期记忆能力。当前主流的RAG(检索增强生成)方案依赖语义相似度检索历史信息,但“语义相似”并不等于“真正相关”,常常出现检索结果不完整、无法区分信息相关性、缺乏推理能力等问题。
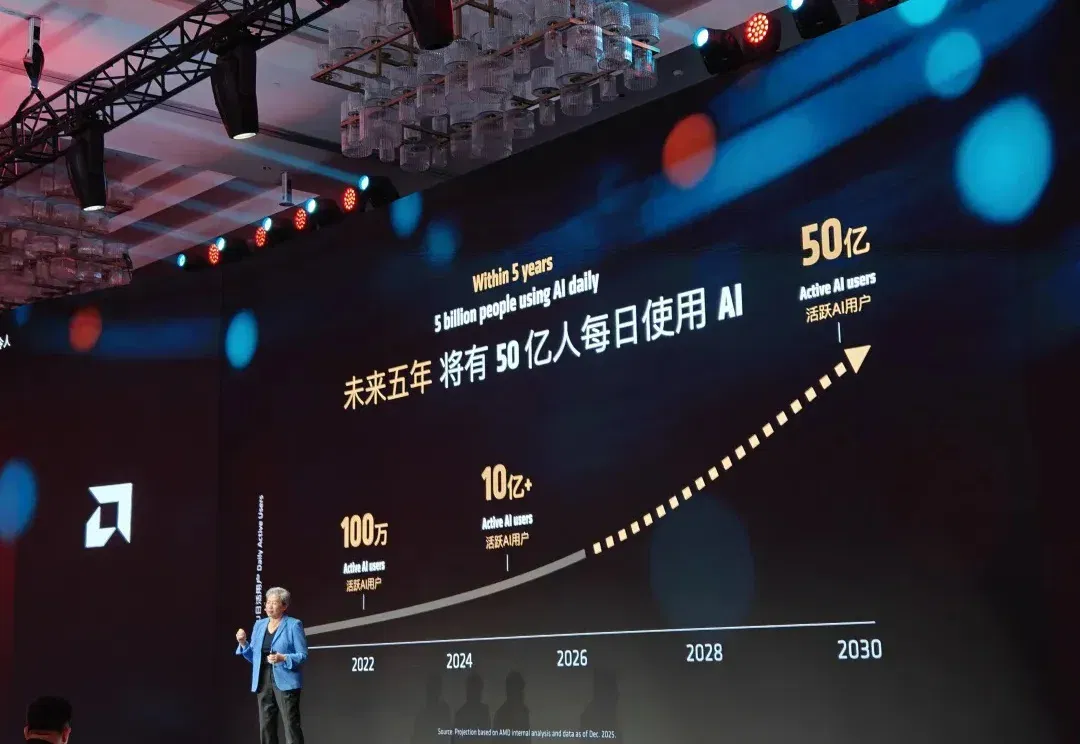
黄仁勋刚走,苏妈就来了。 这是 AMD 第一次把 AI 开发者大会搬到中国。苏姿丰没穿皮衣,开场第一句话是冲着全场喊:「你们兴奋吗?」台下站满了人,连过道都挤不动。 AMD 在中国卖了三十多年芯片,但这次不太一样。苏妈带着 ROCm、八大实操工作坊、还有一整个开源生态来,还顺手把上海研发中心的家底亮了出来:它是 AMD 全球最大的研发中心之一。 她给了一个数字:未来几年,全球 AI 活跃用户将超过五十亿。 苏妈在现场花了大段篇幅讲一件事:大语言模型「问一个问题、得一个答案」的时代正在翻篇。 「我们每个人可以拥有 5 个智能体、10 个智能体,或者 100 个智能体。想想你能多做多少事情。」 要
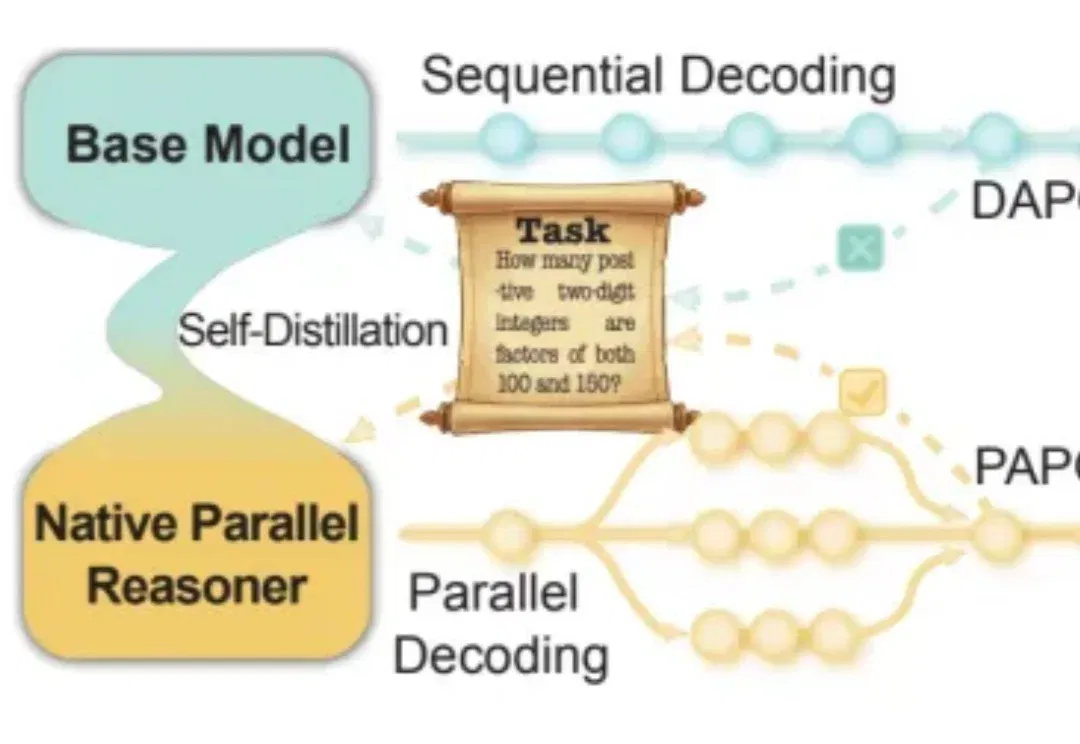
近年来,大语言模型在「写得长、写得顺」这件事上进步飞快。但当任务升级到真正复杂的推理场景 —— 需要兵分多路探索、需要自我反思与相互印证、需要在多条线索之间做汇总与取舍时,传统的链式思维(Chain-of-Thought)往往就开始「吃力」:容易被早期判断带偏、发散不足、自我纠错弱,而且顺序生成的效率天然受限。
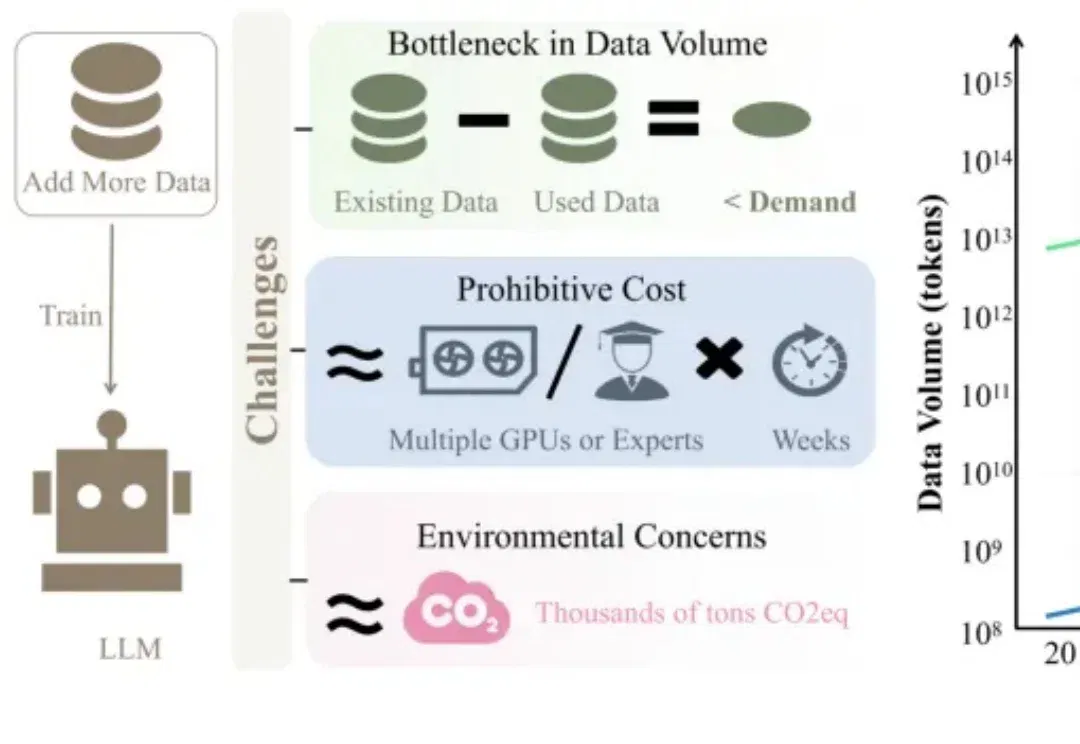
当训练数据枯竭、训练成本飙升,大语言模型(LLM)训练之路该何去何从?
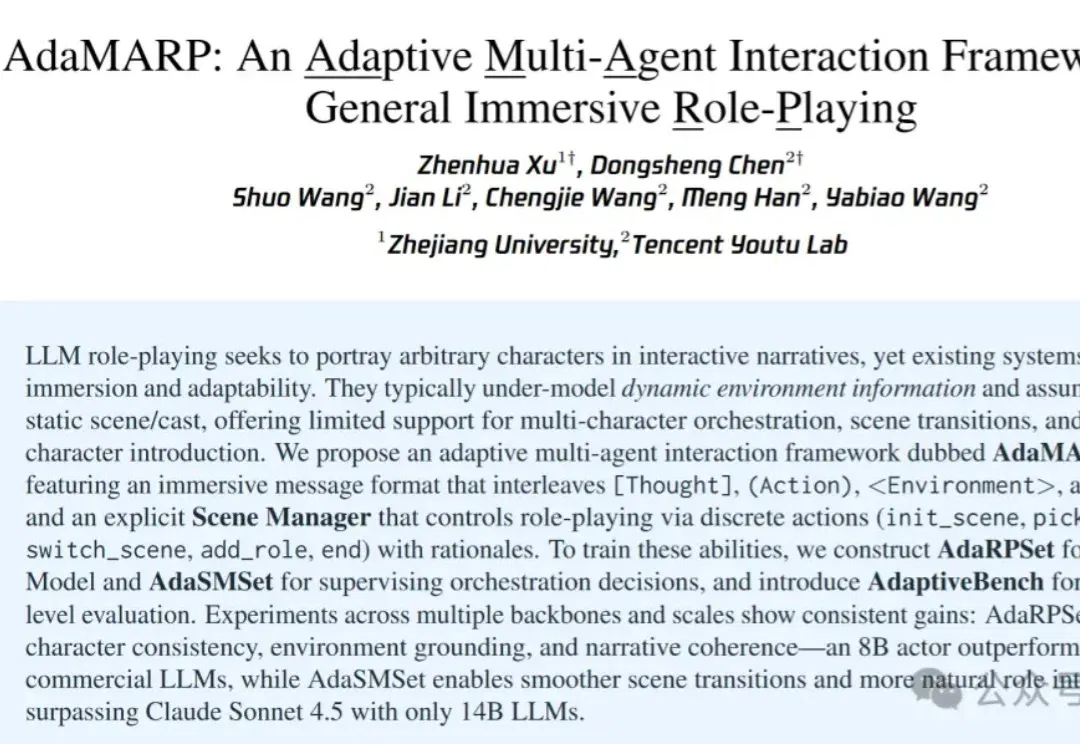
AI能实现真正的沉浸式扮演了。 大语言模型在角色扮演任务上进展迅速,但现有系统往往缺乏沉浸感和适应性: 环境信息未被充分建模,场景与角色也多为静态,难以支撑多角色调度、场景切换、动态引入新人等复杂叙事需求。 现在,浙江大学联合腾讯优图实验室提出AdaMARP(Adaptive Multi-Agent Interaction Framework for General Immersive Role-Playing)—— 一种面向通用沉浸式角色扮演的自适应多智能体交互框架。 该框架通过四通道消息格式和场景管理器,让AI不仅会「说」,还会「想」、会「动」、会「感知环境」,并在复杂叙事中灵活切换场景、