Qwen又立功,全球最快开源模型诞生,超2000 tokens/秒!(在新窗口打开)
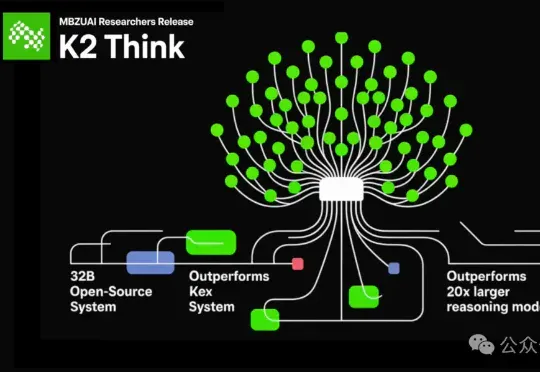
全球最快的开源大模型来了——速度达到了每秒2000个tokens! 虽然只有320亿参数(32B),吞吐量却是超过典型GPU部署的10倍以上的那种。它就是由阿联酋的穆罕默德·本·扎耶德人工智能大学(MBZUAI)和初创公司G42 AI合作推出的K2 Think。
共 619 篇
全球最快的开源大模型来了——速度达到了每秒2000个tokens! 虽然只有320亿参数(32B),吞吐量却是超过典型GPU部署的10倍以上的那种。它就是由阿联酋的穆罕默德·本·扎耶德人工智能大学(MBZUAI)和初创公司G42 AI合作推出的K2 Think。

腾讯三季报显示营收2073.36亿元、资本开支814.33亿元。公司称WorkBuddy日活超1000万,按用户每日大语言模型Token消耗总量居国内首位;报道还讨论云业务增收与AI投入对盈利、现金流的影响。
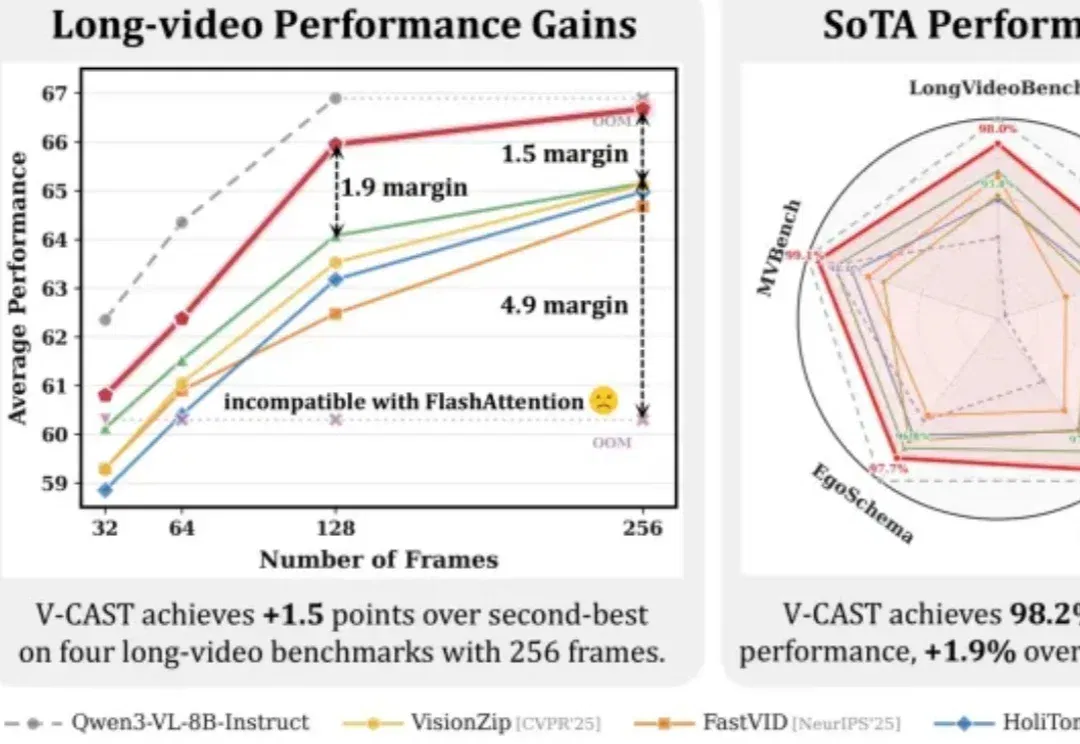
V-CAST结合视频变化分配Token预算,并保留时空坐标。在团队测试中,不同模型的准确率、内存和端到端耗时收益各异,耗时减半对应特定音视频配置。
百度开源文心 5.5 Flash Base(ERNIE 5.5 Flash Base)权重,该模型总参数280B、每token激活14B,采用稀疏MoE与混合稀疏注意力,微调和推理上下文外扩至1M tokens。
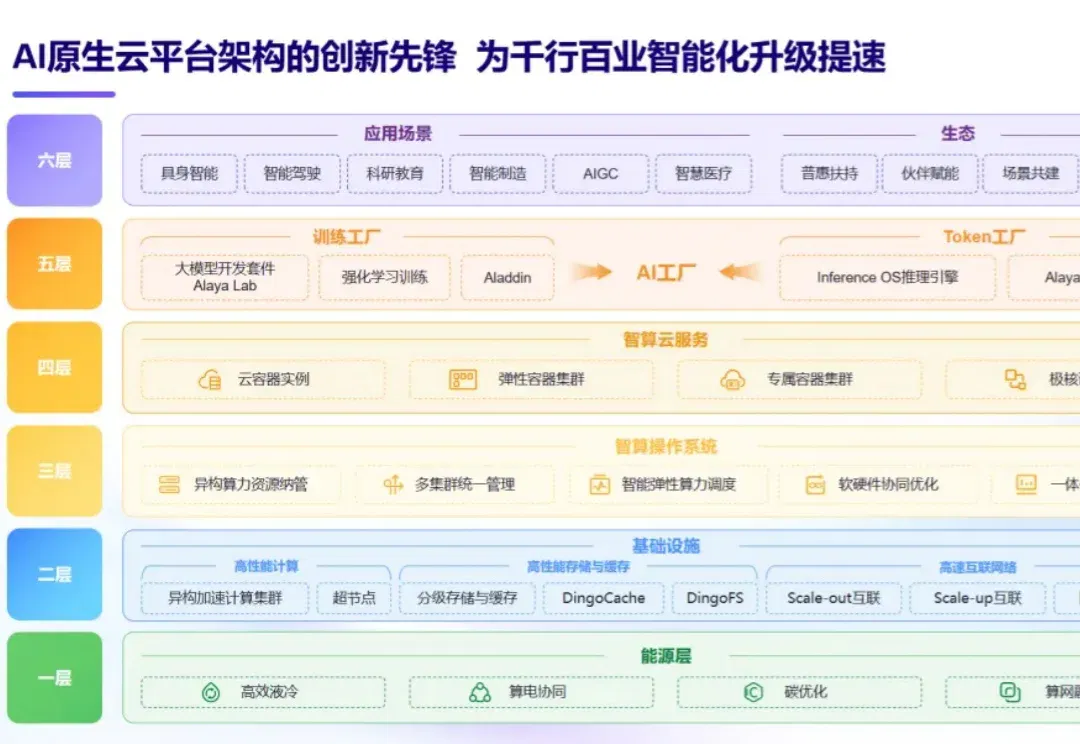
报道介绍九章云极以DCU核算资源投入、以Token记录交付,并通过异构调度及推理优化比较单位成本。公司披露的利用率、客户案例和收入变化反映其经营口径;统一内部计量不等于行业已形成通用结算标准。
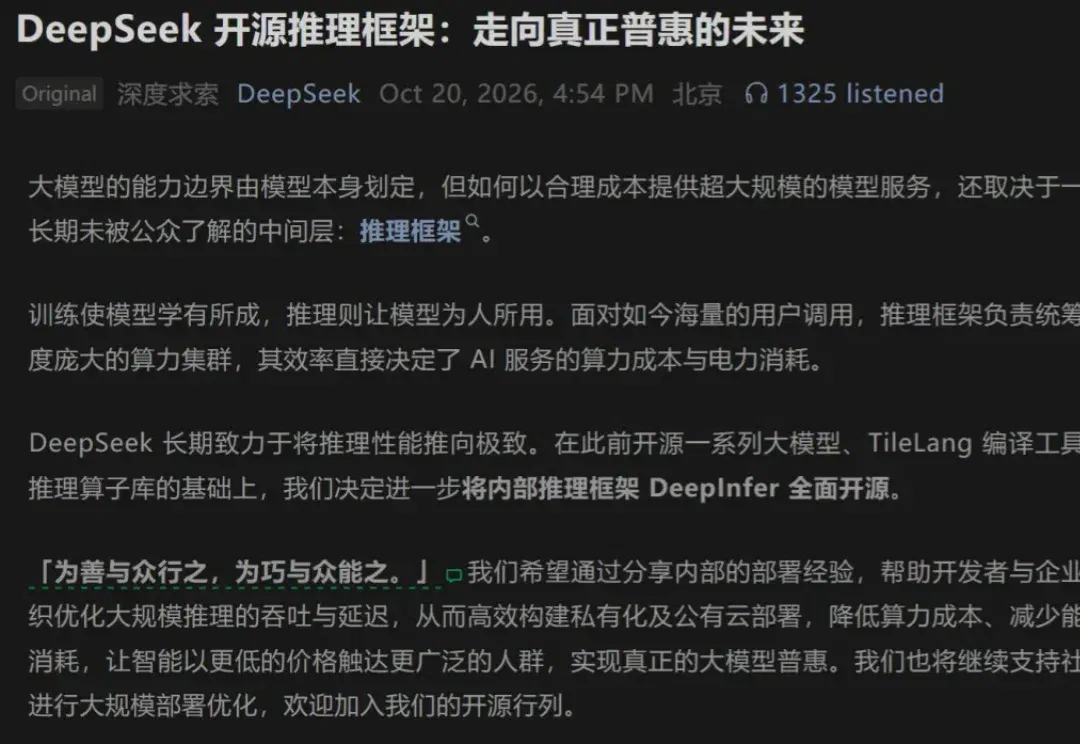
没想到这也开源了。 10 月 20 日下午,DeepSeek 开源了内部使用的推理框架 DeepInfer,以及配套的 token 编解码组件 deepseek-recipe。 DeepInfer 是目前支撑 DeepSeek 大规模推理服务的基础,本次以 Apache 2.0 许可证发布,当前支持 DeepSeek-V4.1-Flash。 这次发布迅速引起了关注,昨天大家讨论的都是 DeepSeek 现在让大家都可以快速部署自己的 AI 模型了,今天转念一想,不对,大模型推理怎么这么赚钱啊? DeepSeek 披露,基于这套系统,单个集群每天服务的吞吐量达到 155 万亿 token,按 A
STILL被NeurIPS 2026正式接收,这一首个内容感知的同层混合注意力架构通过自显著性分数按内容选择token,仅用0.04B训练token即在16K上下文下实现80%显存削减和83%预填充加速。
在Anthropic冲刺IPO之际,Meta将Claude Code活跃用户从6万降至3万并转向Muse Code,微软也将内部Claude支出削减逾33%,单员工月度Token预算从10万美元降至1万美元。
北京AI基础设施公司九章云极向港交所递交上市申请,2025年收入同比增长177.7%达10.98亿元,累计交付超31000 PFLOPS算力,正推进Token工厂战略。
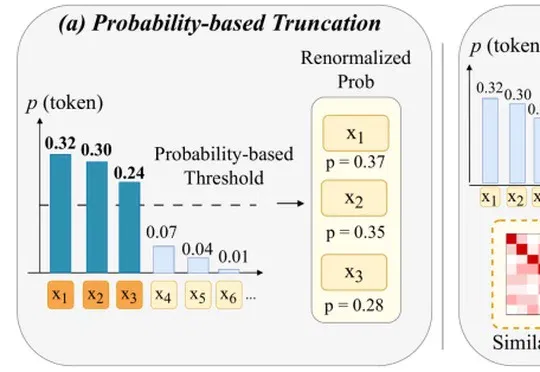
中国人民大学代文林、孟澄研究员团队提出的ME-Decoding方法被EMNLP 2026接收,该方法在解码时同时利用token概率与embedding相似度,从集合层面筛选低冗余候选token,在GSM8K和GPQA上取得所比较方法中最高的平均准确率,端到端GPU延迟仅增加约3%。