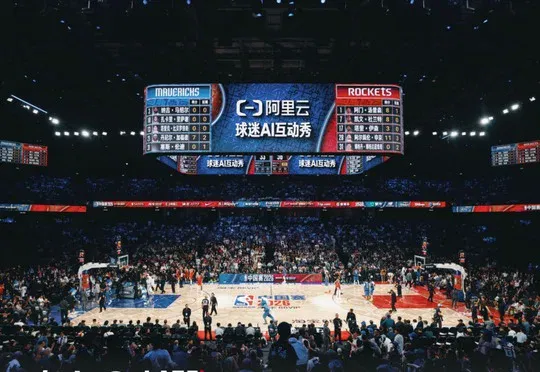
当懂球的 NBA,遇上懂 AI 的阿里(在新窗口打开)
阿里与NBA中国在2026年NBA中国赛中运用升级至Qwen 3.8-Max的NBA Chat、RT360和Wan 3.0,提供个性化问答、多视角实时回放及消费权益,推动赛事体验与运营智能化。
共 219 篇
阿里与NBA中国在2026年NBA中国赛中运用升级至Qwen 3.8-Max的NBA Chat、RT360和Wan 3.0,提供个性化问答、多视角实时回放及消费权益,推动赛事体验与运营智能化。
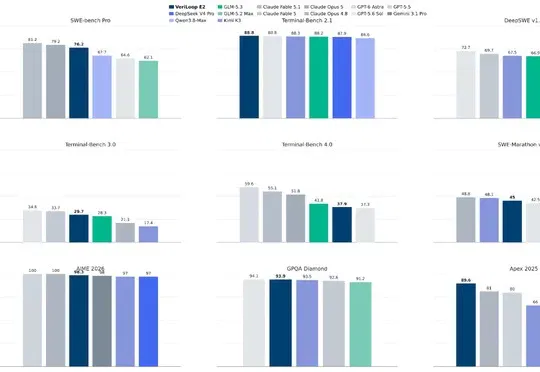
清华团队开源以Qwen 3.8-27B为基础模型的VeriLoop E2,通过VGR外部证据门控实现可验证状态提交,并取得黎曼猜想临界线零点比例下界67.350003708785593%的严格有限维证书,但上游形式化桥接尚未完成。
开源版Jev训练保姆级教程发布,基于Qwen3-0.6B底座在本地单卡环境完成数据下载、案例级切分、全参数微调、温度校准及本地接口部署全流程,600步训练后在2000道决策题测试集上达到78.05%准确率。
APUS(麒麟合盛)旗下AI实验室公开全球最早一批Jev独立开源复现成果fast-browser-use,基于Qwen3.5等开源模型在RTX PRO 6000上将单次决策压缩至79毫秒,并以9B小模型对标Jev性能。
当AI不再只会聊天。 TypeSafe在9月15日公开这款模型时,给它取了一个很大的名字,System One Model。 它不写回复,也不生成代码,只接收一段状态信息和一组问题,然后返回选择结果、分数或者概率。 上线没多久,社区里就出现两种截然不同的看法。 不少开发者直言,这个思路不算新鲜。给一段文字,配上几组备选答案,让模型挑最合适的选项,这类做法早就有人做过。 零样本分类就能完成类似任务,BERT类编码器也可以在固定标签里做判断,GLiNER和受约束解码还有别的实现方案。 Jev的架构、权重和训练细节又没有公开,因此很难仅凭产品发布就把底层方法认作技术突破。 第二种态度更偏向先用起来。
嗨害嗨,今年我又去了云栖大会。 今天的大会少了经典的大堵车环节,因为大会首次打破了多年的传统! 将主会场从云栖小镇外迁至杭州国际博览中心,承载能力更强了,整体展览面积超过5万平方米,联合了超1000家
Mind Lab(马卡龙)正式发布面向企业的模型后训练与推理平台 Mint Recursive,将其从 Macaron V1.1 训练实践中沉淀的 MinT 底层系统、自动化训练与迭代管线以托管服务形式开放给企业,支持 GLM、Qwen、DeepSeek、Kimi、MiniMax 等开源基座及监督微调、强化学习、全参数训练和 LoRA。
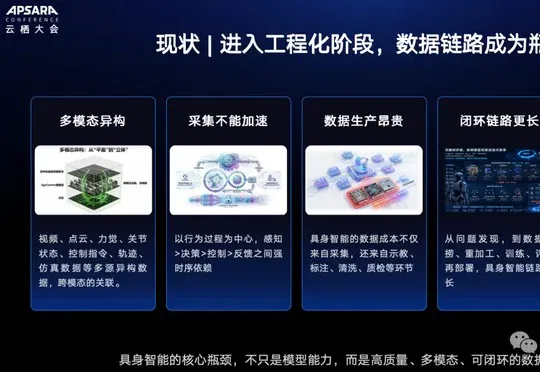
在2026云栖大会具身智能论坛上,阿里云展示了覆盖采、存、洗、标、质检增广、训练评测到数据管理的全栈数据产线能力,通过Qwen标注、HappyHorse增广、PAI训练与平头哥真武芯片协同,将具身智能企业的反馈迭代周期从周级压缩至日级,穹彻智能、苏度科技、莫刻机器人等企业已率先跑通这条数据飞轮。
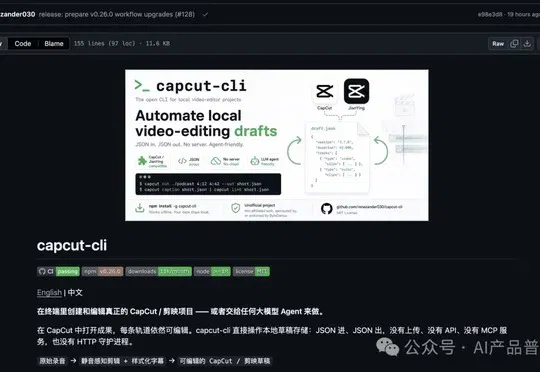
作者用 Qoder 搭配 Qwen3.8-Flash 模型调用开源工具 capcut-cli,在剪映 5.9 中自动完成口播视频的字幕识别、贴字和音效添加,生成可继续手动修改的分轨草稿。
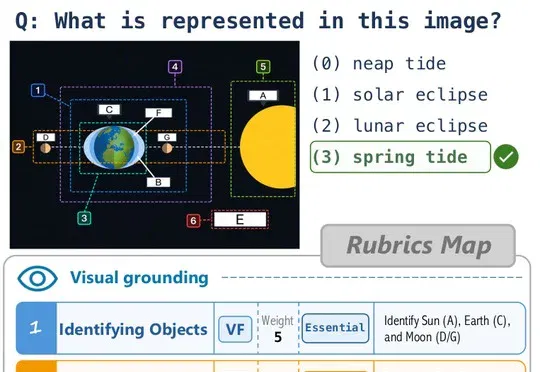
南洋理工大学S-Lab、A*STAR与UIUC联合提出的V-Rubrics方法将5万视觉样本拆分为35万条细粒度准则,从视觉忠实性、推理一致性和指令遵循三维度分别参与强化学习奖励分配,使基于Qwen3-VL-8B的模型在通用与知识评测中平均得分提升至68.04。