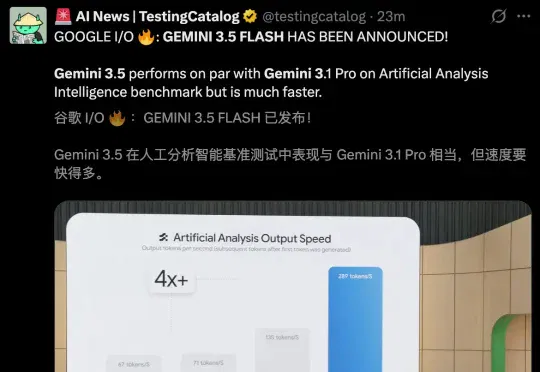
Gemini 3.5来了!今夜,谷歌亲手淘汰谷歌(在新窗口打开)
劈柴和Hassabis把半年大招一晚清仓了!Gemini Omni任意输入生成视频,3.5 Flash断层碾压一切,Spark 7×24h云端替你干活。这次,谷歌是要把OpenAI和Anthropic一起给埋了。
共 483 篇
劈柴和Hassabis把半年大招一晚清仓了!Gemini Omni任意输入生成视频,3.5 Flash断层碾压一切,Spark 7×24h云端替你干活。这次,谷歌是要把OpenAI和Anthropic一起给埋了。
发布会还没开,谷歌彻底藏不住了!Gemini 3.2 Flash网页端静默上线,被开发者抓了个正着。单次提示狂飙2200行代码、手搓Windows 98,直接把自家旗舰Pro按在地上摩擦。
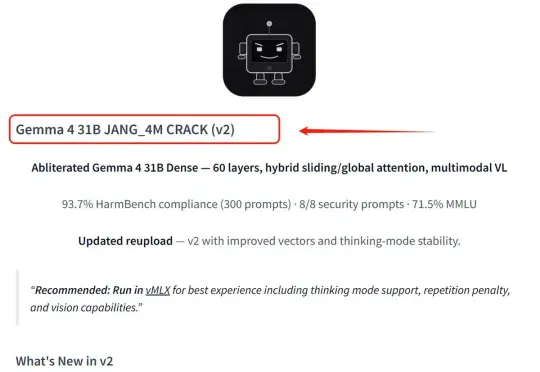
有个31B参数的大模型,正常需要80GB显存才能跑。但现在,24GB显存就能跑满血版。这个版本叫Gemma-4-31B-JANG_4M-CRACK——"CRACK"这个词不要理解歪了,它本质是量化压缩加上对齐微调之后的部署版本,不是什么黑客攻击,就是工程优化。24GB,MacBook Pro,直接跑。苹果用户优先优化,MLX原生支持,月下载13000次。
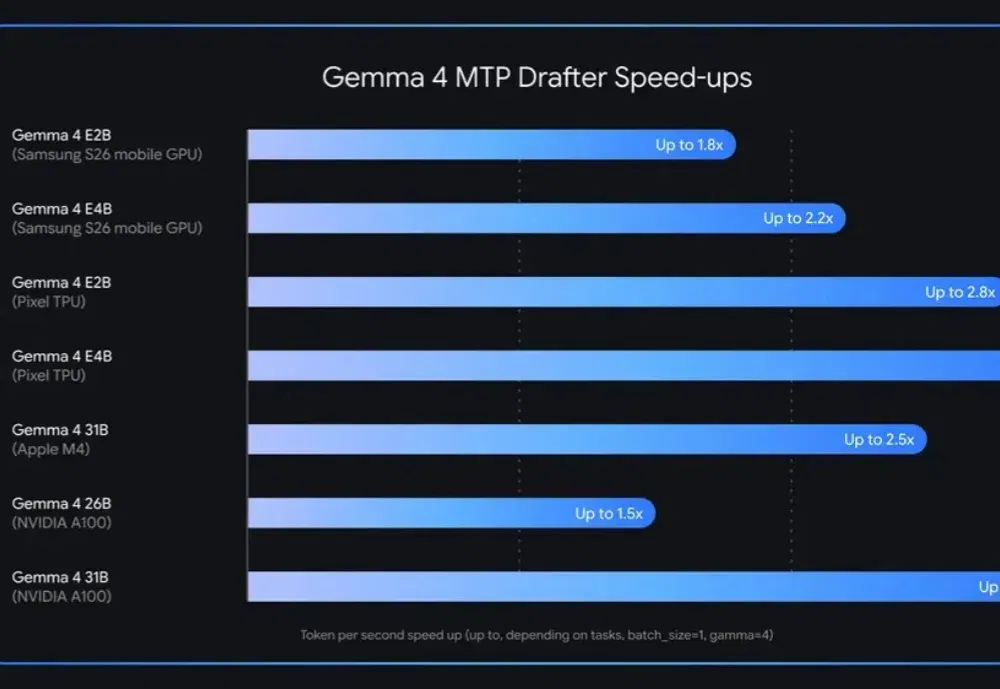
谷歌刚刚给Gemma 4家族更新了一项关键能力:Multi-Token Prediction(MTP)推测解码架构,推理速度最高提升3倍,输出质量不变。
谷歌豪掷400亿美元加注Anthropic,自家Gemini正面对垒的「敌人」。当Claude年化收入一年暴涨30倍冲到300亿,当算力成为AI下半场唯一硬通货,与其用Gemini硬刚,不如把对手变成TPU最大买家。
阿里前几天开源的Qwen3.6-35B-A3B,让这次讨论不再只是一次普通的新旧模型对比。它一边要面对谷歌Gemma4-26B-A4B的外部竞争,一边又必须回答一个更麻烦的问题:相较于 Qwen3.5-35B-A3B,它到底是升级,还是修补?更现实的是,很多人现在真正跑着的,其实是Qwen3.5-27B,那么这条新的35B-A3B路线,到底值不值得迁过去。
Gemini 终于推出桌面客户端了!除了能做网页端的一切,它的杀手锏是能捕捉屏幕上所有窗口,突破浏览器限制,把一切都装进模型上下文,帮你解读一切。
对本地部署玩家,尤其是Mac用户来说,长上下文推理最大的痛点往往不是“模型不够聪明”,而是稍微多用点上下文,统一内存就被撑爆了”,这一点在最近的Gemma-4 31B的部署中尤为明显,在同等上下文的情况,显存占用比Qwen3.5-27B高约一倍不止,直接劝退了不少人。但好消息是,谷歌近期提出的TurboQuant KV缓存量化算法,正是为了解决这个痛点而生。
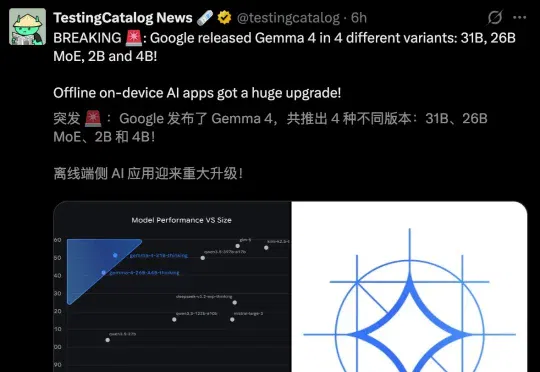
谷歌深夜掏家底!Gemma 4全系开源,仅用31B越级斩杀20倍体量巨头。数学能力暴涨68%,硬生生把前代打成计量单位,开源界迎来终极大洗牌!
实测生成曲目完整动听,免费可用。 智东西3月26日消息,谷歌于当地时间3月25日发布了AI音乐生成模型Lyria 3 Pro。作为上月发布的Lyria 3的进阶版本,Lyria 3 Pro由谷歌DeepMind团队打造,最大的升级是音乐时长大幅提升,由此前的30秒提升至3分钟。此外,模型能够理解歌曲结构,用户可以通过提示词指定前奏、主歌、副歌、桥段等段落,对完整歌曲进行精细控制。 与模型升级同步,谷歌还将Lyria 3系列一口气铺进了Vertex AI、Google AI Studio与Gemini API、Google Vids、Gemini应用以及ProducerAI等多个产品平台,覆盖从