X上63万人围观的Traning-Free GRPO:把GRPO搬进上下文空间学习(在新窗口打开)
年初的 DeepSeek-R1,带来了大模型强化学习(RL)的火爆。无论是数学推理、工具调用,还是多智能体协作,GRPO(Group Relative Policy Optimization)都成了最常见的 RL 算法。
共 1517 篇
年初的 DeepSeek-R1,带来了大模型强化学习(RL)的火爆。无论是数学推理、工具调用,还是多智能体协作,GRPO(Group Relative Policy Optimization)都成了最常见的 RL 算法。
从 AlphaGo 战胜人类棋手,到 GPT 系列展现出惊人的推理与语言能力,强化学习(Reinforcement Learning, RL)一直是让机器「学会思考」的关键驱动力。
现有视觉语言大模型(VLMs)在多模态感知和推理任务上仍存在明显短板:1. 对图像中的细粒度视觉信息理解有限,视觉感知和推理能力未被充分激发;2. 强化学习虽能带来改进,但缺乏高质量、易扩展的 RL 数据。
美团LongCat团队发布了当前高度贴近真实生活场景、面向复杂问题的大模型智能体评测基准——VitaBench(Versatile Interactive Tasks Benchmark)。VitaBench以外卖点餐、餐厅就餐、旅游出行三大高频生活场景为典型载体,构建了一个包含66个工具的交互式评测环境,并设计了跨场景综合任务。
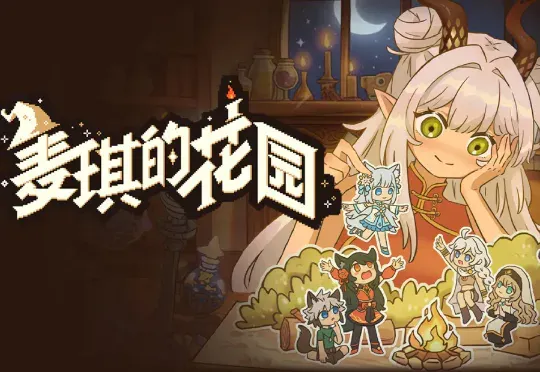
AutoGame 创始人张昊阳离开腾讯后,带领团队打造的 AI 游戏《麦琪的花园》在 Steam 零推广登上新品榜 Top50,一个月积累超 5000 愿望单。通过自研 GameGPT 多智能体框架和大模型架构,他们让普通玩家能“一句话生成 NPC、任务与道具”,将 UGC 创作门槛降至短视频级别,把传统“金字塔型”内容生态变为“十字型”社交表达平台。
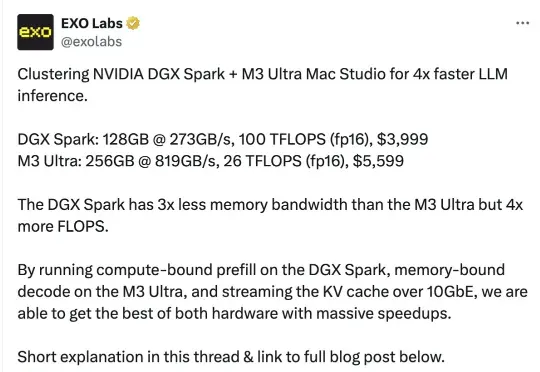
英伟达桌面超算,邪修玩法来了!两台DGX Spark串联一台苹果Mac Studio,就能让大模型推理速度提升至2.77倍。
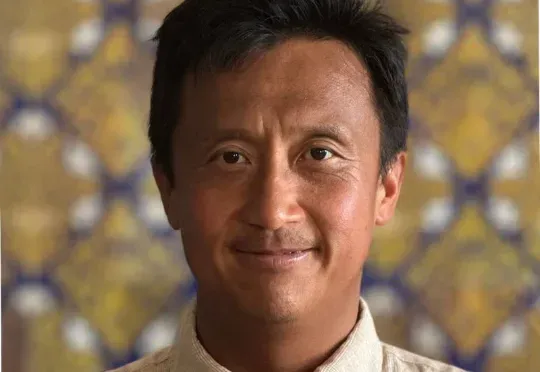
苹果又一华人AI高管被Meta挖走了!据彭博社爆料,这次被挖的是Ke Yang(杨克),负责AI搜索与问答系统,几周前刚被任命为AKI团队负责人,负责让Siri追赶上ChatGPT等主流大模型的能力。而离职消息一出,苹果AI的未来或又将添上许多变数。
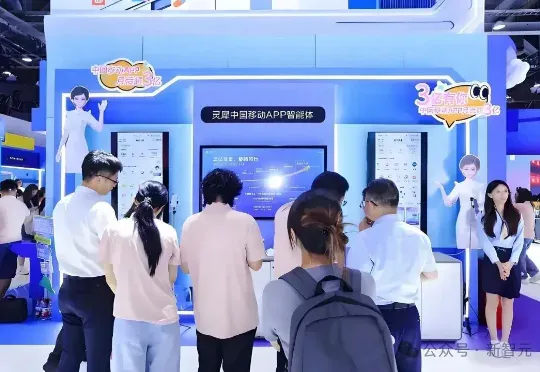
从「深蓝」到ChatGPT和DeepSeek,AI已从棋盘上的较量转向生产力革命。中国移动以自研「九天」大模型为核心,打造「灵犀智能体」,一个能理解意图、主动服务的全场景生活助手。通过「灵犀贴贴」实现AI+NFC的便捷交互。同时「爱购商城」以「AI豆」构建统一价值体系,打通通信、消费与智能生态,为用户提供个性化、温度化的智能生活新范式。
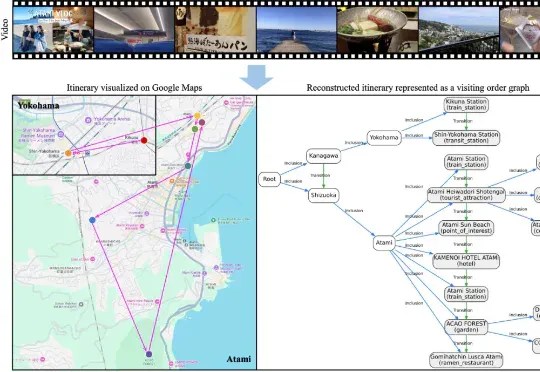
大家或许都有过这样的体验: 看完一部喜欢的动漫,总会心血来潮地想去 “圣地巡礼”;刷到别人剪辑精美的旅行 vlog,也会忍不住收藏起来,想着哪天亲自走一遍同样的路线。旅行与影像的结合,总是能勾起人们的
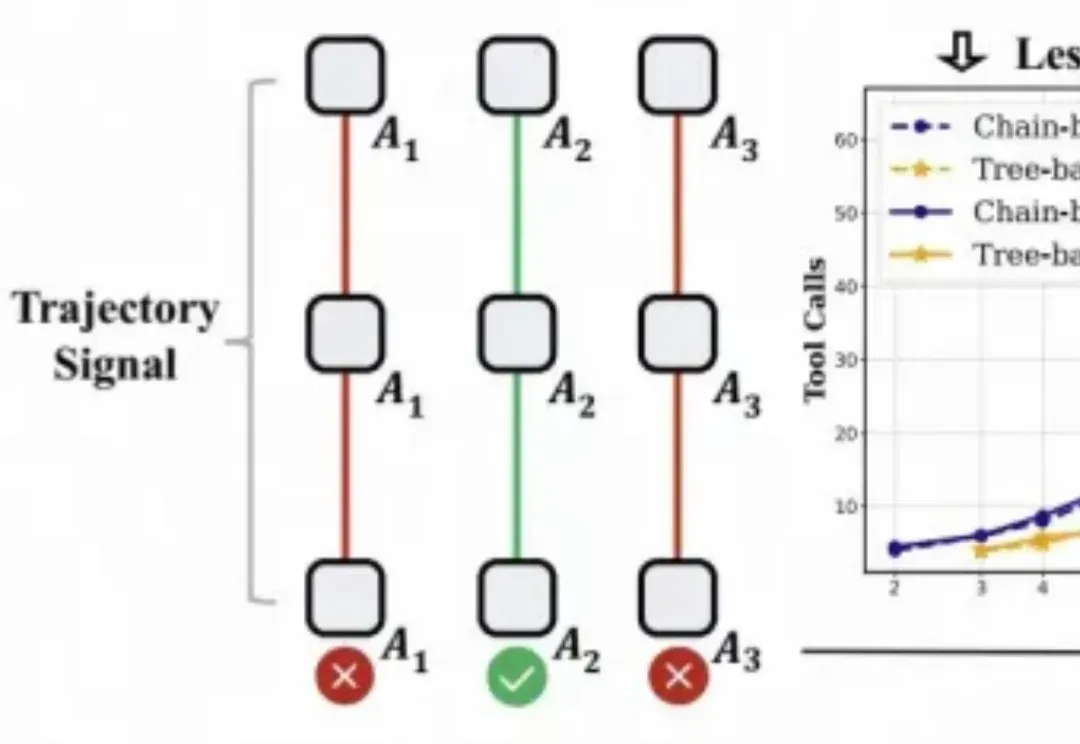
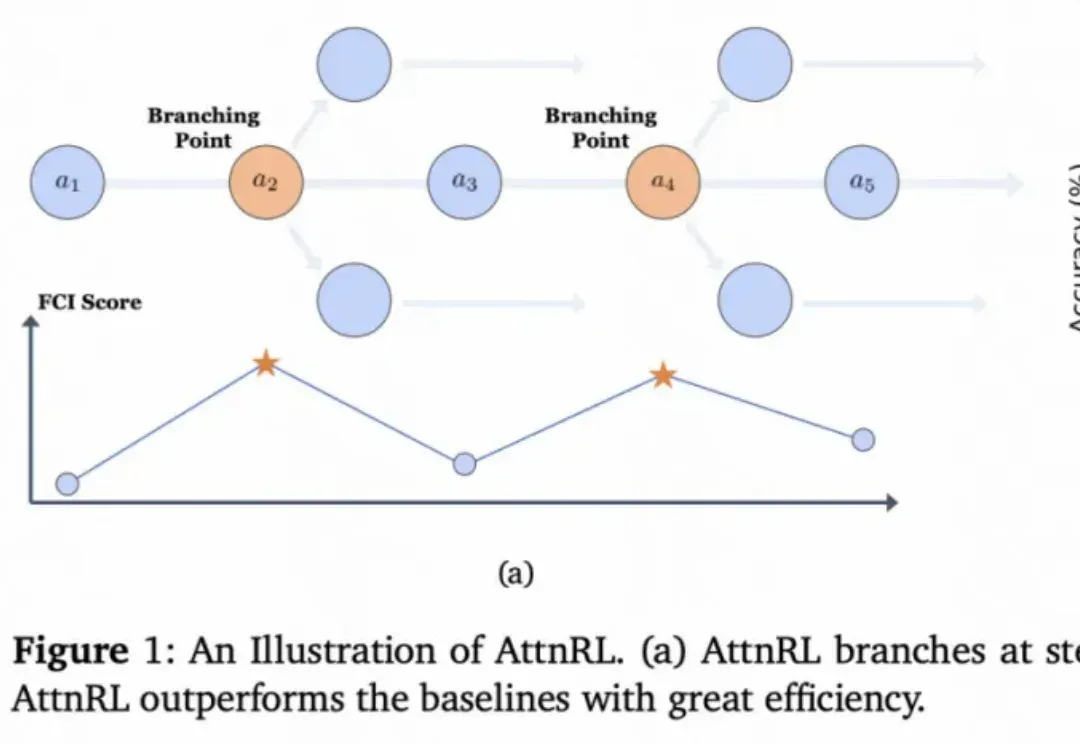
对于大模型的强化学习已在数学推理、代码生成等静态任务中展现出不俗实力,而在需要与开放世界交互的智能体任务中,仍面临「两朵乌云」:高昂的 Rollout 预算(成千上万的 Token 与高成本的工具调用)和极其稀疏的「只看结果」的奖励信号。