无奖励也能把Agent练硬,Meta发布早期经验学习,隐式建模+反思(附提示词)(在新窗口打开)
Meta提出早期经验(Early Experience)让代理在无奖励下从自身经验中学习:在专家状态上采样替代动作、执行并收集未来状态,将这些真实后果当作监督信号。核心是把“自己造成的未来状态”转为可规模化的监督。
共 318 篇
Meta提出早期经验(Early Experience)让代理在无奖励下从自身经验中学习:在专家状态上采样替代动作、执行并收集未来状态,将这些真实后果当作监督信号。核心是把“自己造成的未来状态”转为可规模化的监督。
苹果又一华人AI高管被Meta挖走了!据彭博社爆料,这次被挖的是Ke Yang(杨克),负责AI搜索与问答系统,几周前刚被任命为AKI团队负责人,负责让Siri追赶上ChatGPT等主流大模型的能力。而离职消息一出,苹果AI的未来或又将添上许多变数。
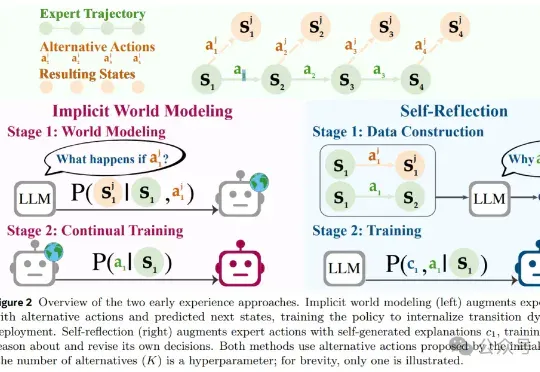
风雨飘摇中的Meta,于昨天发布了一篇重量级论文,提出了一种被称作「早期经验」(Early Experience)的全新范式,让AI智能体「无师自通」,为突破强化学习瓶颈提供了一种新思路。
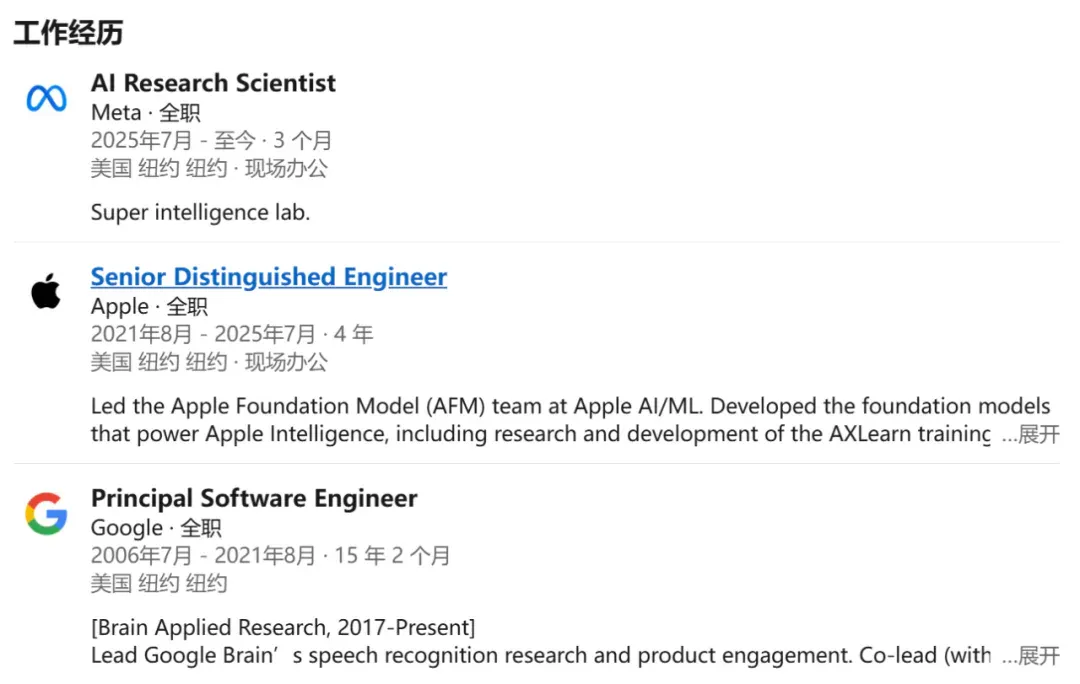
数月前,苹果基础模型团队负责人、杰出工程师庞若鸣(Ruoming Pang)离职加入 Meta。扎克伯格豪掷两亿美元招揽庞若鸣加入超级智能团队。根据庞若鸣的领英信息,他已在 Meta 工作了大约三个月的时间。
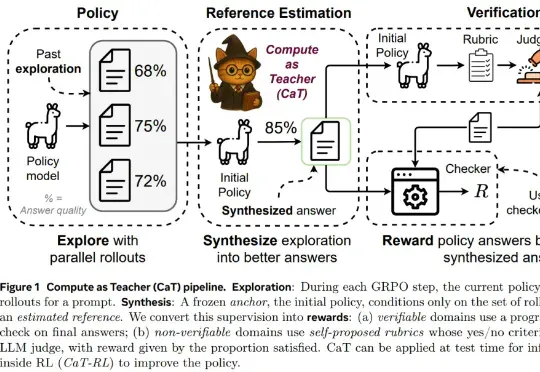
为了回答这一问题,来自牛津大学、Meta 超级智能实验室等机构的研究者提出设想:推理计算是否可以替代缺失的监督?本文认为答案是肯定的,他们提出了一种名为 CaT(Compute as Teacher)的方法,核心思想是把推理时的额外计算当作教师信号,在缺乏人工标注或可验证答案时,也能为大模型提供监督信号。
就在 Scale AI 公司的 95 后创始人 Alexandr Wang 在 Meta 挑大梁之际,他迎来了一位比他更小的 00 后劲敌。这名 00 后叫阿里·安萨里(Ali Ansari),是一名
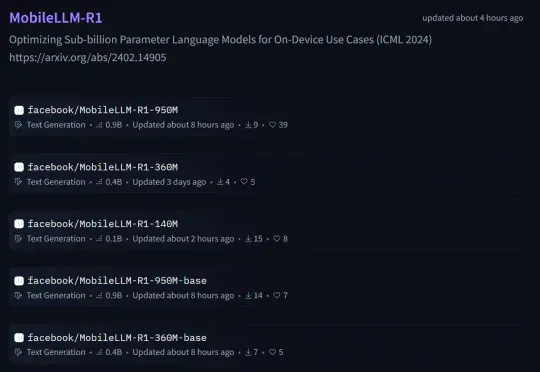
本周五,Meta AI 团队正式发布了 MobileLLM-R1。 这是 MobileLLM 的全新高效推理模型系列,包含两类模型:基础模型 MobileLLM-R1-140M-base、MobileLLM-R1-360M-base、MobileLLM-R1-950M-base 和它们相应的最终模型版。
Meta超级智能实验室(MSL)又被送上争议的风口浪尖了。
Meta 已签署一份价值超 1 亿美元的多年度合同,将使用 AI 图像初创公司 Black Forest Labs 的技术,这是这家社交媒体公司为扩展人工智能服务的最新投资。
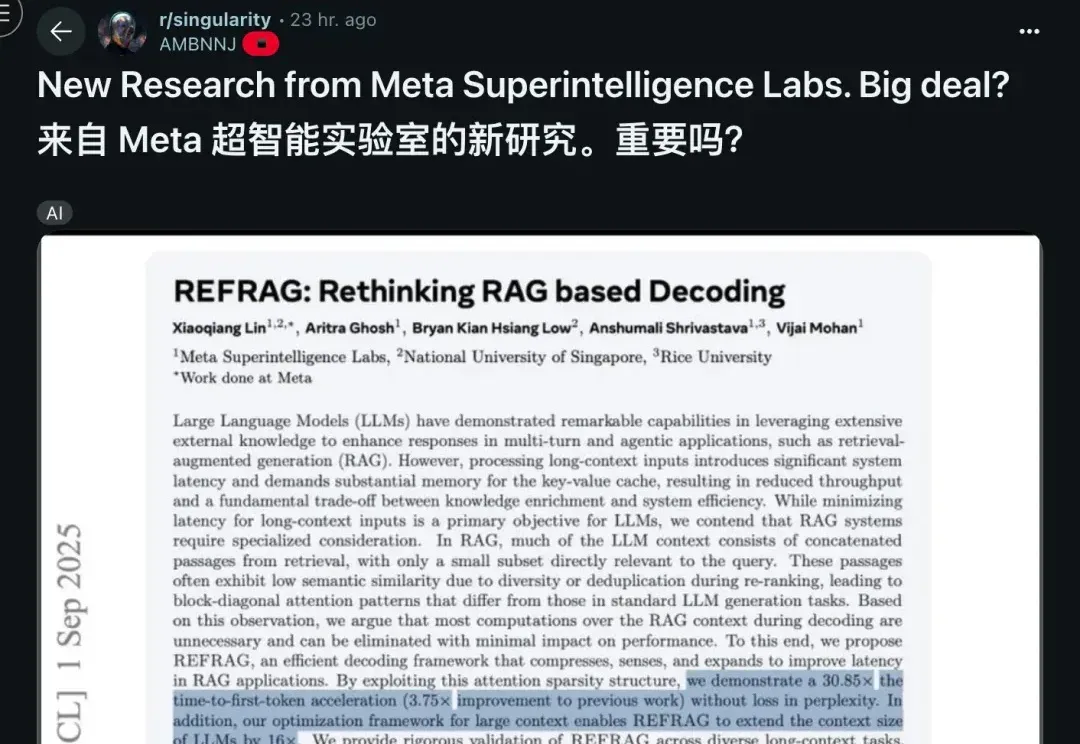
Meta超级智能实验室的首篇论文,来了—— 提出了一个名为REFRAG的高效解码框架,重新定义了RAG(检索增强生成),最高可将首字生成延迟(TTFT)加速30倍。