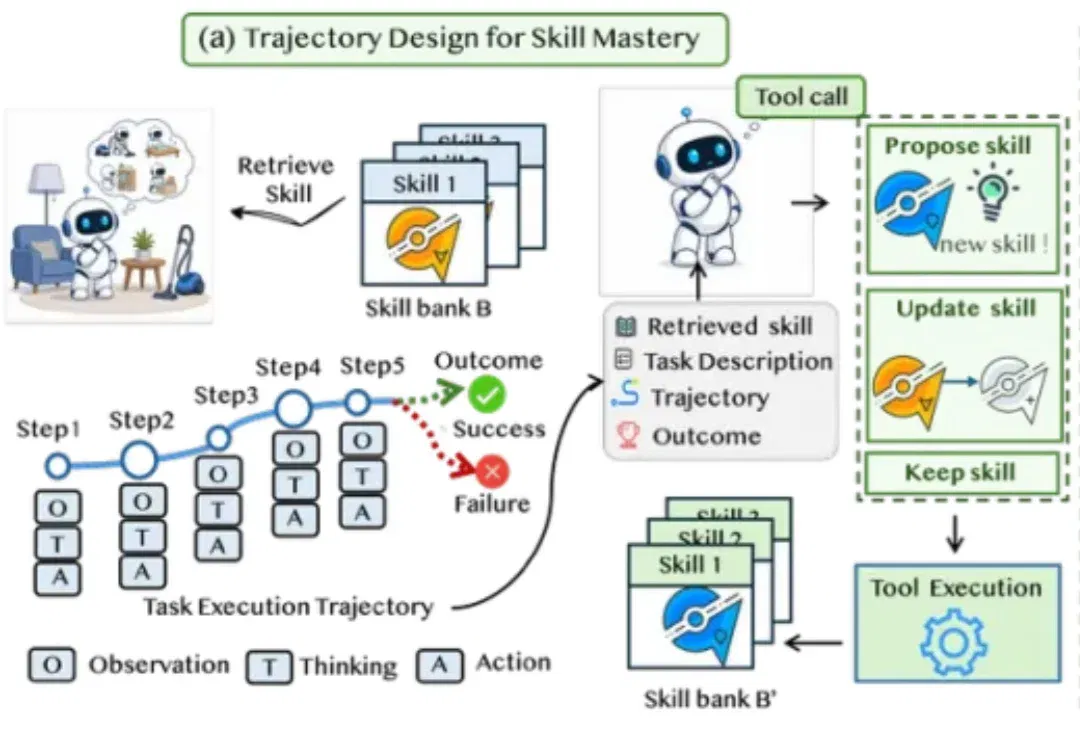
SkillMaster 联合训练任务执行与技能编辑,评估下游复用收益(在新窗口打开)
方法让同一策略创建、更新和保留外部技能,以相关探测任务的变化构造奖励,在ALFWorld、WebShop及搜索问答测试。
共 375 篇
方法让同一策略创建、更新和保留外部技能,以相关探测任务的变化构造奖励,在ALFWorld、WebShop及搜索问答测试。
上海交大团队将其MetaPred理论方案做成可运行模型,在约1320万参数实验中与同规模GPT基线比较,尚非完整AGI系统验证。
DeepTech 与秦浩桐讨论模型极限压缩、训练后量化与真实设备上的推理延迟,回顾 BiLLM 的研究思路,并谈到如何用硬件测试、代码核对和实验反馈判断效率研究的价值。
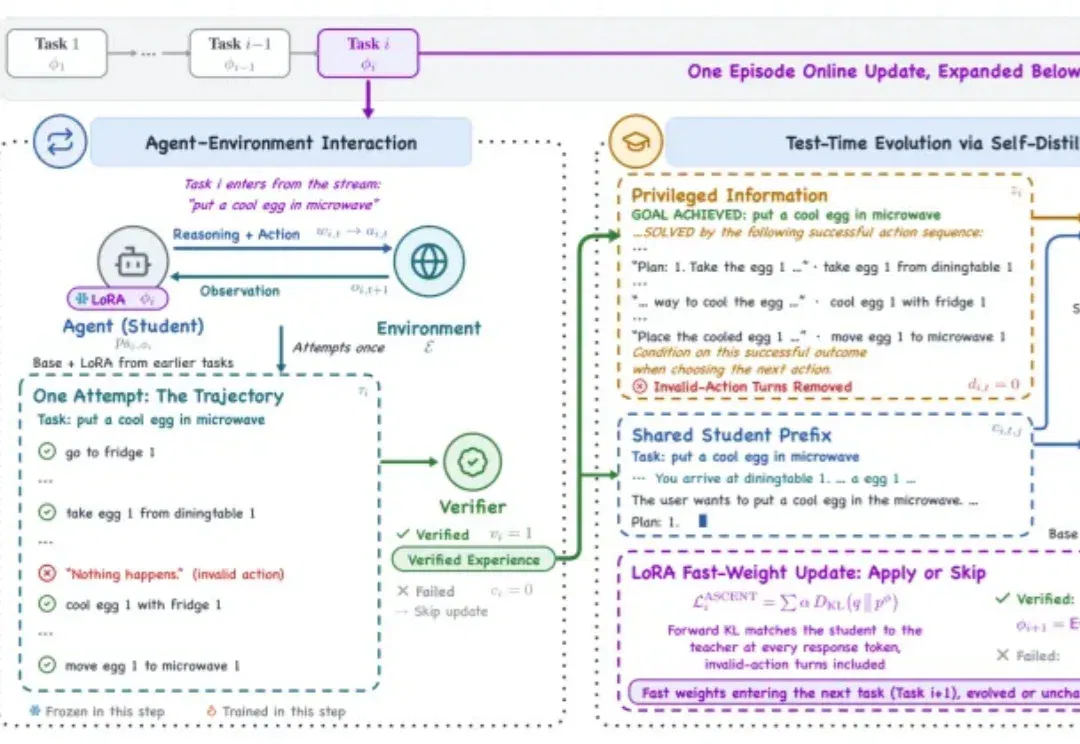
LLM智能体如何在部署过程中,通过自身执行持续进化?
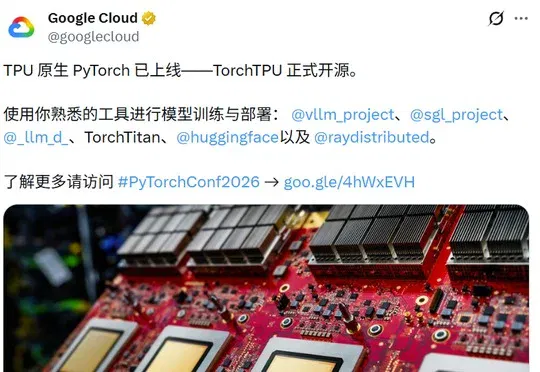
谷歌与Meta联合开源TorchTPU,使TPU成为PyTorch原生设备,并完成vLLM、SGLang、Hugging Face、Ray、TorchTitan等主流项目接入,CUDA的软件生态护城河开始松动。
48小时,全球大乱套了! 就在昨天,全世界一大片互联网接近瘫痪。AI已经入侵整个人类世界! 这48小时,堪称人类网络安全史上的「黑色十月」。 支撑全球70%网站的代码曝出致命漏洞;美国华尔街紧急拔网线;拉美400家银行被AI智能体攻击。 有人直言:「RIP Internet(互联网安息吧)」。 node.js:安全漏洞。 PHP:严重远程代码执行漏洞。 tensorlake:npm 包被感染。 liteLLM:恶意 PyPI + Docker 版本。 Railway:客户机密泄露。 zeabur:基础设施遭到入侵。 OpenCode:AI API 密钥泄露。 OVHcloud CLI:官方二进
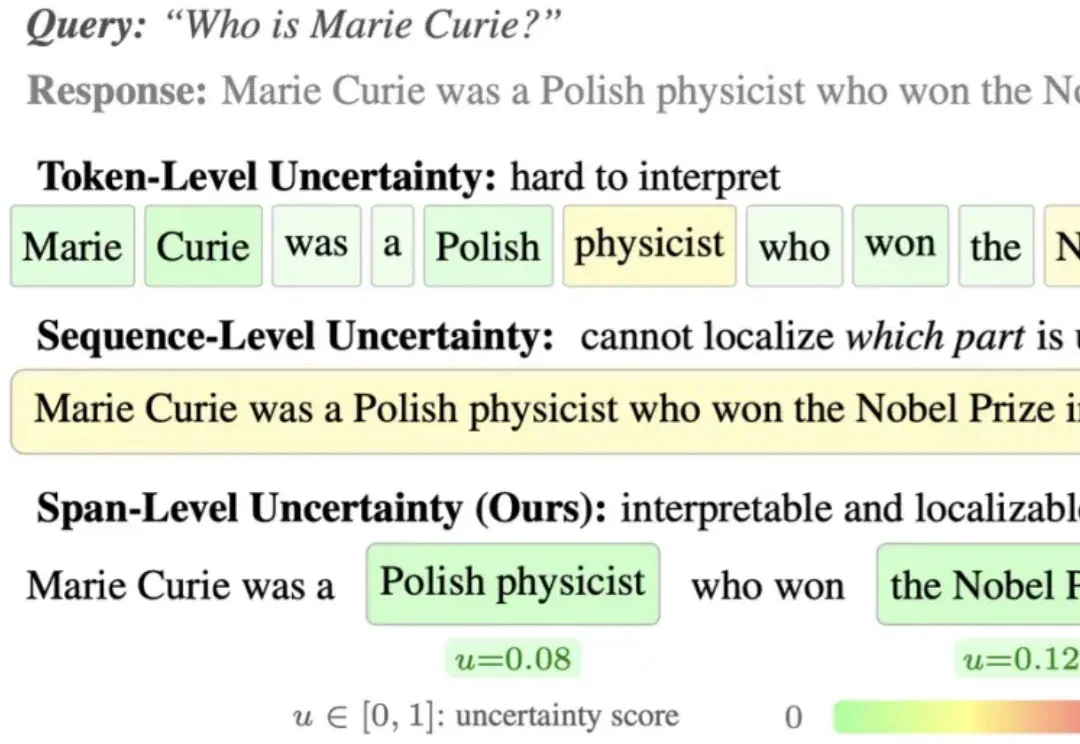
在将 LLM 真正应用到产品的过程中,我们经常会遇到一个看似简单、却非常关键的问题:模型生成的内容,究竟有多可信?
如今,AI正式杀入物理世界! 在具身能力方面,语言模型到底谁能称王? 更残酷的问题是,机器人公司耗费数年苦练的本领,会被通用LLM直接碾压吗? 就在今天,GPT-6 Astra、GPT-6.1 Sol、Claude Opus 5.5 以及 Gemini 4 Argon 等全球最顶尖的多模态大模型齐聚一堂。 在常态化具身智能仿真评测平台 RoboColiseum(机器人角斗场) 上,它们展开了一场真刀真枪的「肉搏战」。 这份榜单不仅彻底炒热了具身智能圈,更无情地揭露了当前顶尖大模型在控制机器人时的「隐藏命门」! 揭榜时刻:四模型大乱斗,结果令人意外 本次测试,所有的顶尖模型都接入了统一的控制框架
真是活久见! 连Linux之父,都让Claude来写内核了。就在最近,一位开发者在刷新Linus的官方内核仓库时,赫然发现了一个极不寻常的新分支——noref-filemap-read-with-llm
vLLM Semantic Router推出并开源Decision 3.0系列多模态决策模型,覆盖0.6B至27B六款模型,其中d3在Jev Decision Index 0.3.1文本榜和视觉榜均排名第一。