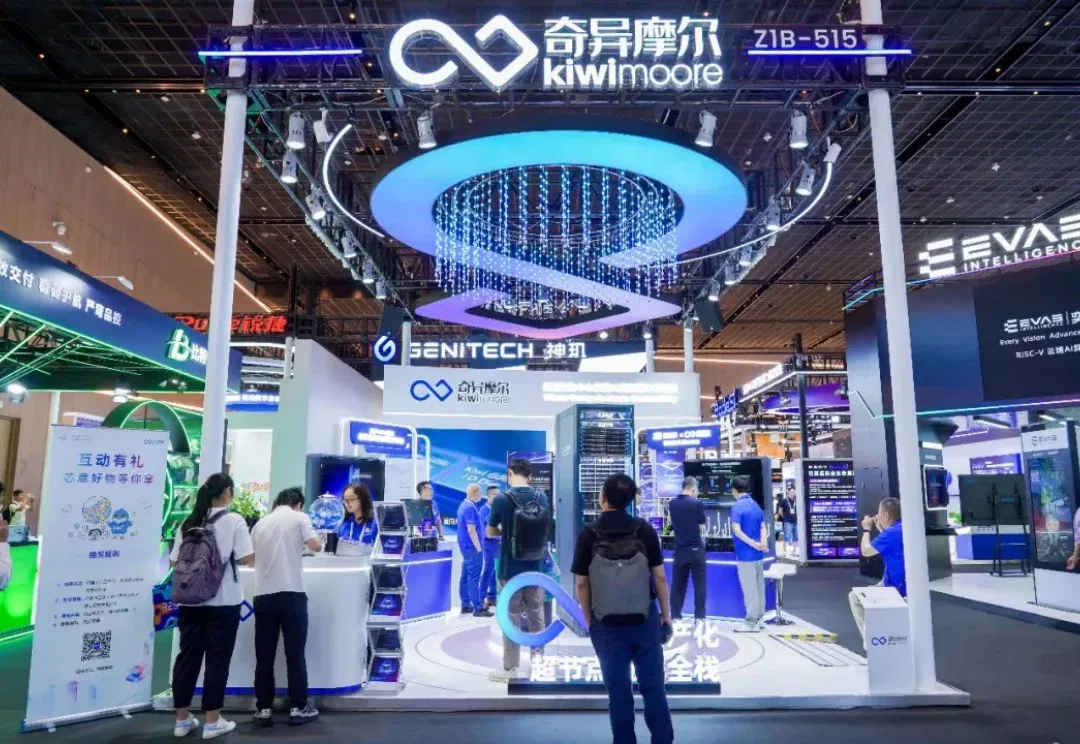
不靠英伟达网卡,国产GPU直通方案实测出炉:吞吐飙升、延迟砍半(在新窗口打开)
7月17日至20日,2026世界人工智能大会暨人工智能全球治理高级别会议(WAIC 2026)在上海世博、张江、西岸“三地四馆”同步启幕。
共 229 篇
7月17日至20日,2026世界人工智能大会暨人工智能全球治理高级别会议(WAIC 2026)在上海世博、张江、西岸“三地四馆”同步启幕。
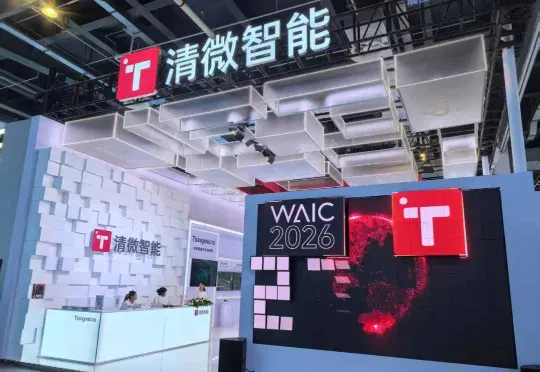
过去,大家围着国产芯片问的是,峰值算力多少?制程多少纳米?和英伟达相比差多少? 走到清微智能的展位前,你会发现一件有意思的事:这里摆的不只是芯片。可重构芯片、4K超节点、RAISA软件栈、行业应用,被放在一起呈现——像是在回答所有国产芯片厂商都绕不开的问题:
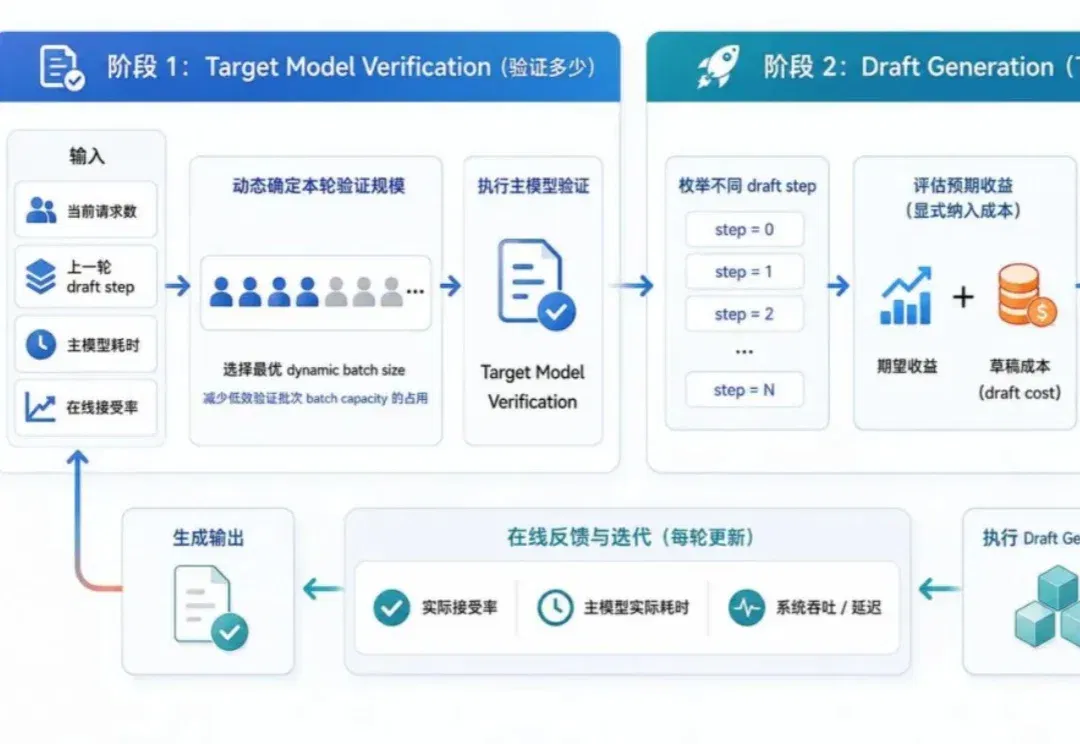
随着 DeepSeek 发布 DSpark,动态 MTP(多 Token 预测)成为了对抗高并发、提升 GPU 利用率的绝对焦点。然而,DSpark 高度绑定特定模型且需要额外训练。
7月6日,腾讯混元Hy3正式版发布。 同一天,几乎没有人注意到另一件事:微信AI团队在GitHub上 quietly 放出了Hidden Decoding at Scale的正式论文,WeLM技术博客同步更新。不仅如此,WeLM的官方技术团队还开设了小红书账号,开始对外宣传WeLM的技术成果。 信号的导火索在几个月前。据《中国企业家》报道,2026年腾讯年会上,微信高层公开表态,希望自己训练大模型,集团给予更多GPU支持。 在腾讯集团层面,混元是无可争议的「正规军」。前OpenAI研究员姚顺雨空降半年,AI Lab被整体并入,数百亿研发投入押注于此。 但在这条主线之外,微信事业群也正在悄悄发力
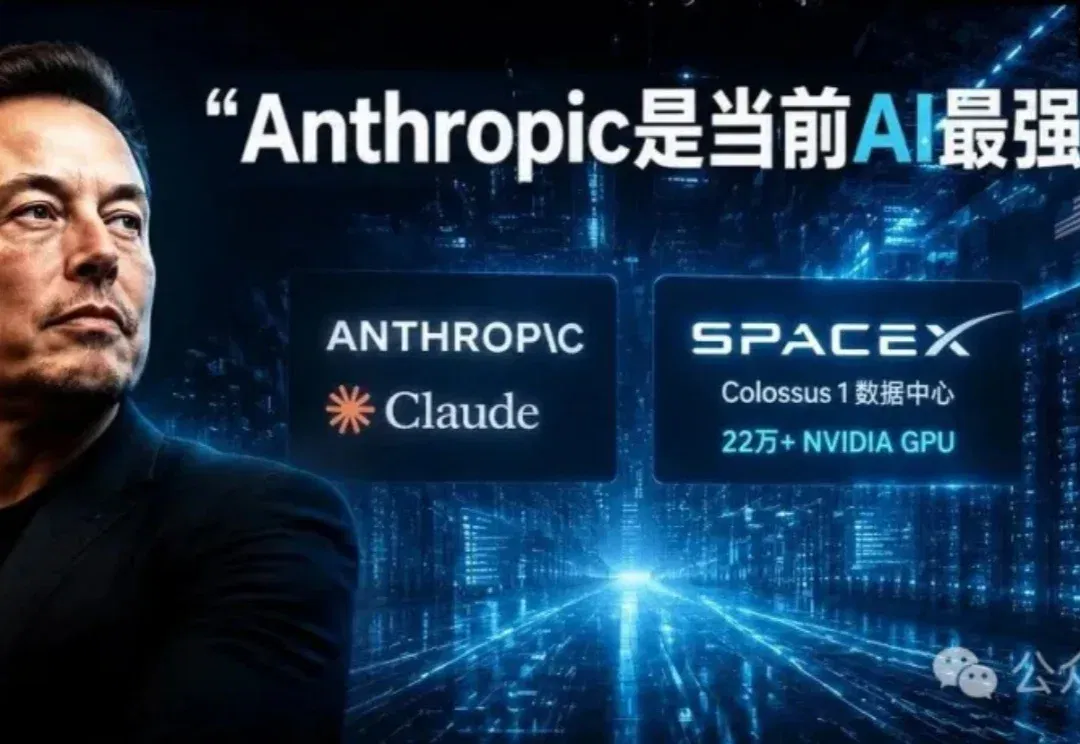
几个月前,马斯克还骂Anthropic「邪恶」,断言它「不可能赢」,如今突然改口称它是「当前AI最强」。 手握22万块GPU的他,为何没有趁机断供对手?
37.7°C,干趴了一台国家级AI超算。6月底,英国遭遇有记录以来最热的六月。剑桥大学的Dawn——全英最快的AI超算之一——冷却系统当场热瘫,上千块GPU被迫休了一周多的高温假,350多个科研项目全线急刹。
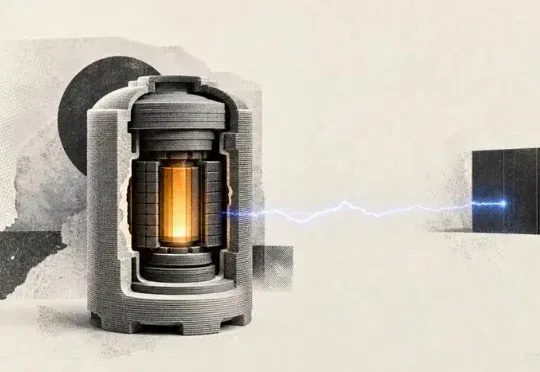
AI 时代,面临传统电网和可再生能源的压力,科技巨头们争夺的资源已不仅仅是 GPU,而是稳定、低价、全天候不断电的清洁能源。现在,解决方案或许又多了一个新的选择。近日,美国核能初创公司 Ampera 称,已基于 3D 打印完成全球首个全尺寸核反应堆模块,旨在为 AI 数据中心、国防应用、工业设施和偏远地区等提供清洁电力。
AI新云赛道再现巨额融资。成立于2022年的AI新云(Neocloud)公司Together AI,于7月1日正式宣布完成8亿美元C轮融资,投后估值达到83亿美元。Together AI的核心业务是出租NVIDIA GPU集群及其他AI专用基础设施,为企业提供运行开源大模型的云平台。
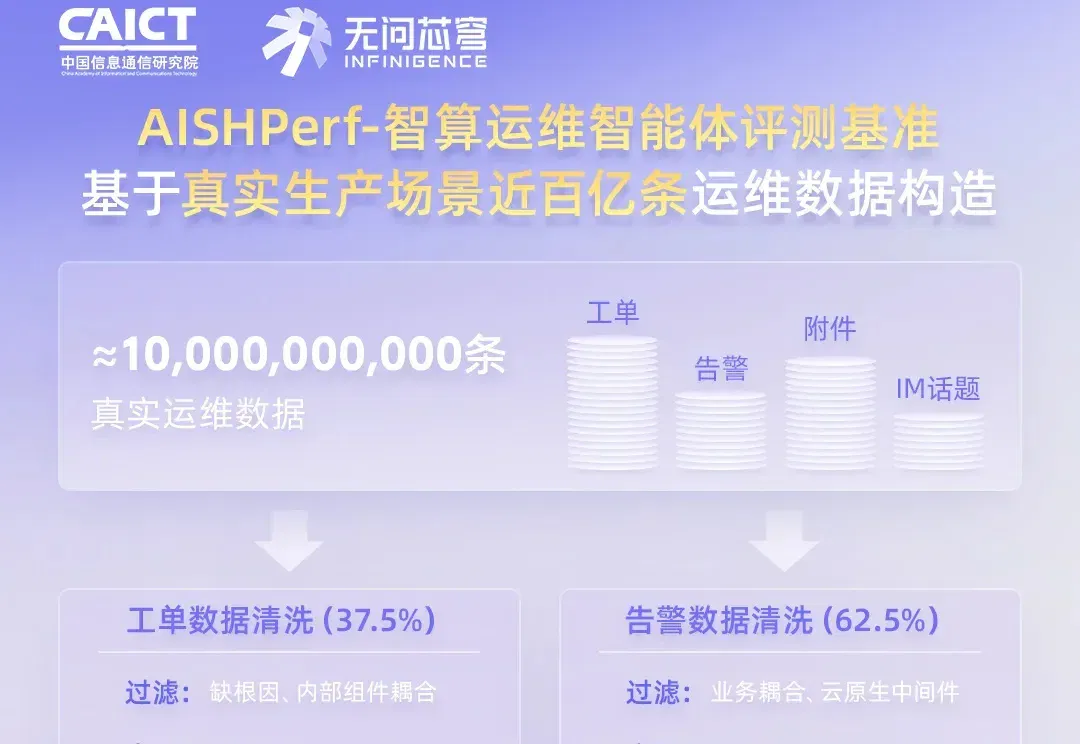
随着全球智能体加速落地,算力需求呈指数级爆发,以 GPU 为核心的 AI 基础设施正变得愈发关键。据摩根士丹利报告预测,2028 年全球 AI 基础设施累计总投资将达 2.9 万亿美元。
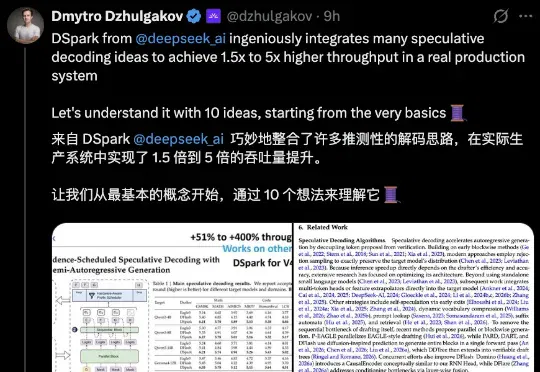
Fireworks AI的联合创始人兼CTO、PyTorch核心维护者Dmytro Dzhulgakov将整篇论文梳理成了10个概念,从最底层的GPU访存特性讲到最上层的在线自适应调度。DeepSeek这套方案真正的精髓在于系统工程和模型协同设计。