DeepSeek 要用蜜雪冰城的打法,做中国版 Claude Code(在新窗口打开)
DeepSeek 之于大模型,就像蜜雪冰城之于奶茶。你不必纠结性价比,因为它的本事你挑不出毛病,你的钱包它也从不为难。
共 530 篇
DeepSeek 之于大模型,就像蜜雪冰城之于奶茶。你不必纠结性价比,因为它的本事你挑不出毛病,你的钱包它也从不为难。
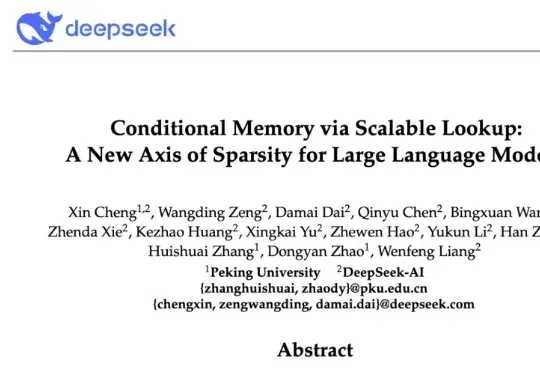
今天凌晨,喜欢闷声做大事的 DeepSeek 再次发布重大技术成果,在其 GitHub 官方仓库开源了新论文与模块 Engram,论文题为 “Conditional Memory via Scalable Lookup: A New Axis of Sparsity for Large Language Models”, 梁文锋再次出现在合著者名单中。
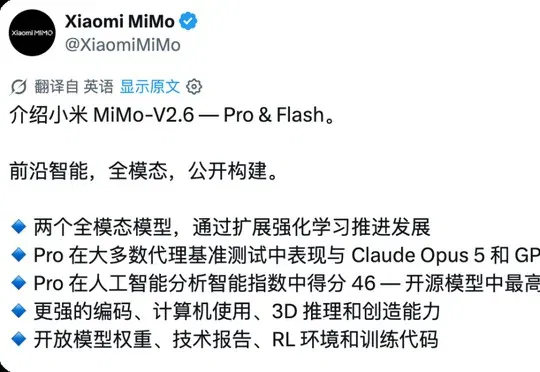
小米正式发布并开源 MiMo-V2.6 系列模型,罗福莉称其背后的研究创新和工程难度超过 DeepSeek R1,在 Artificial Analysis Intelligence Index v4.3 中以 46.32 分成为当前得分最高的开源模型,价格仅为海外同级模型的 1/20 至 1/60。
Anthropic、谷歌、OpenAI、Kimi、DeepSeek及阿里Qwen等全球AI大厂正密集备战,在中秋国庆假期前后集中推出或预告Claude 5.2、Gemini 4 Pro、Kimi K3.1、DeepSeek V4.1 Pro、Qwen4等旗舰基模,集体围攻OpenAI此前发布的GPT-6 Astra。
刚刚,DeepSeek 在官方 API 文档里给出了一个 thinking mode 和 tool call 结合使用的样例。表面上看,这只是一个常规的工具调用演示:用户提出问题,模型判断需要调用工具,工具返回结果后,模型再继续生成答案。
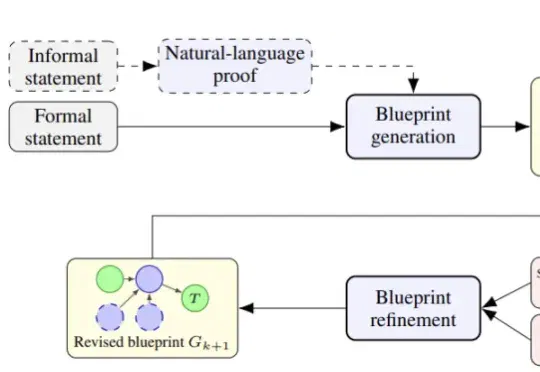
近日,普林斯顿大学的研究团队发布了一篇新论文,提出了一个名为 Goedel-Architect 的智能体框架。他们用的核心模型,是国内开源大模型 DeepSeek-V4-Flash。
你要是问当今互联网最神秘、最玄学、连量子力学都解释不清的「时空裂缝」在哪里?它不在百慕大,也不在诺兰导演的电影里,而是在你的 DeepSeek、Claude 或者 ChatGPT 正在思考的过程里。
这是一篇报告解读,原文是《DeepSeek-V3.2: Pushing the Frontier of Open Large Language Models》
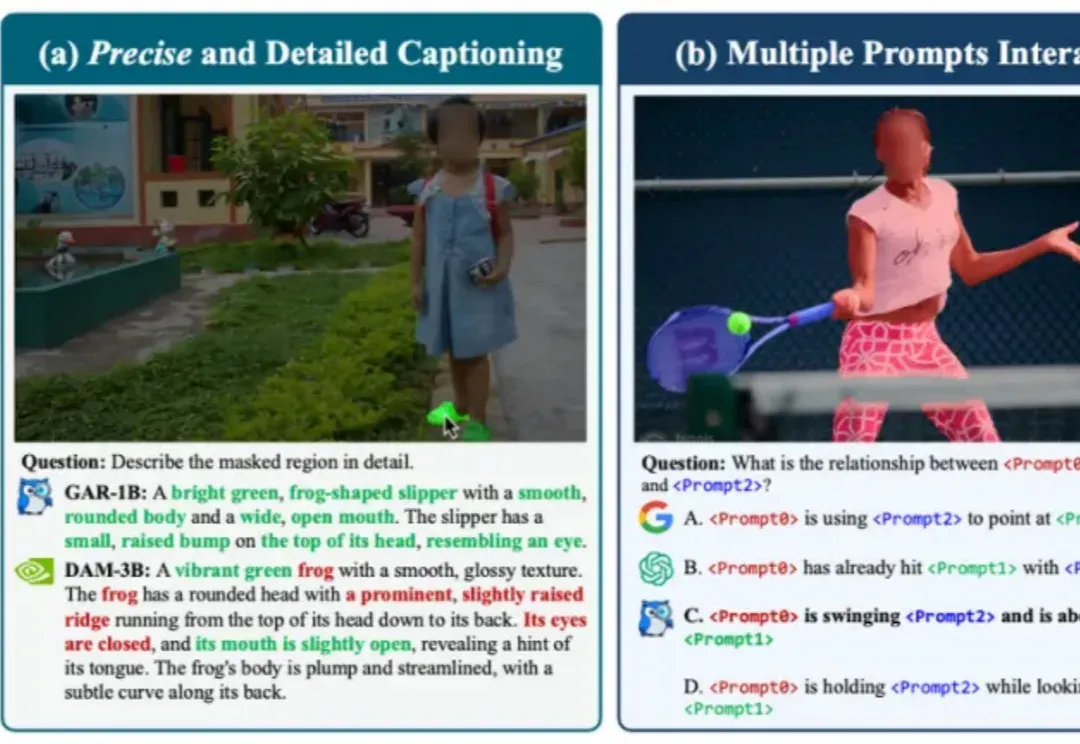
近期,DeepSeek-OCR提出了“Vision as Context Compression”的新思路,然而它主要研究的是通过模型的OCR能力,用图片压缩文档。
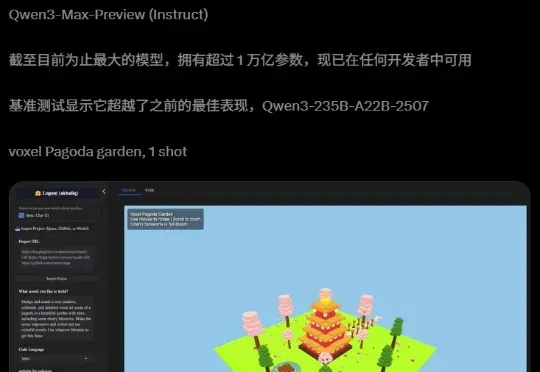
阿里迄今为止,参数最大的模型诞生了!昨夜,Qwen3-Max-Preview(Instruct)官宣上线,超1万亿参数性能爆表。在全球主流权威基准测试中,Qwen3-Max-Preview狂揽非推理模型「C」位,直接碾压Claude-Opus 4(Non-Thinking)、Kimi-K2、DeepSeek-V3.1。