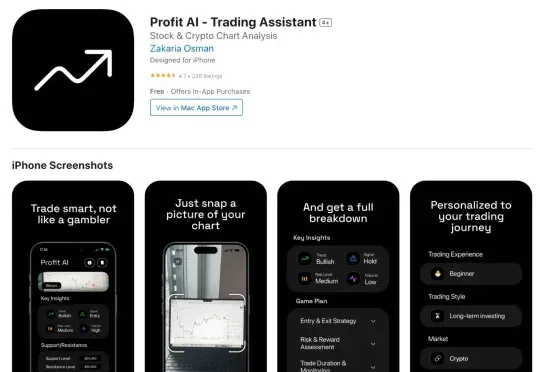
一款复刻Cal AI做金融分析的套壳应用,如何做到月入4万美金(在新窗口打开)
Sebastian 在分析中指出,Profit AI 的核心功能非常简单:用户上传一张股票图表的照片,AI 就会给出分析。他甚至直接展示了这个应用的全部技术:就是调用 ChatGPT API,上传图片,发送提示词,然后返回分析结果。如果你直接用 ChatGPT 做同样的事情,得到的信息几乎一模一样。这个应用唯一做的,就是把这个过程包装得更精美一些,界面更友好一些。
共 160 篇
Sebastian 在分析中指出,Profit AI 的核心功能非常简单:用户上传一张股票图表的照片,AI 就会给出分析。他甚至直接展示了这个应用的全部技术:就是调用 ChatGPT API,上传图片,发送提示词,然后返回分析结果。如果你直接用 ChatGPT 做同样的事情,得到的信息几乎一模一样。这个应用唯一做的,就是把这个过程包装得更精美一些,界面更友好一些。
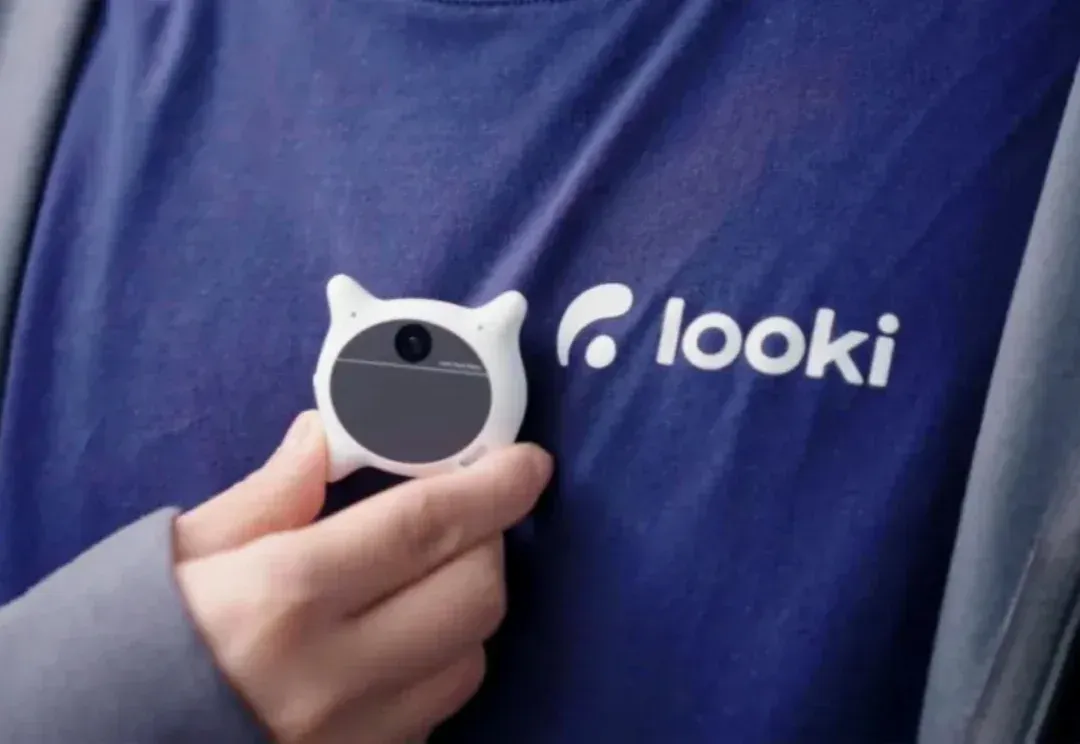
正如奥特曼执意打造硬件,试图打破手机屏束缚,要让 AI 感受物理世界;Looki 的诞生也源于同样的渴望:补齐大模型「感官智能」的最后拼图,将现实场景实时转化为上下文,驱动人机交互从「被动问答」进化为「主动共鸣」。
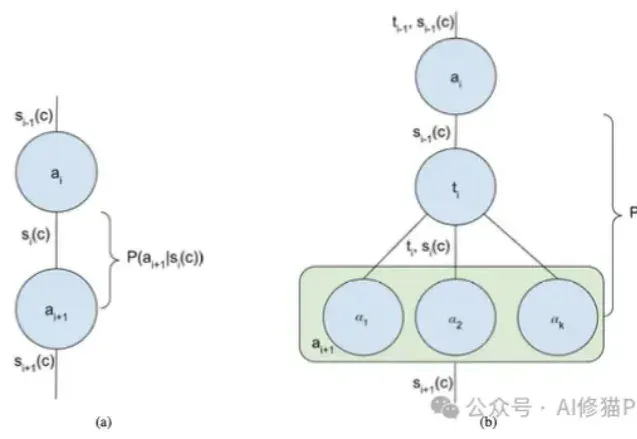
我们正处在一个AI Agent(智能体)爆发的时代。从简单的ReAct循环到复杂的Multi-Agent Swarm(多智能体蜂群),新的架构层出不穷。但在这些眼花缭乱的名词背后,开发者的工作往往更像是一门“玄学”,我们凭直觉调整提示词,凭经验增加Agent的数量,却很难说清楚为什么某个架构在特定任务上表现更好。
就在最近,豆包上新了图像创作模型 Doubao-Seedream-4.5(以下简称 Seedream 4.5)。 猜猜下面两张图片,哪张是 Seedream 4.5 生成的?哪张是最近风头正盛的 Nano Banana Pro 生成的?
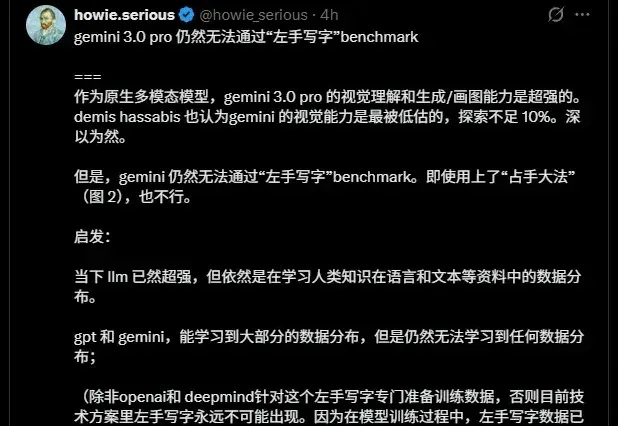
昨天刷到了一条非常有意思的推特。 是我关注的一个博主,Howie.Serious发的。 他发了一个很有趣的点,就是即使是世界上现在最牛逼的NanoBananaPro,在世界知识如此屌爆的情况下,AI,还是没有办法生成左手写字的图片。 这事特别有意思。 我立马用Gemini上的NanoBananPro试了下。 果然翻车了,而且是非常稳定的翻车。 我又直接用Lovart跑了十几种张图,只对了2次,其他的,全错。 我又去试了其他的大模型,包括chatgpt、seedream,grok,也在这个小小的提示词上全军覆没。 刷刷刷给我生成了一堆右手,让我都有点混乱了,我那一瞬间都在怀疑是不是我自己分不清左
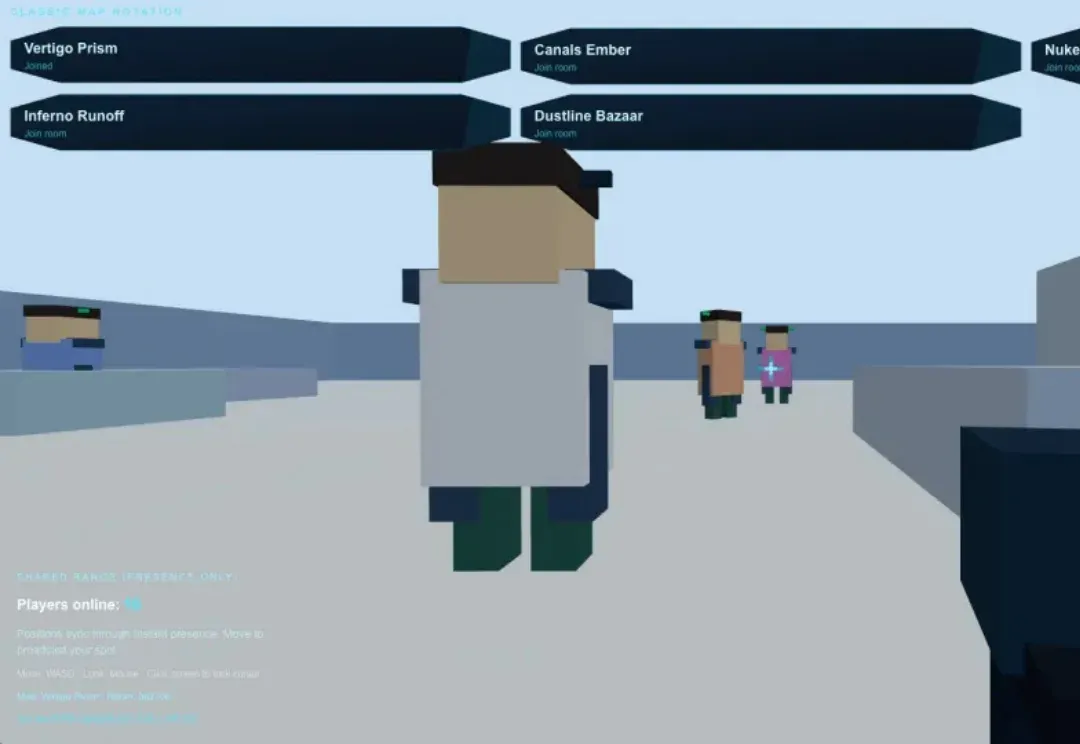
我们距离“一人造一家公司”、亦或者“仅凭自然语言就能开发出一款完整的应用甚至游戏”还有多远?
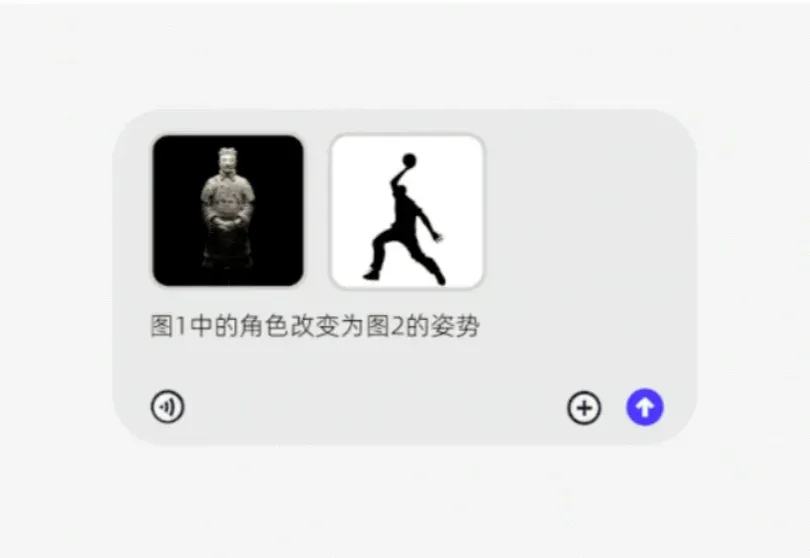
让兵马俑跳 K-Pop 是什么体验? 如果你今天刷到一段视频:一位两千岁高龄的「老人家」兵马俑拿着麦克风,跟着节拍左摇右摆,动作比练习生还丝滑,表情管理比爱豆还到位。 倒也不用慌,这只是 AI 界的又一次整活现场。 而这充满反差感、邪门又好笑的画面,正是出自阿里千问 App 新升级的功能。 基于 Wan2.5 音视频同时输出能力,千问的 AI 玩法又升级了!仅需一张照片+一段提示词,就能生成口型精准、动作丝滑的「边唱边跳」视频,支持最长 10 秒、1080P 输出。 (别急,还有高手,唱跳俱佳的兵马俑男团来了) 而且没有任何限制。无论是真人照片、萌宠、二次元角色,还是文物、卡通形象,千问 Ap
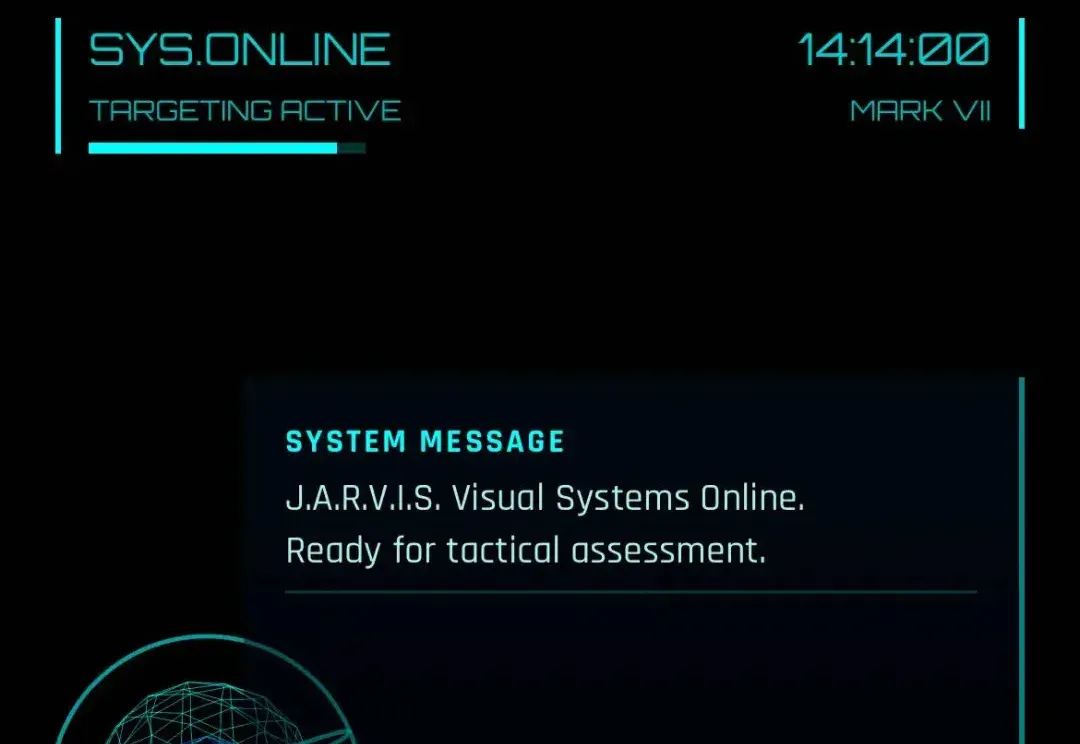
Gemini 3 发布之后这些日子里,我逐渐感到疑惑:为什么总让 AI 写网站写 PPT,Gemini 都发到第三代了,不能干点更有意思的事吗?
如果告诉你,仅仅改变提示词(Prompt)的结构,就能让大模型在复杂推理任务上的表现暴涨 60%,你相信吗?
Google昨天伴随Gemini3.0pro一同发布了他们的AI IDE产品Antigravity《与Gemini 3.0一起发布的AI IDE「Antigravity」究竟有多厉害?》。其震撼性的三位一体全流程Agent体验让无数开发者直呼“Cursor危险了”。