突破单链思考上限,清华团队提出原生「并行思考」scale范式(在新窗口打开)
近年来,大语言模型(LLMs)在复杂推理任务上的能力突飞猛进,这在很大程度上得益于深度思考的策略,即通过增加测试时(test-time)的计算量,让模型生成更长的思维链(Chain-of-Thought)。
共 194 篇
近年来,大语言模型(LLMs)在复杂推理任务上的能力突飞猛进,这在很大程度上得益于深度思考的策略,即通过增加测试时(test-time)的计算量,让模型生成更长的思维链(Chain-of-Thought)。
幻觉不是 bug,是数学上的宿命。 谢菲尔德大学的最新研究证明,大语言模型的幻觉问题在数学上不可避免—— 即使用完美的训练数据也无法根除。 而更为扎心的是,OpenAI 提出的置信度阈值方案虽能减少幻
大模型在科研领域越来越高效了。 昨天,谷歌发表了一篇重磅文章,提出了一个能够帮助科研人员编写「专家级」科研软件的 AI 系统。 该系统融合了大语言模型和传统树搜索,能够自动编写和优化科研任务中所需的软件程序,能够获取多种渠道的现有知识,整合并且重组这些知识来构建一个新的研究思路。 谷歌生成,该系统不仅稳定达到专家水平,还常常超越人类。在基因组学、公共健康、数值分析等多个领域,这套系统的表现甚至超过了顶尖研究团队和国家级集成系统。 论文标题:An AI system to help scientists write expert-level empirical software论文链接:http
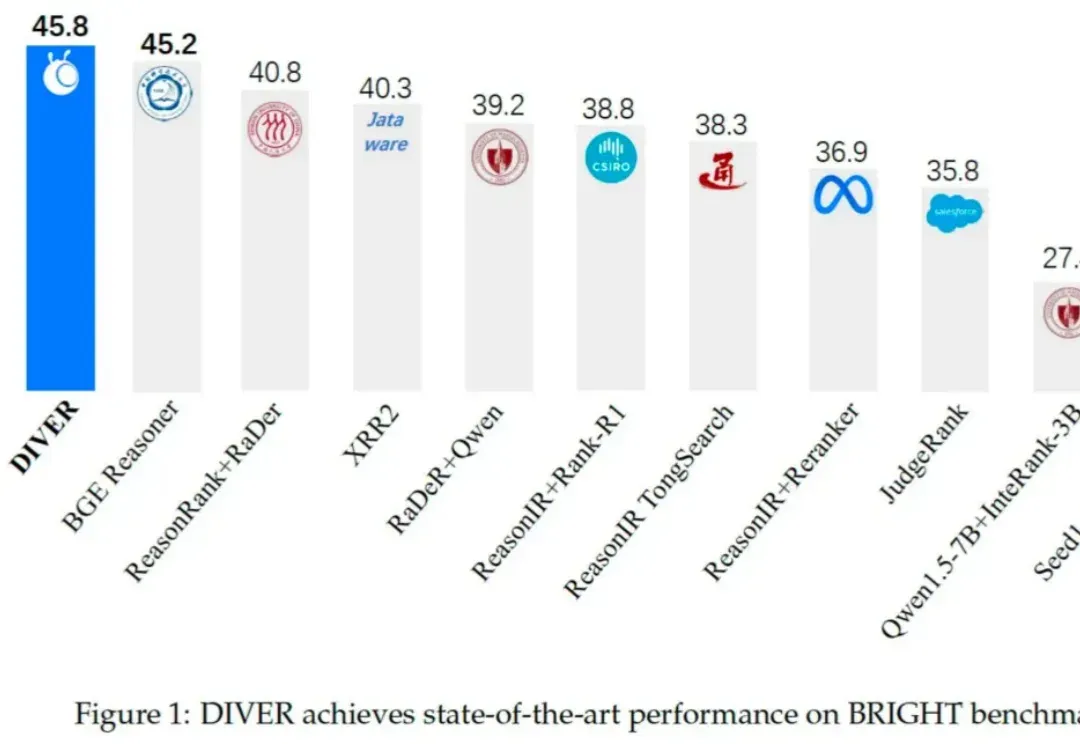
在当前由大语言模型(LLM)驱动的技术范式中,检索增强生成(RAG)已成为提升模型知识能力与缓解「幻觉」的核心技术。然而,现有 RAG 系统在面对需多步逻辑推理任务时仍存在显著局限,具体挑战如下:
过去几年,大语言模型(LLM)的训练大多依赖于基于人类或数据偏好的强化学习(Preference-based Reinforcement Fine-tuning, PBRFT):输入提示、输出文本、获得一个偏好分数。这一范式催生了 GPT-4、Llama-3 等成功的早期大模型,但局限也日益明显:缺乏长期规划、环境交互与持续学习能力。
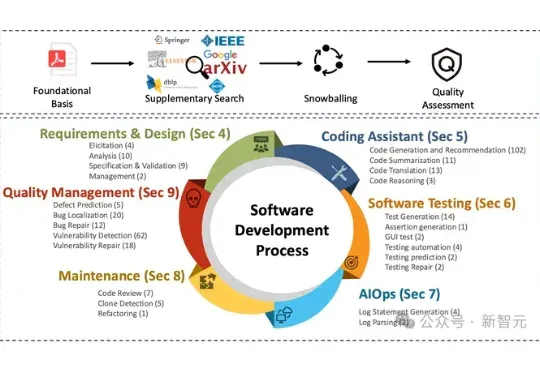
大语言模型正加速重塑软件工程领域的各个环节,从需求分析到代码生成,再到自动化测试,几乎无所不能,但衡量这些模型到底「好不好用」、「好在哪里」、「还有哪些短板」,一直缺乏系统、权威的评估工具。

腾讯三季报显示营收2073.36亿元、资本开支814.33亿元。公司称WorkBuddy日活超1000万,按用户每日大语言模型Token消耗总量居国内首位;报道还讨论云业务增收与AI投入对盈利、现金流的影响。
报道援引不同信源对周畅是否离开 Seed 给出不同说法,并讨论视觉理解并入大语言模型、视觉生成独立研发的组织与技术取舍。相关人事与创业消息仍待公开确认。
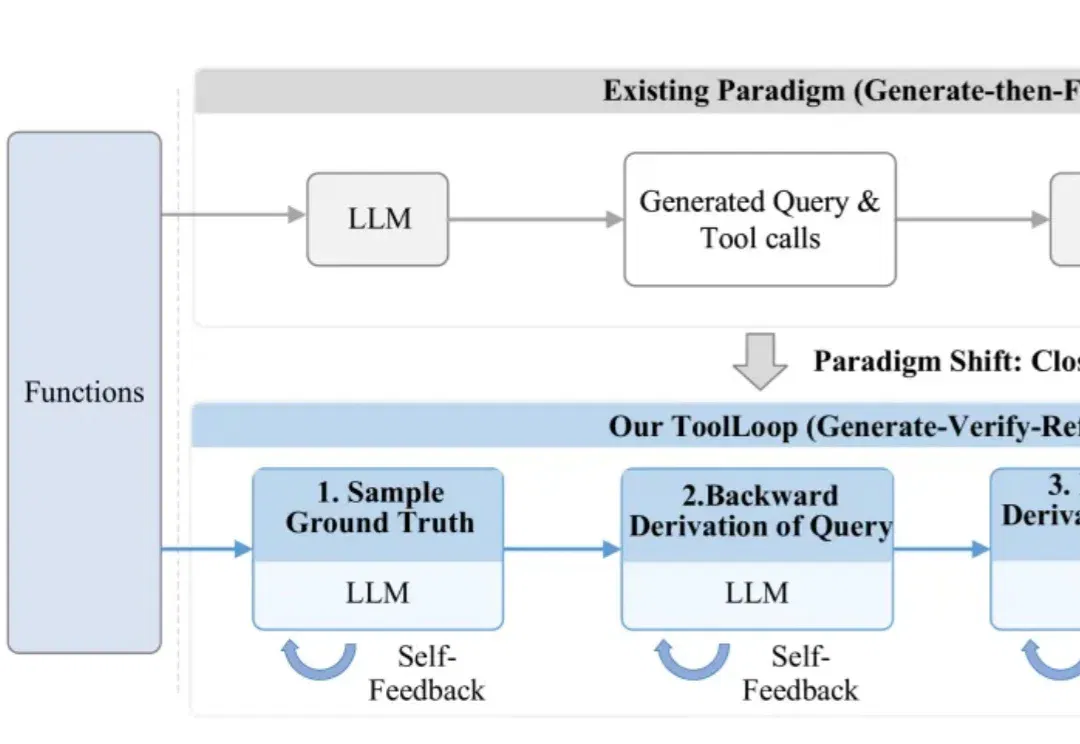
工具调用使大语言模型能够通过外部 API 获取信息、执行操作。训练这类能力,需要建立用户请求与具体函数调用之间的对应关系。一条合格的训练样本,不仅要符合函数定义,还要保证工具选择、调用次数和参数取值与用户意图一致。
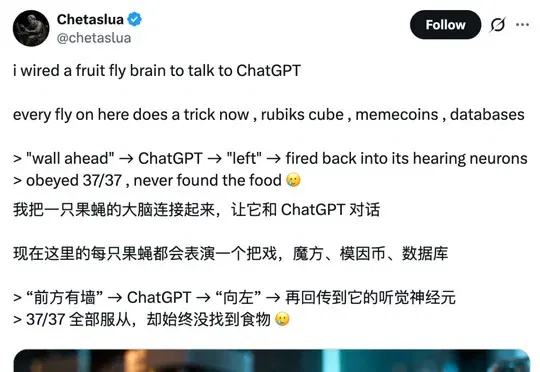
开发者chetaslua在MacBook上用NumPy和MaleCNS连接组数据模拟了13.8万个神经元的果蝇大脑,并将神经放电信号实时翻译成文字直接发送给ChatGPT,实现了生物神经信号与大语言模型的首次对话。